Los simuladores no siguen el ritmo de los sistemas reales
Desplegar un clúster real para dar servicio a modelos de lenguaje grandes es caro y, a menudo, simplemente imposible: no hay hardware, no hay presupuesto, no hay tiempo que esperar. Por eso la simulación de sistemas lleva tiempo siendo una herramienta de trabajo para los investigadores: primero se calcula en el simulador y después se pasa al hardware.
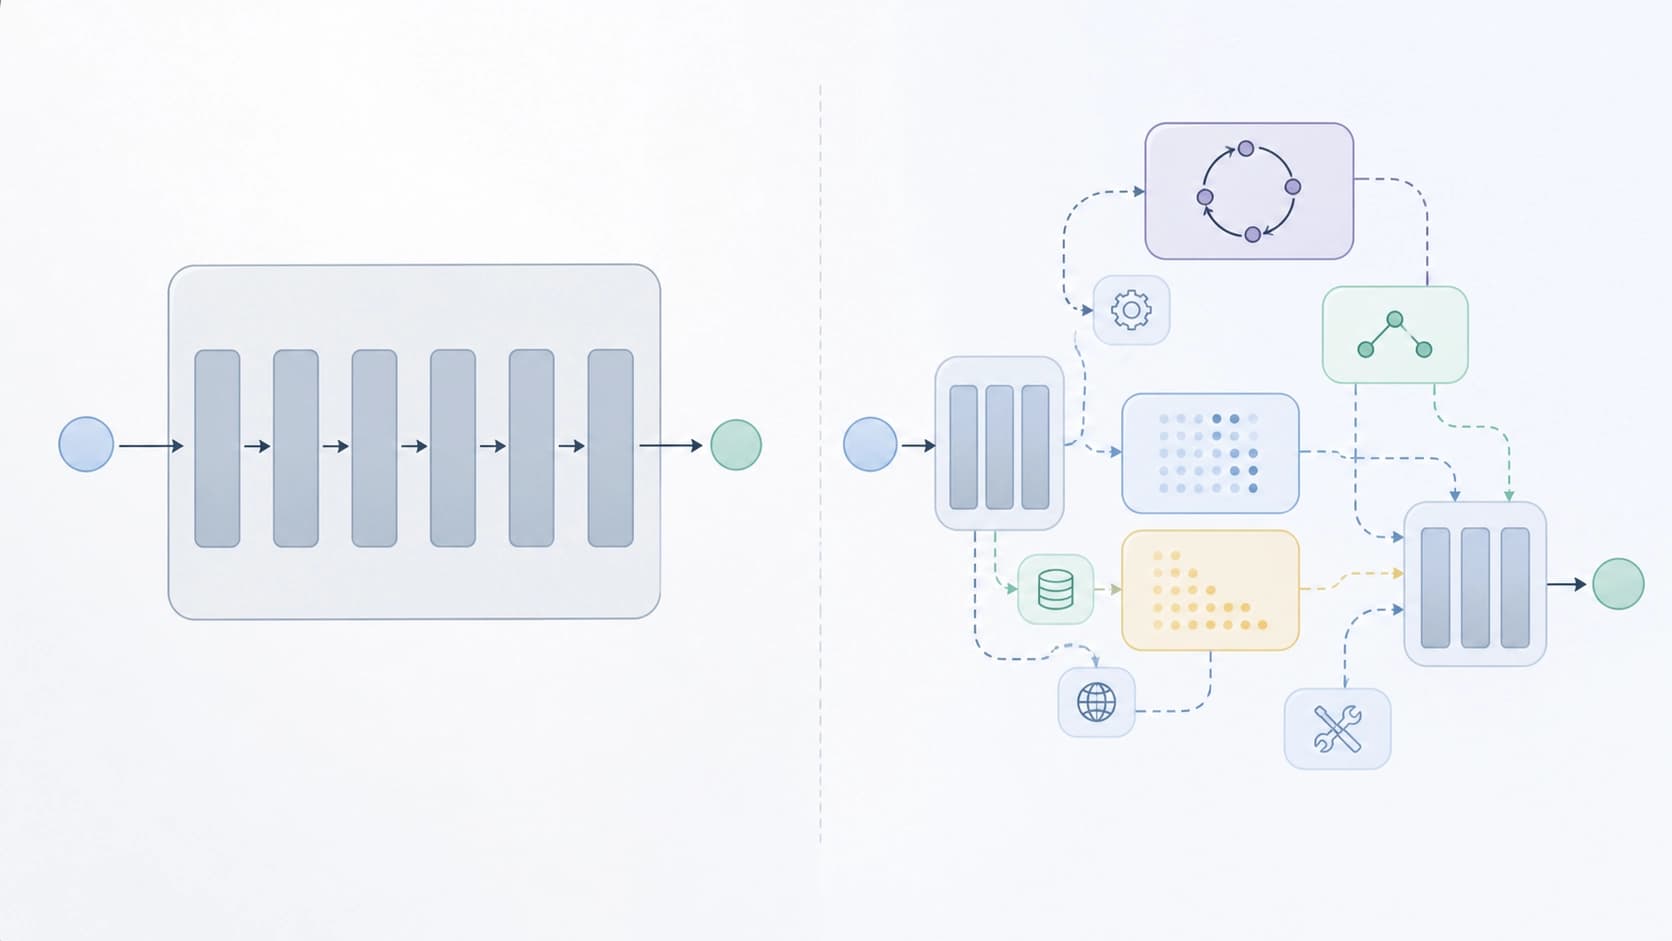
El escollo está en que el propio campo avanza más rápido que el desarrollo de los simuladores. Las nuevas cargas de trabajo —escenarios agénticos, donde el modelo invoca herramientas y opera en bucle, esquemas con fases separadas de prefill y decode— han dejado de encajar en el pipeline monolítico que incorporan los simuladores existentes. Cualquier mecanismo nuevo hay que atornillarlo por un lado mediante una dolorosa reelaboración del núcleo. Como resultado, la brecha entre lo que realmente se ejecuta en producción y lo que un simulador es capaz de reproducir no hace más que crecer.
La idea: un simulador que se amplía a sí mismo
Un equipo de investigadores se propuso resolver este problema: Wonung Kim, Hyunmin Choi, Minsu Kim, Jaehong Cho, Yeongwook Kim y Jongse Park. Su preprint arXiv:2608.24650 (cs.AR, cs.AI) se titula «Simthesizer: An Agent-Driven Simulation Framework for LLM Serving Systems».
El giro principal del planteamiento es el siguiente: no hace falta escribir otro simulador más para un conjunto concreto de mecanismos actuales, pues quedará obsoleto antes de salir. Hay que construir Simthesizer de modo que se amplíe a sí mismo a medida que surjan nuevos requisitos. Y no a manos de un programador que pasa un mes leyendo código ajeno, sino a manos de un agente que entiende el planteamiento en lenguaje natural y sabe trabajar con él dentro del simulador.
Un único grafo dinámico en lugar de un conjunto de módulos
La base técnica de la idea es una infraestructura componible. En Simthesizer todo el proceso de servicio se expresa de forma uniforme: no solo los propios cálculos, sino también las decisiones de control que coordinan ese proceso, es decir, el planificador, el orden de procesamiento, la asignación de recursos. Todo ello se describe como un único grafo dinámico que va cambiando a lo largo de la simulación.
La ventaja práctica es evidente: cuando la nueva funcionalidad no hay que atornillarla a uniones rígidamente cableadas entre subsistemas, sino que basta con añadir un nodo al panorama general, el coste de la extensión cae en órdenes de magnitud. Precisamente aquí surgía antes la «reelaboración invasiva»: toda la lógica estaba repartida por el código y cualquier mecanismo nuevo afectaba a medio simulador.
El agente sintetizador: una petición en palabras, no un fork del código
El segundo elemento es el Synthesizer agent, que los autores describen como un «coding agent bajo riendas» (harnessed coding agent). Su tarea es traducir las peticiones sobre las funciones necesarias, formuladas en lenguaje humano corriente, a esa representación abstracta dentro del simulador.
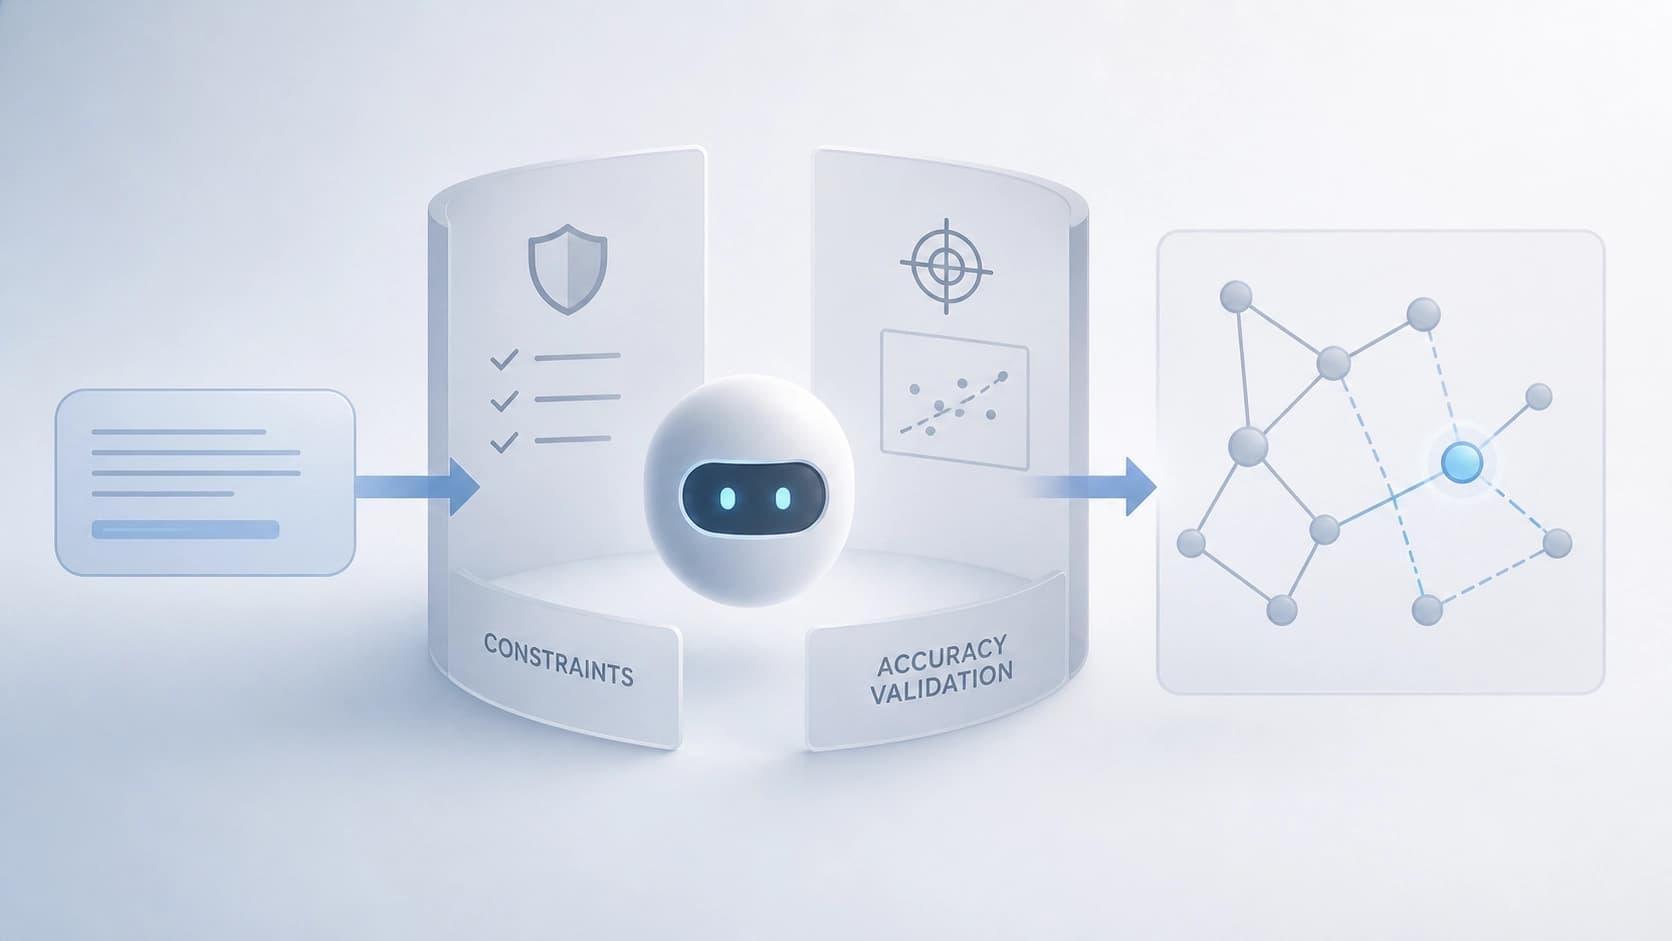
La palabra clave aquí es «bajo riendas». El agente no escribe lo que quiere: trabaja dentro de las restricciones específicas de cada simulador concreto, y su resultado pasa una validación de fidelidad de la simulación (fidelity validation). Sin este paso, la iniciativa se habría convertido en un generador de código verosímil pero incorrecto. Otra detalle importante: el agente desarrolla un único simulador común, en lugar de multiplicar uno nuevo por cada funcionalidad; de lo contrario, habríamos obtenido el mismo zoológico de forks incompatibles, solo que creado automáticamente.
Hasta qué punto funciona
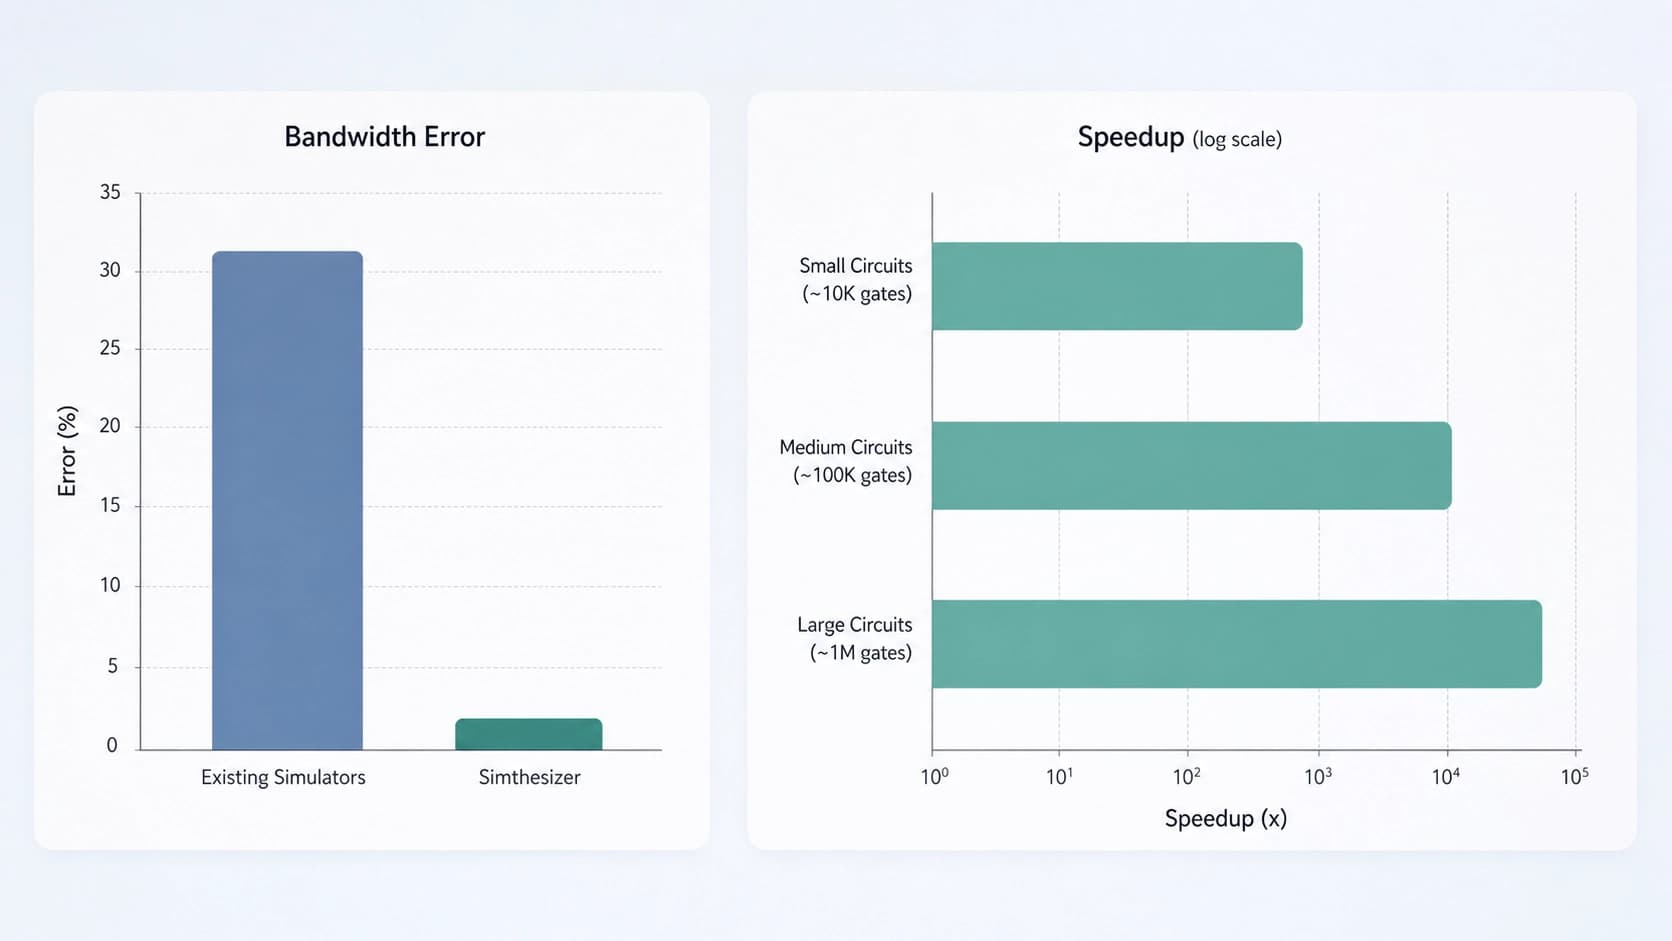
Los autores comprobaron el enfoque no con datos sintéticos, sino comparándolo con la realidad. Las extensiones construidas sobre Simthesizer reproducían un sistema basado en vLLM con un error medio de throughput del 2,51%. En las extensiones sobre simuladores existentes, esa misma métrica es del 6,03%. La diferencia es de más del doble, y además se utilizó el mismo coding agent con el mismo arnés: es decir, la ventaja la aporta precisamente la arquitectura del simulador, y no una elección afortunada del modelo ejecutor.
La velocidad impresiona no menos. En cargas de trabajo idénticas, Simthesizer simulaba hasta 284,96 veces más rápido que LLMServingSim2.0, y hasta 23,19 veces más rápido que Vidur. Tales órdenes de magnitud cambian el propio carácter de la investigación: en lugar de «lanzar una ejecución y esperar», aparece la posibilidad de recorrer decenas de configuraciones y comparar escenarios entre sí.
Qué cambia esto y qué conviene tener presente
Si el enfoque arraiga, el cambio no se producirá solo en las cifras, sino también en el papel de la propia herramienta. El simulador dejará de ser un artefacto congelado que alcanza la realidad con uno o dos años de retraso, y se convertirá en un sistema que se puede adaptar a una nueva tarea en una sola conversación. Para quienes diseñan infraestructura de inference, esto significa un ciclo de verificación de hipótesis más barato: no es obligatorio montar primero un banco de pruebas para entender si la idea saldrá rentable.
Pero también hay preguntas que los autores dejan fuera del análisis. ¿Hasta qué punto la validación de fidelidad detecta de forma fiable los errores sutiles del agente, por ejemplo cuando un nodo nuevo funciona formalmente pero altera de manera imperceptible el comportamiento bajo una determinada combinación de carga y timings? ¿Cómo se traslada el enfoque a cuestiones específicas del hardware, como los aceleradores no estándar? Y, por último, queda abierta la cuestión de la confianza: cuando el simulador se escribe cada vez más a sí mismo, alguien tiene que ser capaz de leer lo que ha salido.
Por ahora, el resultado es simple y comprensible: la combinación de «arquitectura componible más agente con derechos limitados» ofrece una simulación tanto más precisa como notablemente más rápida que los simuladores pulcramente refinados pero rígidos de la generación anterior. Es justo el caso en que lo correcto era cambiar no el modelo, sino el diseño de la herramienta.