
MAPLE: transferencia de presupuesto de expertos enrutables entre capas de un modelo MoE sin modificar los pesos
El trabajo muestra que un número uniforme de expertos enrutados para todas las capas pierde sistemáticamente frente a una distribución desigual, y propone un mecanismo conectable basado en la evaluación de la sensibilidad de las capas. En cuatro modelos MoE, el enfoque con un 75% del presupuesto de expertos supera tanto al esquema uniforme como al recorte de expertos, y en SGLang reduce la latencia de servicio en un 32,2% y aumenta el rendimiento en un 47,4%.
Problema del presupuesto uniforme de expertos
Los transformadores MoE con activación dispersa fijan el mismo número de expertos enrutados en todas las capas. Esto ignora la heterogeneidad documentada de redundancia entre capas.
MAPLE es un framework plug-and-play. Redistribuye el presupuesto de expertos enrutados entre las capas de cualquier MoE LLM preentrenada. El método no modifica los pesos ni requiere reentrenamiento.
Propiedades clave:
- Distribución heterogénea del presupuesto por capas.
- Sin modificación de los pesos del modelo.
- Sin reentrenamiento.
- Aplicabilidad a una MoE LLM preentrenada.
Criterio práctico: el enfoque es necesario cuando se requiere cambiar la distribución de expertos sin modificar los pesos ni reentrenar.
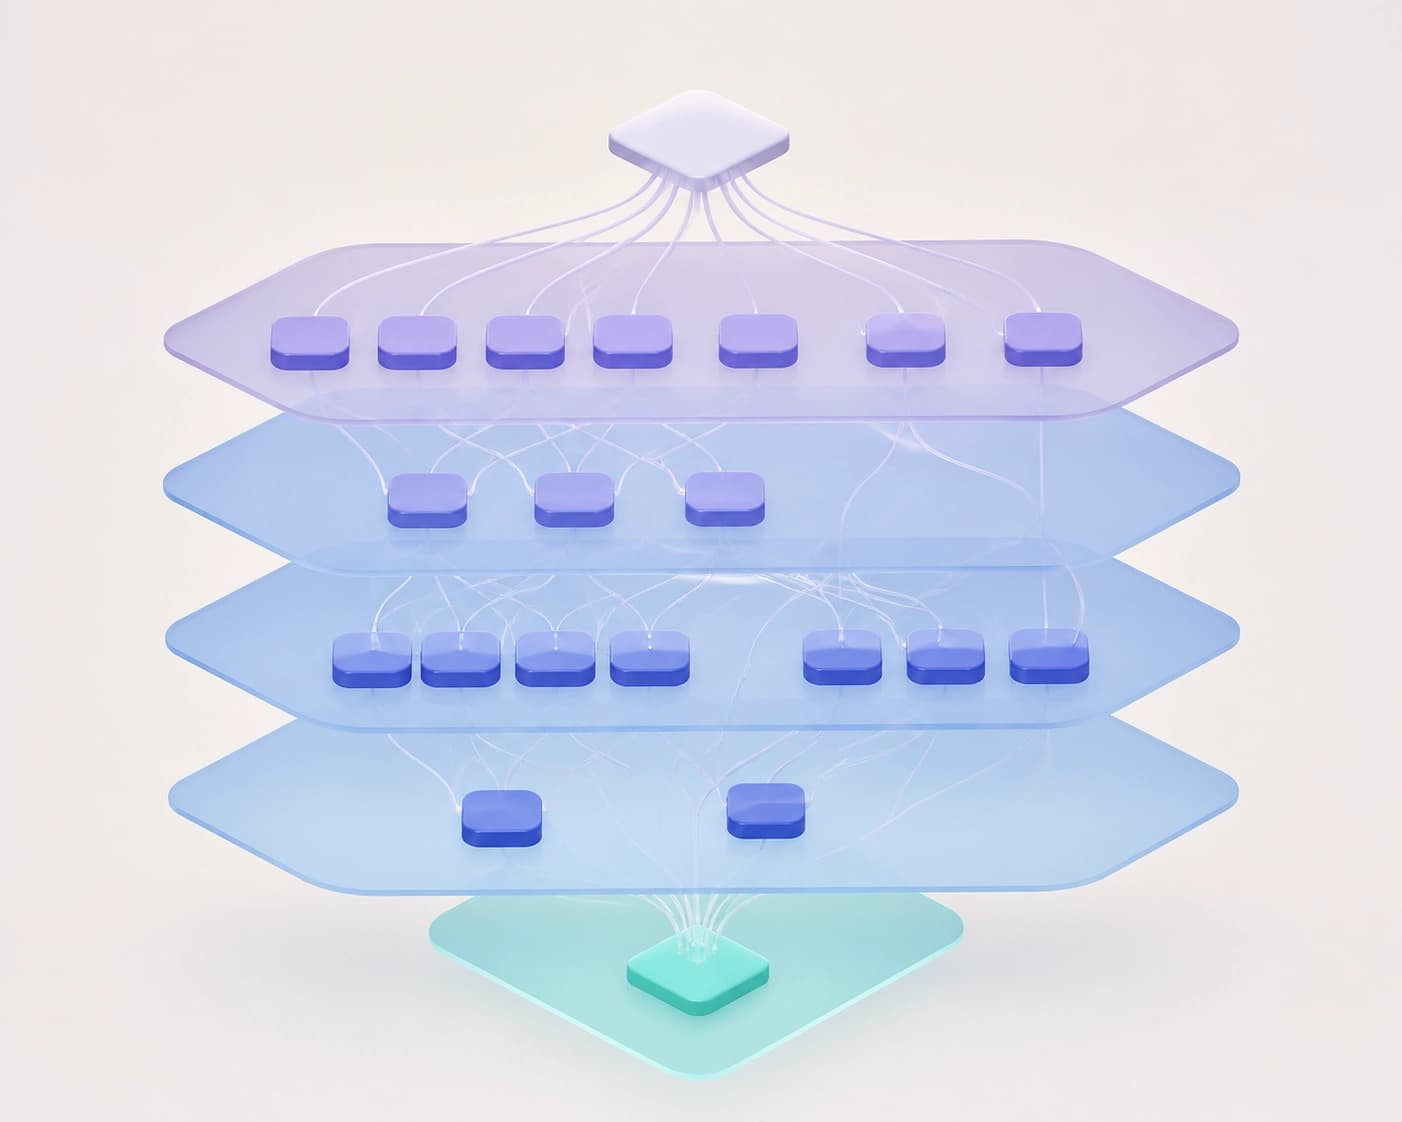
Sensibilidad de las capas y fórmula cerrada
MAPLE sondea cada capa. El método verifica la reacción de la capa al cambio en el número de expertos. La sensibilidad se cuantifica con tres medidas.
Etapas de la transferencia de presupuesto:
- Sondeo de cada capa.
- Evaluación de la reacción al cambio en el número de expertos.
- Cuantificación de la sensibilidad con tres medidas.
- Derivación de la distribución de presupuesto analíticamente óptima.
- Refinamiento mediante búsqueda genética con restricción por sensibilidad.
La distribución analítica dirige la capacidad hacia las capas sensibles. En las capas redundantes, la reducción del presupuesto se absorbe. La búsqueda genética utiliza la sensibilidad por capa como prior. Esto da una convergencia más rápida y una mejor calidad de distribución.
Conclusión: la transferencia de presupuesto se basa en la sensibilidad medible, no en una regla uniforme.
Comparación con enfoques uniformes y basados en pruning
MAPLE supera a los baselines uniformes y basados en pruning en cuatro modelos MoE de diferente escala y arquitectura. La comparación se realiza con un presupuesto del 75% de expertos enrutados.
| Variante | Presupuesto de expertos enrutados | Resultado |
|---|---|---|
| Baseline uniforme | 75% | Inferior a MAPLE |
| Baseline basado en pruning | 75% | Inferior a MAPLE |
| MAPLE | 75% | Superior a ambos baselines |
| Baseline uniforme | 100% | Inferior a MAPLE con 75% en DeepSeek-MoE-16B en ARC-E, ARC-C y BoolQ |
En DeepSeek-MoE-16B, MAPLE utiliza solo el 75% de los expertos. Aun así, supera al baseline uniforme original del 100% en ARC-E, ARC-C y BoolQ.
Aumento de precisión:
- ARC-E: de 65,09 a 71,40.
- ARC-C: de 48,49 a 51,50.
- BoolQ: de 80,03 a 82,38.
Conclusión: la distribución heterogénea puede ser más eficaz que simplemente activar un mayor número de expertos.
Eficiencia en el servicio con SGLang
La implementación de MAPLE en SGLang reduce la latencia end-to-end del servicio en una sola GPU en un 32,2%. El rendimiento aumenta un 47,4%.
El método no modifica los pesos. Por lo tanto, puede integrarse en el stack de servicio MoE existente. Esto convierte la transferencia de presupuesto en una palanca práctica para la inferencia.
Criterio práctico: para el servicio en una sola GPU a través de SGLang, el método ofrece reducción de latencia y aumento del rendimiento.
Criterios de selección
MAPLE vale la pena considerarlo en varios casos:
- Se necesita reducir el presupuesto de expertos enrutados sin reentrenamiento.
- El modelo es una MoE LLM preentrenada.
- Se requiere tener en cuenta la heterogeneidad por capa, en lugar de una regla uniforme.
- Se necesita aumentar la eficiencia de inferencia de MoE.
Conclusión: la distribución heterogénea de expertos se convierte en un eje tanto teórico como práctico para aumentar la eficiencia de MoE.
Preguntas frecuentes
Material similar
Todos los materiales
Verificación de alucinaciones de LLM mediante una vista SQL de las fuentes, sin reentrenamiento
El estudio evalúa si un LLM puede aprovechar una habilidad simbólica básica —crear una base de datos SQL a partir de documentos fuente— para fundamentar sus respuestas en las fuentes sin supervisión al detectar alucinaciones. En RAGTruth y DiaHalu, este flujo de trabajo neuro-simbólico resulta más preciso que la predicción directa y comparable a los métodos más avanzados, sin requerir un ajuste fino al dominio.
9 noviembre 2026
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026
AffordanceWAM: las affordances como intermediarias entre la predicción de la escena y el control del manipulador
El trabajo describe un modelo generativo que predice simultáneamente futuras observaciones RGB, campos escalares, mapas de calor de affordances y comandos continuos para el robot, utilizando videos de personas para ampliar la diversidad de interacciones sin anotaciones de acciones ni retargeting. En RoboCasa, CALVIN ABC→D y tareas reales, el enfoque ofrece mejoras consistentes frente a las líneas de base que utilizan solo RGB o solo datos robóticos.
9 noviembre 2026