Investigaciones prolongadas: el problema no está en una sola consulta
Un investigador autónomo vive en una realidad diferente a la de un agente de chat común. Necesita formular una hipótesis, verificarla, encontrar un error, reescribir el script, ejecutar un experimento y, a veces, volver a una versión anterior del modelo. Este ciclo puede llevar horas, y el valor de cada paso solo se comprende al final.
Con la mayoría de los agentes de autorresearch, esto es difícil. Casi no existen mecanismos de continuidad: si un experimento llega a un callejón sin salida, el agente no sabe cómo recuperar el hilo perdido. Tampoco hay una función para redistribuir la computación según lo útil que sea el resultado actual. Como consecuencia, la búsqueda se vuelve difusa, los recursos computacionales se desperdician y la probabilidad de llevar el trabajo hasta el final disminuye.
Cómo está estructurado el nuevo enfoque
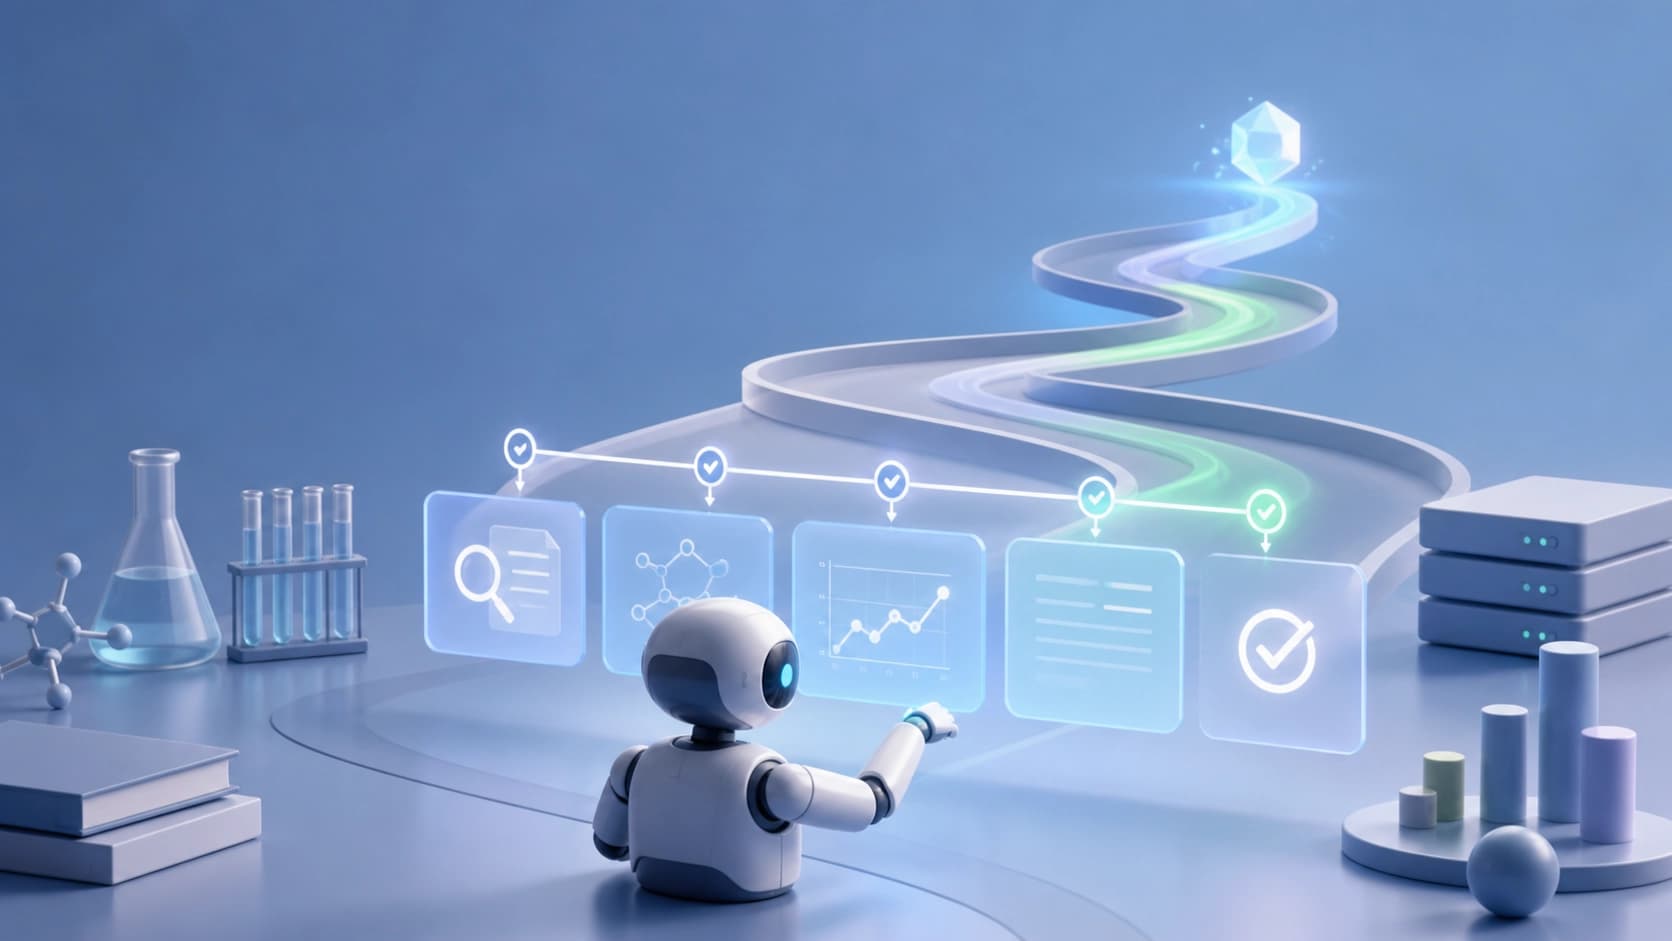
El framework ScienceFlow resuelve precisamente estos problemas. Sus autores, un equipo de 19 investigadores, presentaron una arquitectura de extremo a extremo para experimentos científicos autónomos. El agente no actúa «con un solo prompt»: construye una larga trayectoria de investigación.
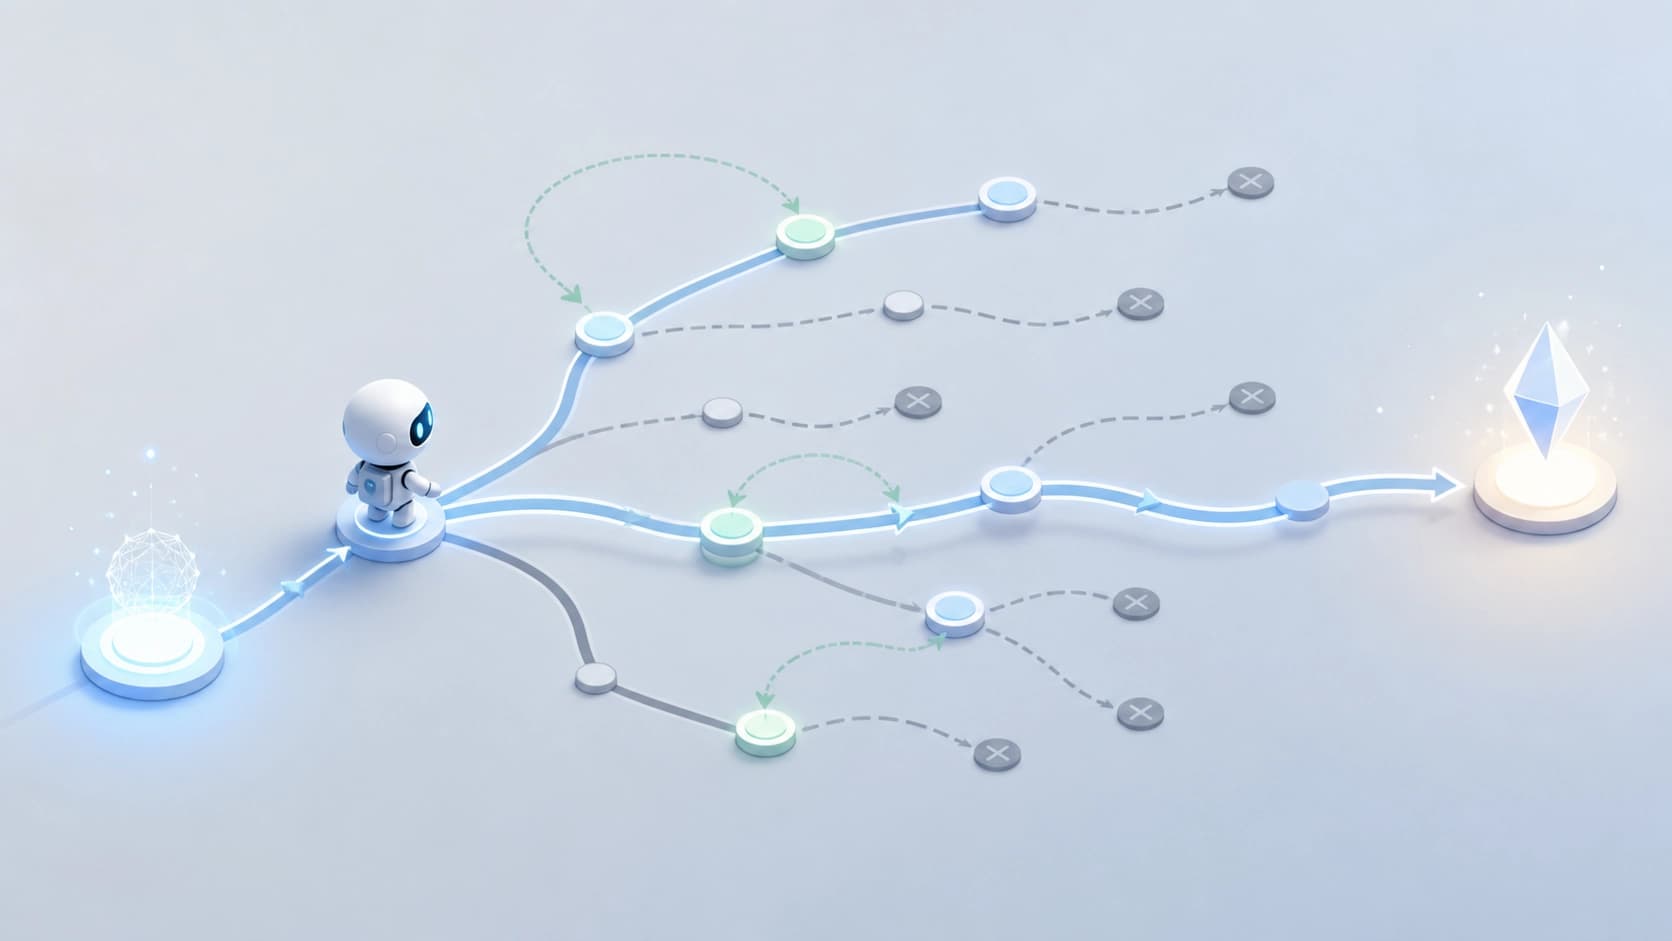
Internamente, el trabajo se divide en segmentos de investigación. Cada segmento está vinculado a un espacio de trabajo ejecutable: allí residen los scripts, los datos y el entorno. El progreso de la investigación no son notas de texto dispersas, sino un estado ejecutable recuperable. Este estado se puede «levantar» desde el disco, reinvestigar, reensamblar y volver a ejecutar. Gracias a esto, el agente puede regresar fácilmente a un punto anterior y probar otra rama, en lugar de empezar todo de nuevo.
ESTRA: cómo elegir la siguiente bifurcación
El detalle clave es la transición entre estados mediante el mecanismo ESTRA (Executable-State Transition through Re-Anchoring). En cada paso, el agente observa dos tipos de estados: los vivos, donde puede continuar de inmediato, y los archivados, que ya han conducido a ciertos resultados. Pero no elige simplemente un nuevo punto, sino un ancla para el movimiento posterior. Luego determina el escenario: continuar desde ese estado o redirigir la investigación en otra dirección.
Este enfoque elimina el principal problema de los experimentos largos: el efecto del agente «atascado», que sigue profundizando en una rama sin futuro porque no sabe cómo retroceder.
Controlador de ejecución con evaluación de resultados
Otra capa del framework es el controlador con evaluación de resultados confirmados. Distribuye los recursos entre las distintas tareas computacionales basándose en tres factores: disponibilidad de capacidad, presupuesto restante y progreso ya confirmado. Si una dirección deja de producir resultados medibles, el controlador puede reducir su parte y redirigir los recursos hacia donde el avance es realmente visible. No es un planificador de tareas «codicioso», sino una forma de mantener la estrategia general dentro del objetivo.
Qué mostraron las pruebas
En las pruebas, el framework cubrió no solo el aprendizaje automático clásico, sino también el modelado científico y la optimización matemática. Los resultados obtenidos indican que el sistema es capaz de llevar a cabo sesiones de investigación prolongadas de manera productiva, sin convertirlas en una interminable sucesión de pasos inconexos.
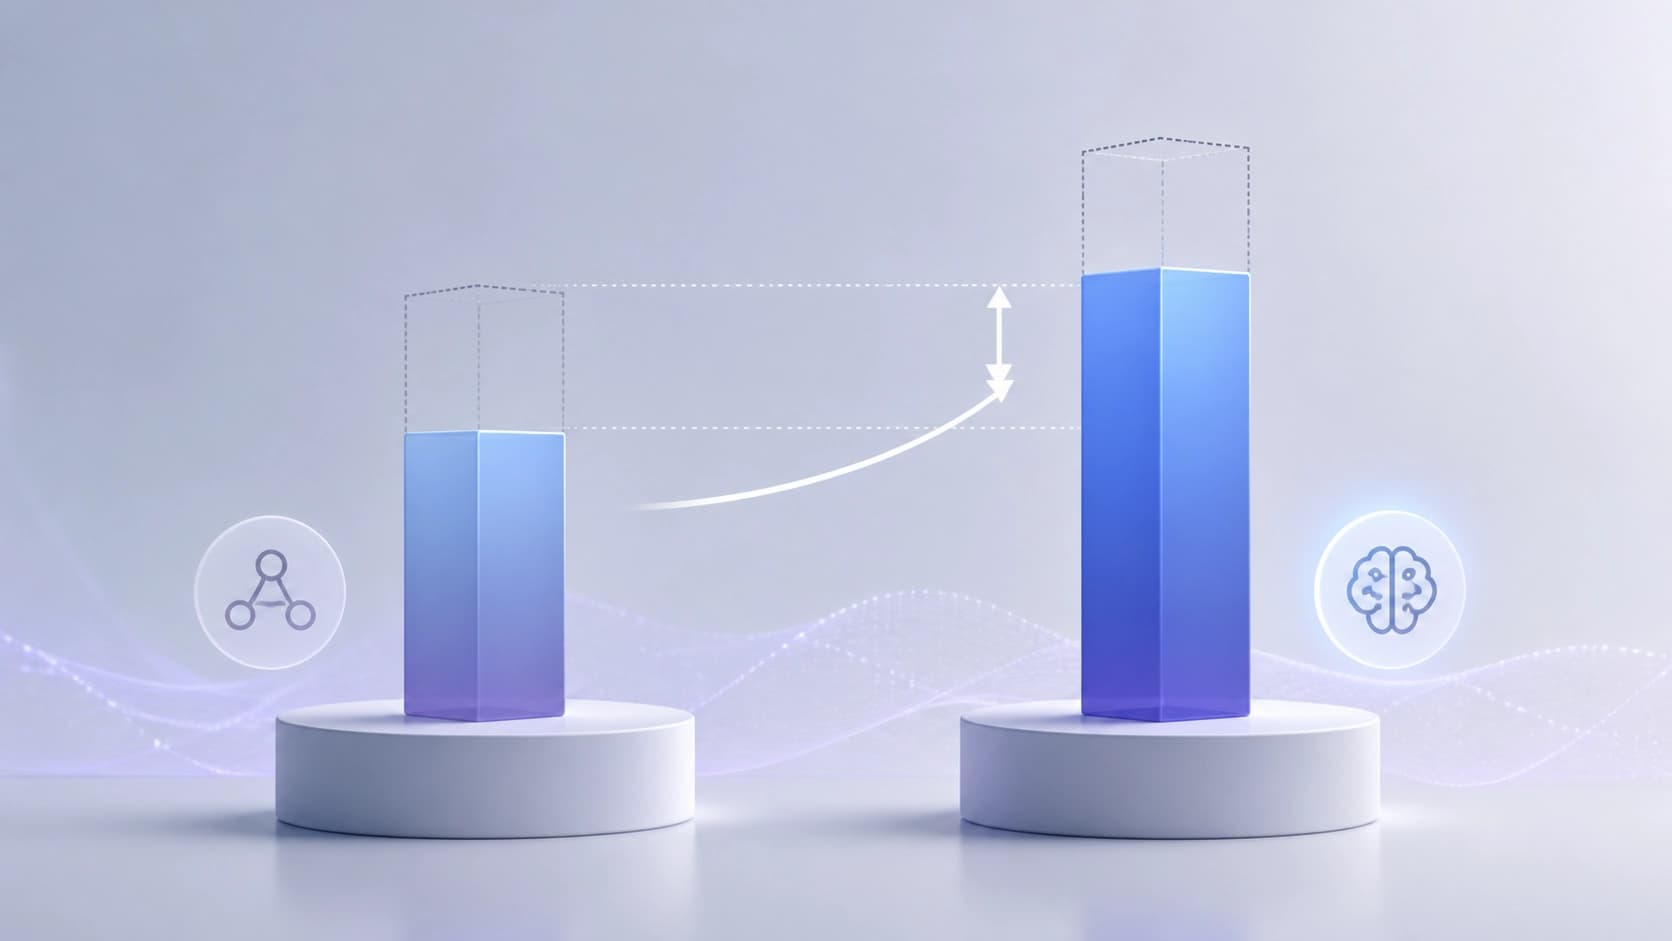
El resultado más destacado es en el MLE-bench completo dentro de un presupuesto de 24 horas: 70,22% en la métrica Any-Medal. Esto es 4,92 puntos porcentuales más que los resultados publicados anteriormente. Dado que MLE-bench evalúa escenarios reales de aprendizaje automático, es una señal contundente: la robustez del proceso a veces importa más que la inteligencia inicial del modelo.
Qué significa esto para la ciencia autónoma
Los autores del artículo formulan una conclusión importante: para escalar la investigación autónoma, son decisivos la gestión del estado, la exploración adaptativa y la ejecución alineada con el objetivo. La mera capacidad de razonar elegantemente no basta: se necesita una infraestructura que impida que el agente pierda los logros anteriores y que le ayude a cambiar de rumbo a tiempo.
Parece ser el siguiente paso de los asistentes basados en LLM hacia verdaderos sistemas de investigación autónomos. El trabajo en un horizonte largo deja de ser un «diálogo corto con el modelo» y se convierte en un problema de ingeniería: cómo construir un proceso en el que cada versión del experimento permanezca accesible, cada resultado se verifique y cada paso siguiente se derive del progreso confirmado.