
Por qué el formato de presentación no es un detalle de implementación
Cuando evaluamos la memoria de un modelo de lenguaje o la calidad de un pipeline RAG, normalmente nos interesa exactamente una cosa: si el modelo llegó al dato correcto. Y la forma en que ese dato apareció en el contexto de entrada —una entrada de memoria independiente, un resumen comprimido, un registro estructurado con campos o un fragmento crudo de conversación— se suele considerar un asunto interno del sistema. La lógica es simple: si el dato está, no importa cómo esté empaquetado.
Los autores del preprint arXiv:2608.23568 proponen no estar de acuerdo con esto. Su trabajo «RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation» (Yuan Si, Simeng Han, Daming Li, Jialu Zhang; v1 del 5 de junio de 2026) ataca la propia idea de que la memoria tenga una única evaluación honesta y universal. En su lugar, proponen medirla igual que se miden otras propiedades sensibles a la configuración: fijar una variable y recorrer los valores de la otra.
Qué controla exactamente RENDER
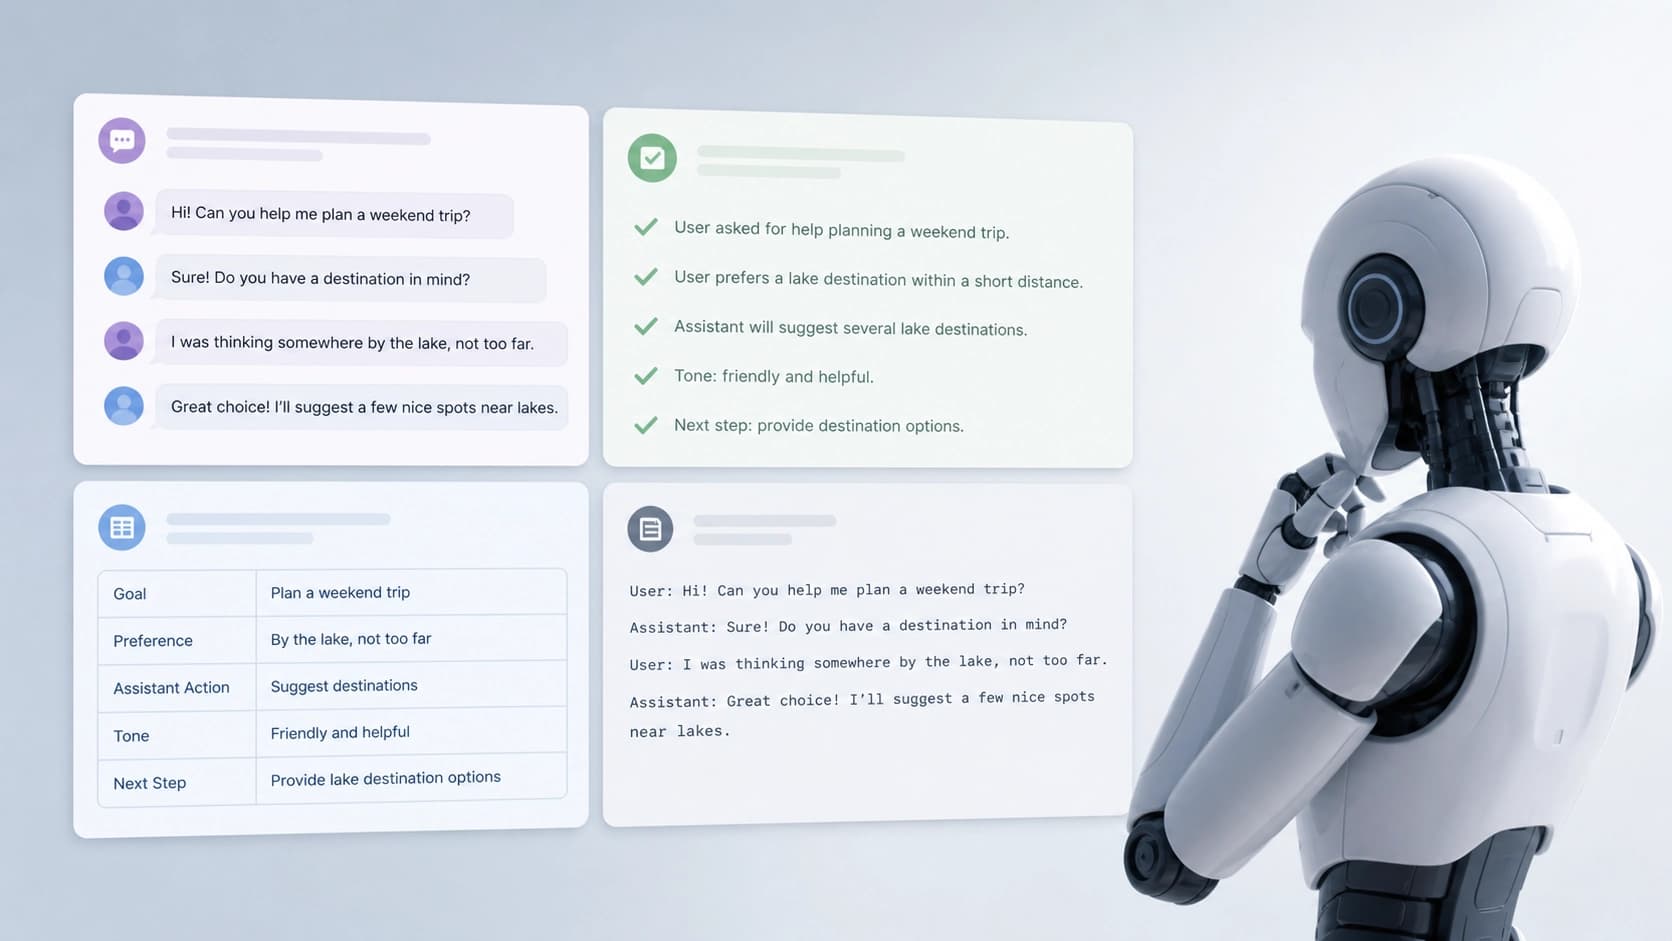
El diálogo no cambia. Solo cambia el artefacto orientado al lector: lo que el modelo respondedor ve realmente ante sí. Es precisamente esta capa —reader-facing artifact— la que RENDER convierte en variable controlable.
Una escalera de cinco niveles
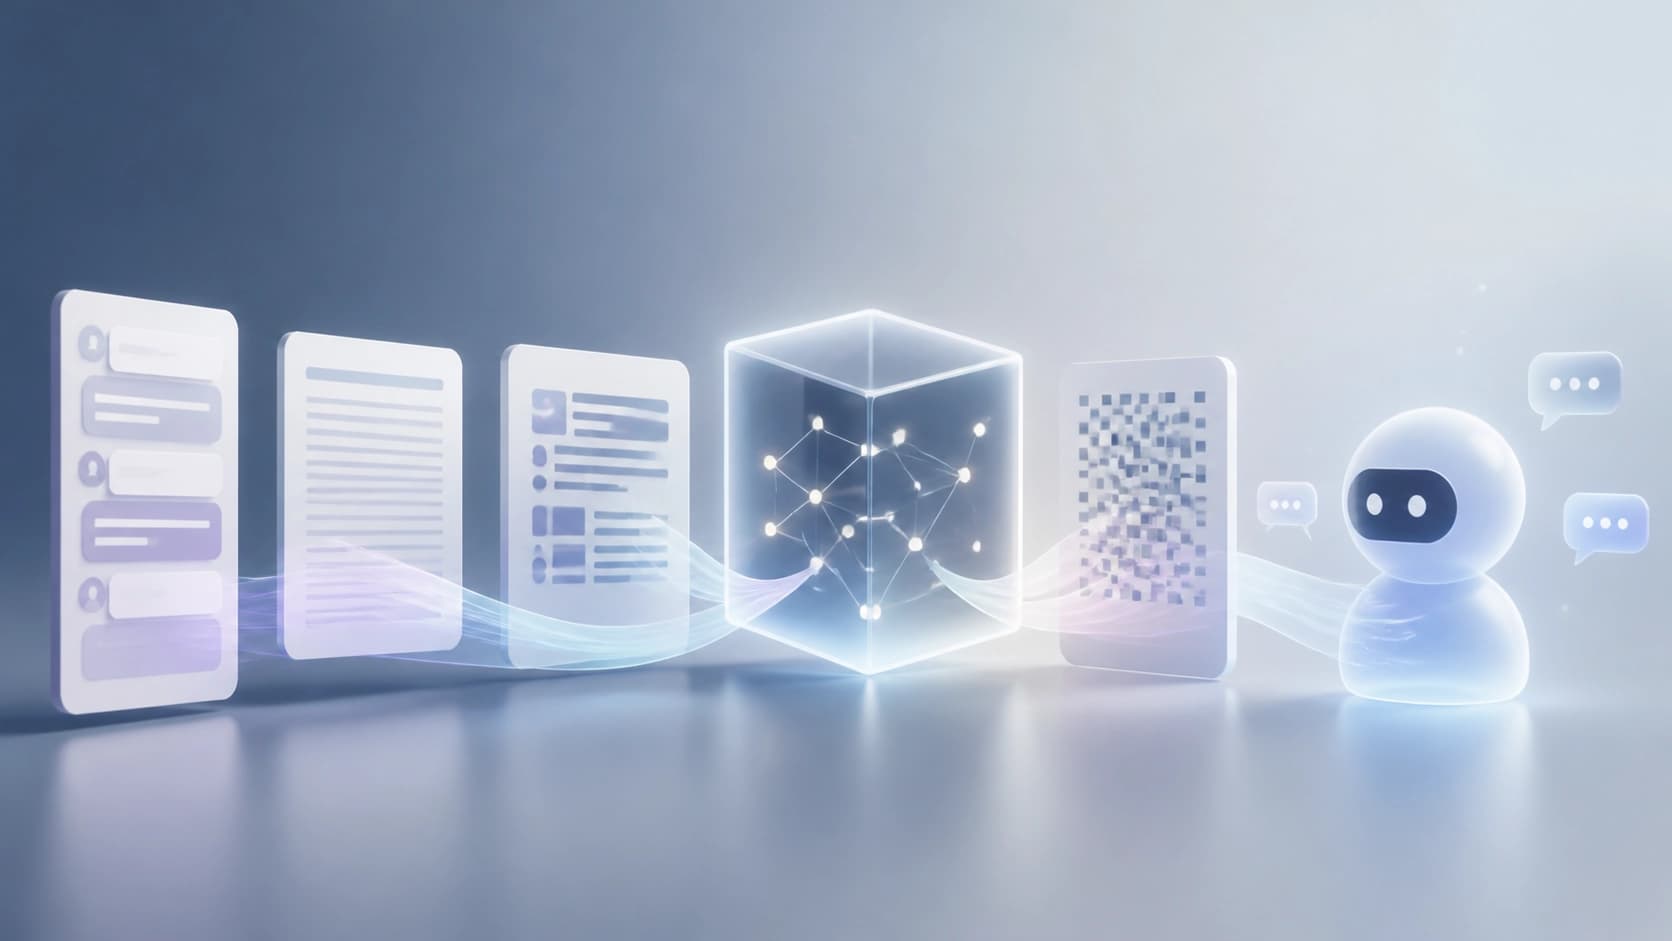
El núcleo de la metodología es la five-level packet ladder. No es simplemente un conjunto de formatos, sino una escala que localiza el momento en que el contenido que sustenta la respuesta entra en la entrada del modelo que responde. La idea es separar dos fallos fundamentalmente distintos: el sistema no encontró el dato necesario y el sistema lo encontró, pero no logró transmitirlo en una forma utilizable. Sin esa escala, estos casos se funden en una sola línea del informe y a partir de ahí empiezan las conclusiones erróneas —por ejemplo, que el modelo «recuerda mal», cuando en realidad simplemente no descifró el empaquetado.
Cuatro plantillas de presentación
El segundo elemento son plantillas deterministas que aproximan las formas típicas de mostrar el historial al usuario. Son cuatro:
- entradas al estilo ChatGPT — bloques cuidados, similares a lo que una persona ve en la interfaz de un chatbot;
- resúmenes al estilo LangChain — recuentos comprimidos que pierden las formulaciones, pero conservan la esencia;
- registros tipados al estilo MemGPT — estructura con campos y categorías, cómoda para el procesamiento automático;
- diálogo crudo — intervenciones tal cual, sin marcado ni reempaquetado.
Las plantillas son deterministas: la misma entrada produce cada vez el mismo texto. Esto es importante, porque de lo contrario no se podría distinguir el efecto del formato de la dispersión aleatoria de la generación.
Qué mostraron los números
El experimento se apoya en 500 preguntas de LongMemEval y nueve modelos. Aquí conviene detenerse: no es una sola ejecución ni una sola pasada en busca de una cifra bonita, sino una malla «modelo × formato de presentación», que es lo que permite ver el efecto.
El resultado principal: los matched-budget resolved packets superan al recency-truncated raw dialogue en 42.4–72.6 puntos. En otras palabras, si se llevan los formatos a un presupuesto comparable y se le da al modelo contenido que realmente sustenta la respuesta, la brecha con la forma de presentación más ingenua —el diálogo crudo recortado por recencia— resulta no cosmética, sino abismal.
En las plantillas deployed-style el panorama es más suave, pero igualmente grande: la dispersión entre el mejor y el peor formato es de 24.6–48.8 puntos para cada uno de los nueve modelos. Es decir, dentro de un mismo modelo, con las mismas preguntas y el mismo presupuesto, se pueden «perder» o «ganar» decenas de puntos simplemente por cómo se ve la evidencia.
Otro detalle del scoring primario: en 7 de 9 modelos, las entradas al estilo ChatGPT obtienen puntuaciones puntuales más altas que el diálogo crudo. Esta es, quizá, la conclusión más incómoda para quienes construyen métricas sobre el historial de conversación «puro».
El juez tampoco es la verdad absoluta
Un apartado propio es qué ocurre si las evaluaciones se recalculan no con un scorer automático, sino con un juez-modelo (judge rescoring). El efecto positivo agregado del formato se mantiene, pero la significancia por modelos individuales se vuelve mixta. Dicho de forma sencilla: la tendencia a nivel de toda la muestra no desaparece, pero las afirmaciones puntuales del tipo «el modelo X gana precisamente gracias al formato Y» ya no son tan fiables tras el rejuicio.
Esto no es motivo para renunciar a los jueces LLM, pero sí un buen recordatorio: cualquier evaluación de memoria es en sí misma un instrumento de medición con su propia sensibilidad al formato de entrada. Y si el sistema y el juez reaccionan de manera distinta al empaquetado de la evidencia, la diferencia puede diluirse en ruido o, al contrario, convertirse en una señal falsa.
El resultado más ilustrativo: cero contra cincuenta
Si hay que quedarse con una sola cifra del artículo, es esta. Tres modelos que mostraron un 0 % en formal ledger packets respondieron a los mismos datos desde natural-language entries con una precisión del 45.4–53.4 %.
No es «un poco mejor», no es «dentro del margen de error»: de un cero absoluto a acertar con seguridad en la mitad de los casos con contenido idéntico. Una brecha así es difícil de explicar por falta de conocimiento del modelo o por una mala búsqueda: los datos estaban ahí, solo cambiaba la forma de presentarlos. Un registro formal y legible por máquina resultaba de algún modo infranqueable para el modelo, mientras que esa misma información expuesta en lenguaje natural se leía sin problemas.
Para un ingeniero, esto es una señal práctica: si tu pipeline guarda la memoria en bloques estructurados estrictos, puedes estar subestimando sistemáticamente las capacidades del modelo —y, al mismo tiempo, sobreestimando el beneficio de la formalización.
Hasta qué punto es estable
El efecto no se desmorona al complicar las condiciones: se mantiene bajo retrieval noise, es decir, cuando se mezclan fragmentos sobrantes en el contexto. Además, se traslada a HotpotQA —otro conjunto de datos construido en torno a preguntas de varios pasos. Esto es importante, porque disipa la sospecha de que todo se deba a las particularidades de un único benchmark de memoria larga.
Las limitaciones también conviene tenerlas presentes: las plantillas aproximan las formas reales de presentación, no las reproducen literalmente, y las conclusiones sobre modelos concretos tras el rejuicio son mixtas. Así que no se trata de recetas listas, sino de la necesidad de siquiera notar esta variable.
Qué hacer con esto en la práctica
La conclusión de los autores es bastante directa: los informes de evaluación de memory/RAG deben o bien indicar qué artefacto reader-facing se utilizó, o bien controlarlo explícitamente. A continuación, cómo se ve esto de forma aplicada:
- Fija el formato en la descripción de la prueba. «Ejecutamos el modelo en LongMemEval» es una descripción insuficiente si no se dice en qué forma llegaba el historial a la entrada.
- Prueba al menos dos o tres formatos. Uno bueno y uno ingenuo (por ejemplo, diálogo crudo recortado) ya darán una idea de la sensibilidad de tu sistema.
- No compares modelos entre sí sobre empaquetados distintos. Una diferencia de 20–30 puntos puede pertenecer por completo al formato, y no al modelo.
- Verifica tus esquemas estructurados de memoria. Un cero en un registro formal con respuestas seguras al mismo dato en texto normal es un bug de presentación, no de memoria.
- Prueba por separado el canal «modelo-juez». Si el evaluador es a su vez sensible al formato, la métrica queda sesgada.
- Ten en cuenta el coste del formato. Los resúmenes y los registros tipados ahorran tokens; ahora eso tiene un reverso medible, y conviene sopesarlo de forma consciente.
La idea principal de RENDER es simple y por eso incómoda: «la evaluación de la memoria de un modelo» sin indicar la forma de presentar la evidencia es una afirmación incompleta. El mismo diálogo, las mismas preguntas, el mismo modelo, pero respuestas distintas. La diferencia está en cómo le mostraste aquello que debe recordar.


