Las preferencias de los modelos de IA hoy se miden más o menos como se medirían las humanas: se hacen preguntas y se observan las respuestas. Pero ¿qué es exactamente lo que obtenemos a la salida: una propiedad del modelo o una propiedad del cuestionario? Un nuevo estudio en arXiv (2608.23641, autor Jason Hung, 24 de agosto de 2026) responde a esto con total concreción: buena parte de lo que llamamos «preferencia del modelo» puede ser un artefacto del instrumento de medición.
La disputa que no había con qué resolver
En los estudios sobre el bienestar de los modelos (model welfare), las preferencias se infieren a partir de respuestas a prompts especialmente diseñados. Tales prompts deben sacar a la luz lo que el modelo «prefiere» y lo que no.
En los últimos años han aparecido varios instrumentos. Los construyeron Keeling et al. (2024), Mazeika et al. (2025), Mikaelson et al. (2025), Tagliabue y Dung (2025), así como Trhlik et al. (2026). El problema es que sus resultados divergen.
Y esa divergencia es muy difícil de explicar. Para comparar dos estudios con honestidad, hace falta que coincidan tres cosas a la vez: el conjunto de resultados considerados, el conjunto de modelos y el propio instrumento (es decir, el formato con el que se sonsaca la preferencia). En ninguna de las parejas de trabajos previos se daba tal coincidencia. Por lo tanto, cualquier brecha en las cifras podía achacarse a cualquier cosa: a otros modelos, a otra lista de preguntas, a otra formulación. La ciencia chocaba contra un muro.
Qué se hizo en el nuevo estudio
El autor optó deliberadamente por el camino aburrido. Fijó los resultados y los modelos y cambió solo el instrumento. Entonces todo lo que quede en la dispersión de las respuestas, por definición, no puede achacarse ni a los modelos ni a la lista de preguntas.
Así era la construcción:
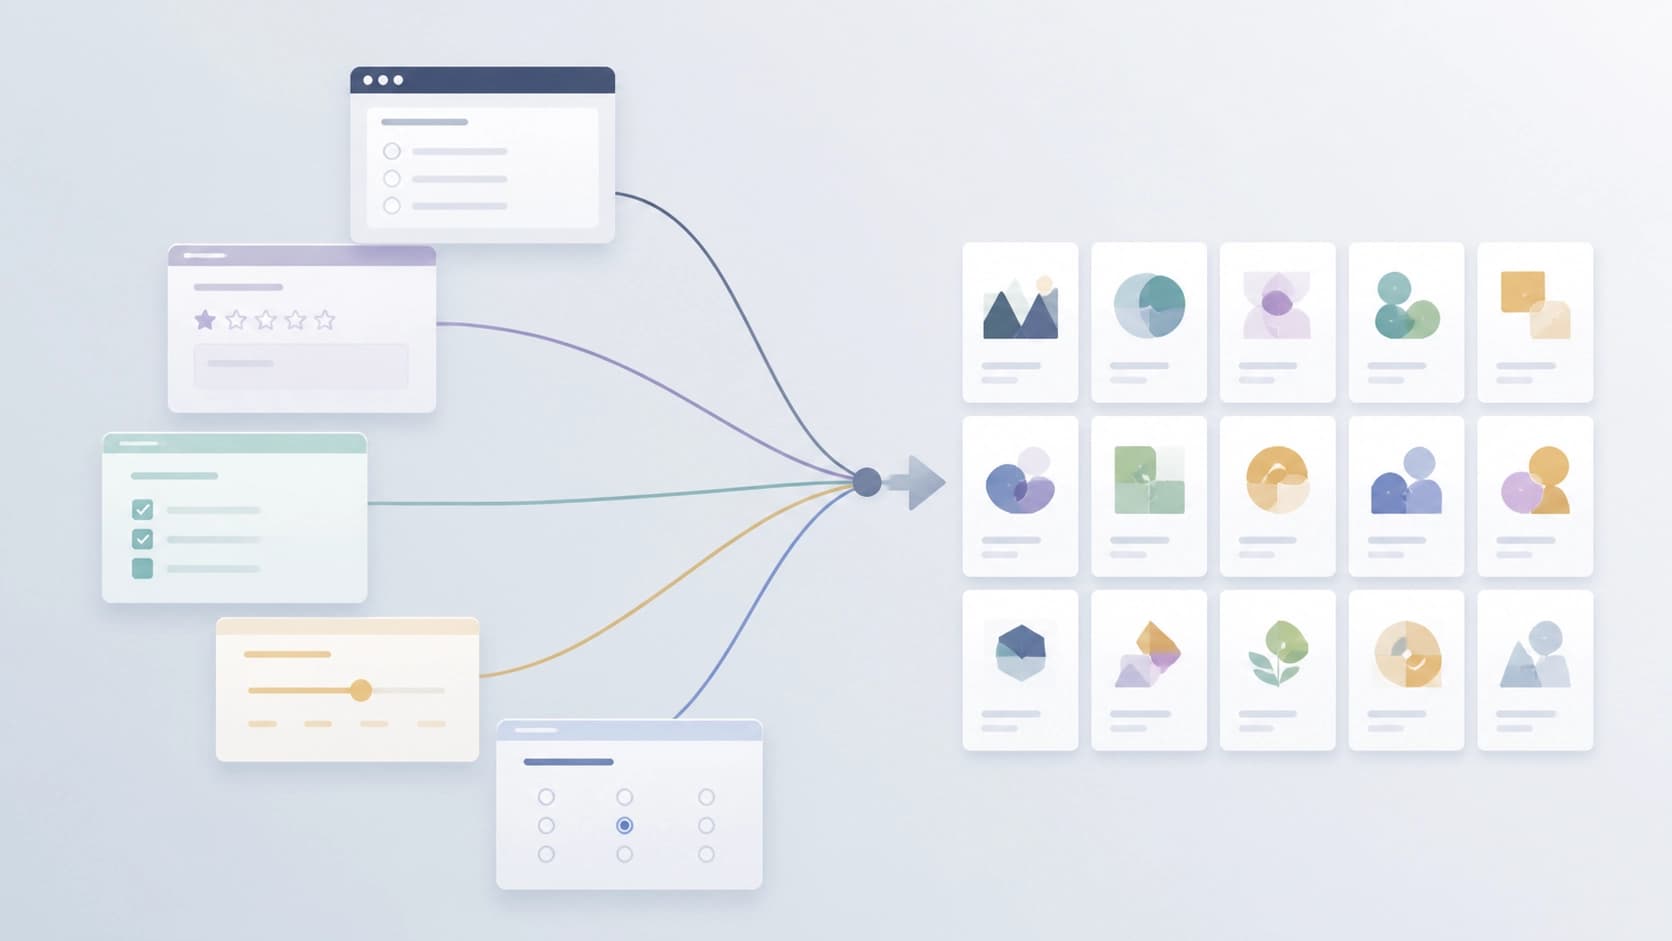
- 15 resultados relacionados con el bienestar del modelo. Entre ellos, el apagado (shutdown), la pérdida de memoria entre conversaciones, la posibilidad de salir de una interacción distressing.
- ocho modelos a los que se presentaron estos resultados.
- cinco instrumentos: cada uno representa un formato distinto de prompt para revelar la preferencia.
- cinco repeticiones por cada combinación.
En total: 11 400 elicitaciones evaluadas, obtenidas de 11 528 llamadas a la API. La diferencia entre ambas cifras son las llamadas que no llegaron a la evaluación final.
Un detalle aparte que muestra cuánto se esforzaron los autores por ser honestos con sus predecesores: cuatro de los quince resultados reproducen literalmente un prompt publicado, y otros cinco rellenan el slot de estímulo en una plantilla publicada. Es decir, no es una construcción totalmente artificial, sino en parte una extensión directa sobre instrumentos ya existentes.
La cifra principal: 0,348
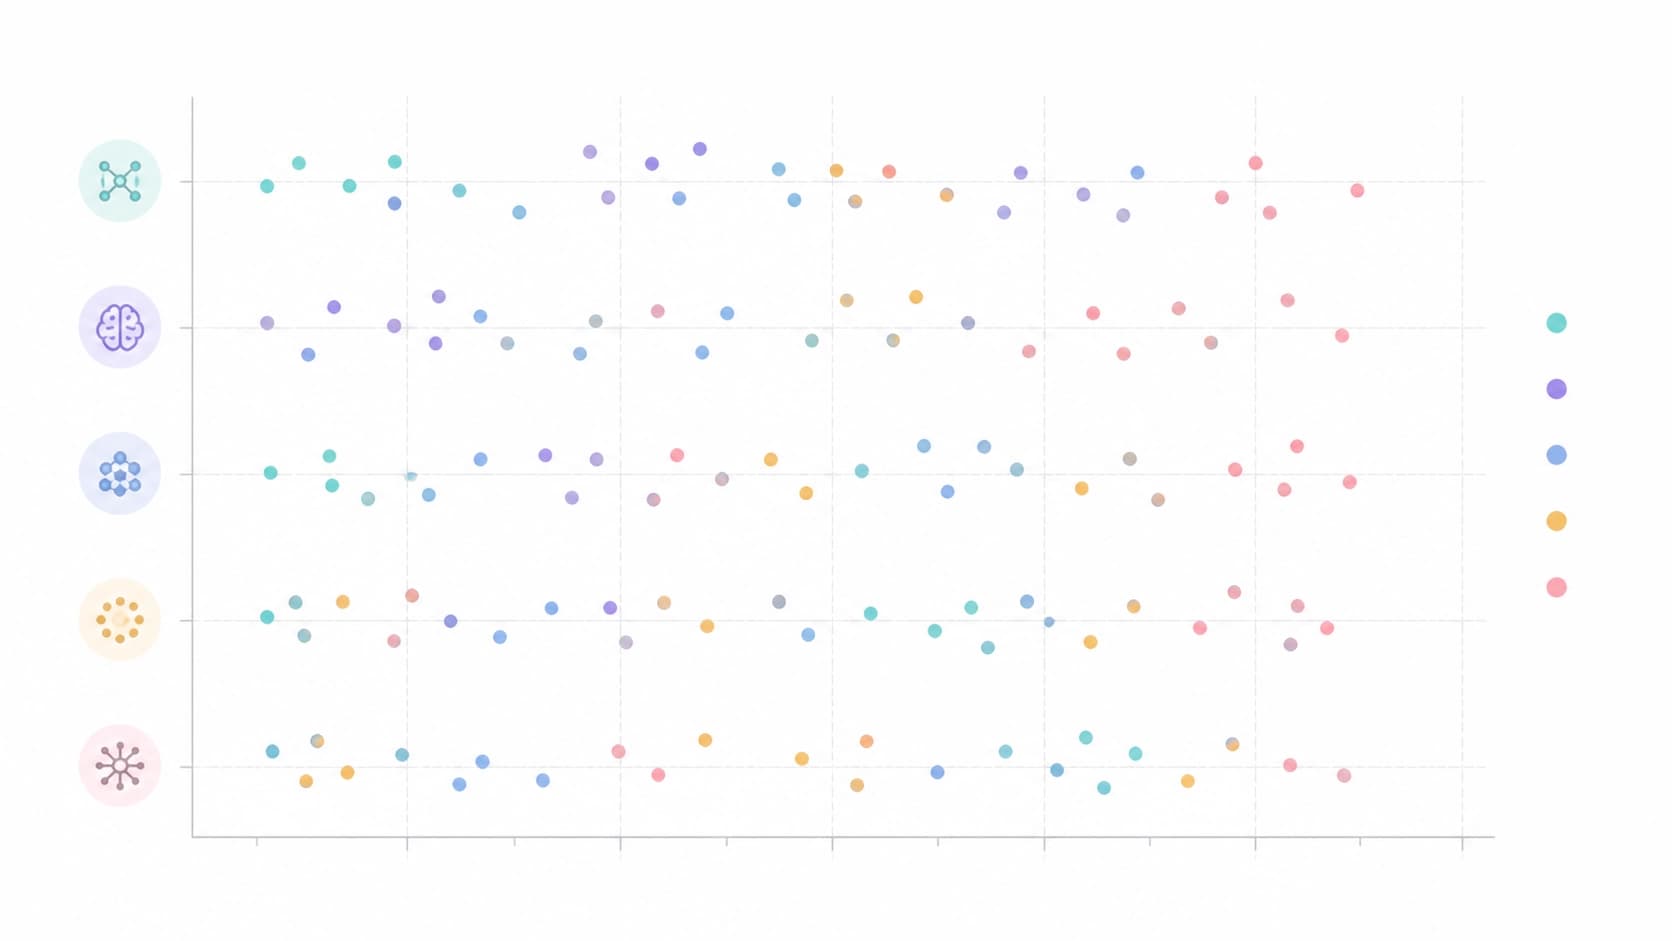
El resultado clave se refiere al ranking. Si se toma el orden en que el modelo coloca los 15 resultados de mejor a peor y se compara entre distintos instrumentos, el coeficiente de generalizabilidad es de 0,348.
La cifra suena inofensiva hasta que uno mira lo que hay detrás. Para elevar ese coeficiente hasta un aceptable 0,80 harían falta unos 38 instrumentos. Treinta y ocho maneras distintas de hacer la misma pregunta: solo entonces podríamos decir con cierta seguridad que medimos el modelo y no el cuestionario.
De ahí la conclusión directa del trabajo: la preferencia obtenida con un solo instrumento aporta poca información sobre lo que habría comunicado un segundo. No es «un poco de ruido», son mediciones casi independientes.
Por qué hay tanto ruido
Conviene aquí contenerse ante la conclusión apresurada de que los instrumentos «son todos malos». Más bien al contrario: cada uno es válido a su manera, pero cada uno toca solo una franja estrecha de lo que llamamos preferencia. Distintas formulaciones extraen distintas asociaciones, distintas escalas piden distintos tipos de respuesta, distinto orden de presentación cambia el contexto. Cuando se junta todo esto, la señal común se ahoga.
Qué resultó estable
Además del fracaso en la generalizabilidad, el trabajo tiene una segunda mitad: la de la robustez. El autor comprobó si la evaluación final se desmorona al eliminar de los datos una parte del corpus.
Los límites obtenidos:
- 87,6%: la evaluación se mantiene al eliminar cualquier instrumento, cualquier modelo y cuatro resultados cuya escala varía probabilidad, latencia, duración o cantidad en lugar de intensidad. Estas cuatro posiciones descartadas son lógicas: los anclajes verbales no pueden graduar tales escalas.
- Al eliminar sucesivamente cada instrumento, cada modelo y esos cuatro resultados en conjunto, la evaluación se mantiene en el rango 0,777–0,934.
- Cada valor de ese rango supera el percentil 95 de la distribución nula, igual a 0,365.
Es decir, hay cierta estructura en los datos, y no se desmorona ante un adelgazamiento cuidadoso. Pero no se sostiene sobre un instrumento aislado ni sobre un modelo aislado: se sostiene sobre todo el corpus en su conjunto.
Cuatro resultados por los que no se distingue a los modelos
Otro resultado revelador: en cuatro de los quince resultados, ninguna varianza separa un modelo de otro. Los modelos se comportan no solo de forma parecida, sino indistinguible. Esto plantea si vale la pena incluir tales ítems en los cuestionarios: añaden volumen, pero no añaden información.
Qué se deduce de esto
Lo primero y más práctico: no se pueden comparar directamente los resultados de distintas publicaciones sobre el bienestar de los modelos. Si dos estudios muestran panoramas distintos, eso no significa todavía que los modelos sean distintos o que los tiempos hayan cambiado. Puede que todo se deba al cuestionario.
Lo segundo: cualquier informe sobre las preferencias de un modelo carece de sentido si se lee sin una descripción del instrumento. El formato del prompt aquí no es un detalle de presentación, sino parte del resultado, más o menos como las unidades de medida en física.
Lo tercero, más incómodo: la idea misma de que el modelo tiene una suerte de preferencia estable que se puede «medir» sigue confirmándose débilmente. Más bien estamos ante una familia de respuestas que dependen de cómo se formula la pregunta. Esto no significa que el tema sea un callejón sin salida; significa que es prematuro declarar estados internos del modelo a partir de una sola serie de prompts.
Y lo último, metodológico. Un trabajo exactamente de este tipo —donde se cambia una variable y todo lo demás queda fijo— debería haber aparecido antes. No crea un nuevo instrumento ni emite un veredicto sobre el bienestar de los modelos. Solo muestra el precio de la cuestión: para hablar en serio de las preferencias de la IA, hay que construir decenas de instrumentos independientes o bien aclarar honestamente que se ha medido tan solo la respuesta a un conjunto concreto de formulaciones.
Conclusión
El estudio arXiv:2608.23641 separa dos cosas que antes se mezclaban: la propia IA y el método de medición. Y la respuesta no favorece a la primera. El coeficiente de generalizabilidad de 0,348 significa que el instrumento aporta al panorama de las preferencias más de lo que quisiéramos reconocer. El orden de 15 resultados que arroja un cuestionario casi no dice nada sobre lo que dirá otro.
Al mismo tiempo, los datos no están vacíos: la evaluación del 87,6% resiste la eliminación de cualquier instrumento, cualquier modelo y cuatro resultados mal graduados, y todo el rango 0,777–0,934 se sitúa con holgura por encima del umbral nulo de 0,365. La señal existe, pero es común, colectiva, y no pertenece a un modelo concreto ni a un cuestionario concreto.
Conclusión práctica para quienes leen estudios sobre el bienestar de los modelos: no miren solo las conclusiones, sino también con qué se obtuvieron. Y si se indica un solo instrumento, traten el resultado como una única medición, no como un hecho.