
Ajuste fino de modelos generativos de imágenes: consideración conjunta de preferencias y rúbricas
El artículo describe un método de posentrenamiento de modelos text-to-image de dominio abierto, en el que la señal de las preferencias humanas se complementa con comprobaciones basadas en rúbricas del cumplimiento del prompt y de las propiedades deseadas. Los resultados indican que la media ponderada de las recompensas rinde peor que el esquema propuesto y que, en la instantánea de Arena, Flux2dev e Ideogram-4, tras el ajuste fino, muestran un aumento notable de Elo.
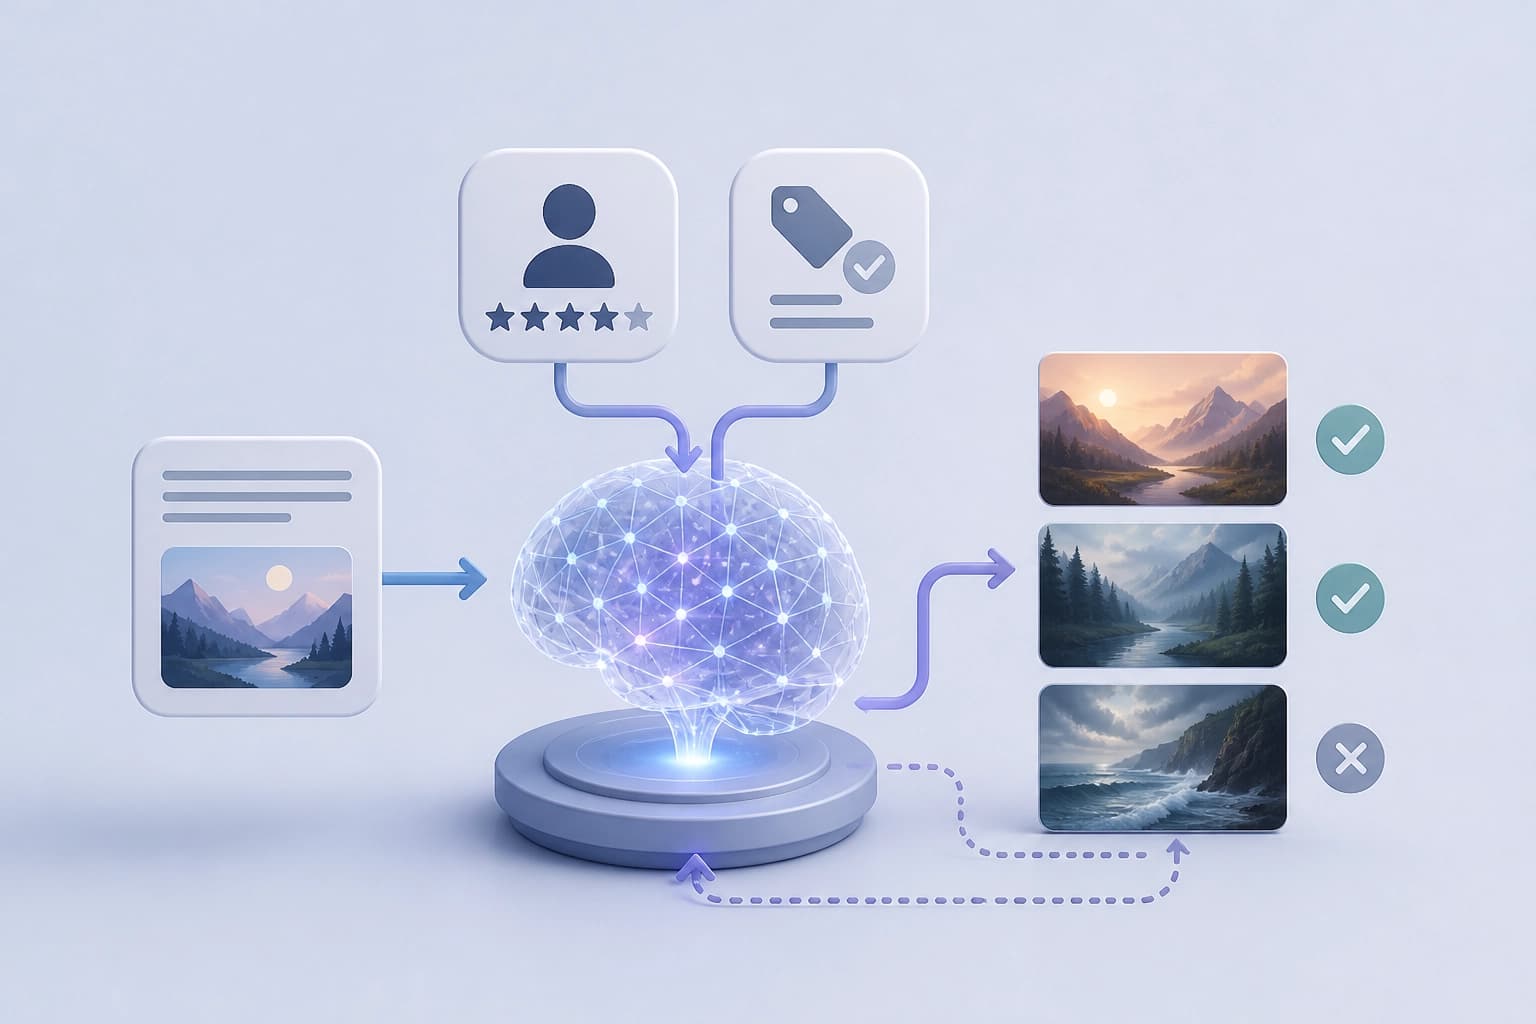
Tarea: dominio abierto y dos señales
La generación de imágenes a partir de texto en dominio abierto requiere tener en cuenta distintos requisitos. Entre ellos están la correspondencia con el prompt y las preferencias humanas. Una sola señal de recompensa no cubre ambos tipos de requisitos. El trabajo «Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards» propone un posentrenamiento basado en una combinación de señales complementarias.
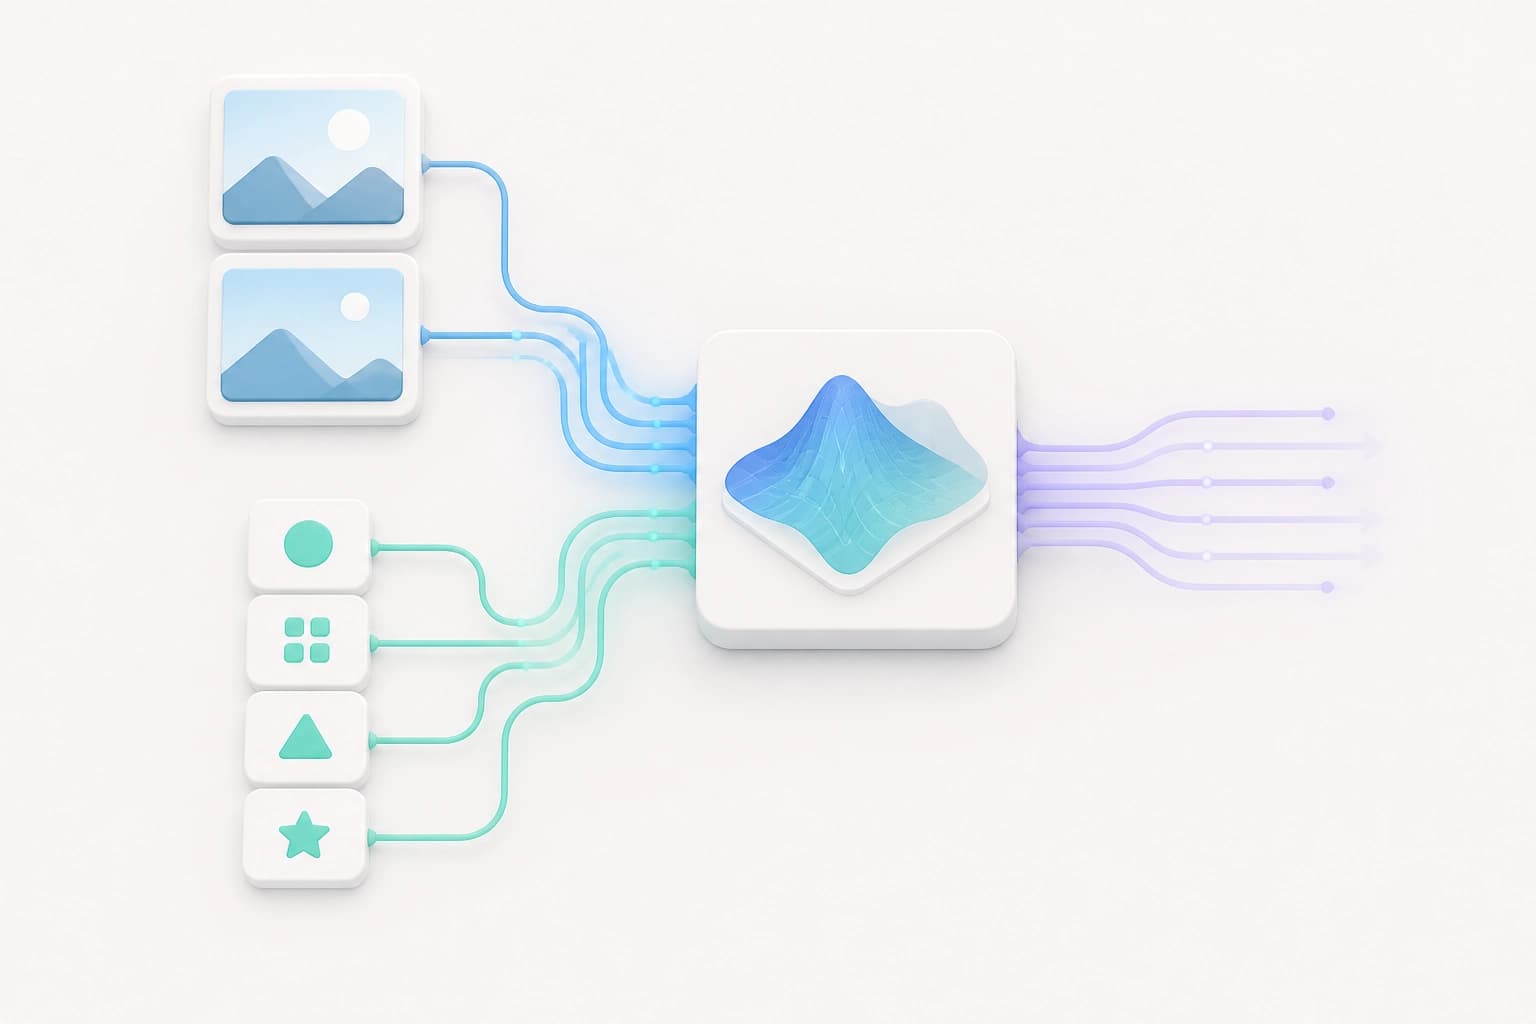
El método combina la recompensa por preferencias con recompensas basadas en rúbricas. La primera señal refleja las preferencias humanas. La segunda comprueba la correspondencia con el prompt y otras propiedades deseables. La combinación cubre distintas partes de la solicitud. Conclusión: para el dominio abierto, el criterio de selección es contar con señales complementarias, no con una sola. Deben cubrir tanto la elección subjetiva como el cumplimiento de la tarea.
Arquitectura del sistema de recompensas
El sistema incluye dos componentes principales. La recompensa por preferencias se entrena con datos a gran escala de preferencias humanas. Para el entrenamiento se aplica el objetivo de Bradley-Terry. Esta señal refleja las elecciones de las personas.
Las rúbricas evalúan la correspondencia con el prompt y otras propiedades deseables. También protegen contra la manipulación de la recompensa. Los componentes resuelven tareas distintas y se complementan.
| Componente | En qué se basa | Qué comprueba | Función |
|---|---|---|---|
| Recompensa por preferencias | Datos a gran escala de preferencias humanas, objetivo de Bradley-Terry | La elección de las personas al comparar resultados | Optimización de preferencias |
| Recompensas basadas en rúbricas | Rúbricas con criterios | La correspondencia con el prompt y otras propiedades deseables | Protección contra la manipulación de la recompensa |
Los autores formulan un requisito para que las recompensas sean eficaces. Deben cubrir ampliamente las intenciones de los usuarios. Deben ser resistentes a la explotación durante la optimización.
Conclusión: el criterio de selección es que las rúbricas complementen las preferencias, no que las sustituyan. Un sistema sin rúbricas pierde la protección contra la manipulación de la recompensa. Un sistema sin preferencias no se basa en la elección humana.
Combinar en lugar de calcular una media simple
Los autores señalan un problema con la media ponderada ingenua. Durante la optimización, este promedio conduce a un comportamiento subóptimo. El trabajo propone una estrategia para combinar las recompensas. Esta equilibra de forma más eficaz la optimización de preferencias y el cumplimiento de las rúbricas.
| Enfoque | Qué ocurre durante la optimización |
|---|---|
| Media ponderada ingenua | El comportamiento se vuelve subóptimo |
| Estrategia de combinación | Se equilibran de forma más eficaz la optimización de preferencias y el cumplimiento de las rúbricas |
La estrategia de combinación se convierte en una parte diferenciada del método. Conclusión: el criterio de selección es contar con una estrategia de combinación, no solo con un conjunto de recompensas. Los pesos de las señales sin una estrategia no garantizan el comportamiento deseado.
Resultados en la clasificación Arena text-to-image
En la clasificación Arena text-to-image, el modelo Flux2dev obtuvo una puntuación Elo 69 puntos superior a la del modelo base. El modelo pasó por un entrenamiento de RL. Tras el posentrenamiento, el modelo Ideogram-4 superó a todos los modelos de código abierto. Su puntuación Elo fue de 1223.5.
Estos datos muestran el efecto del posentrenamiento dentro de la clasificación. No describen otros escenarios de uso.
| Modelo | Resultado | Comparación |
|---|---|---|
| Flux2dev entrenado con RL | 69 puntos de Elo por encima | Modelo base |
| Ideogram-4 posentrenado | Elo de 1223.5 | Todos los modelos de código abierto |
Conclusión: el criterio de evaluación es tener en cuenta el modelo base y las condiciones de entrenamiento. Para Flux2dev, los autores indican la mejora respecto al modelo base. Para Ideogram-4, señalan su posición entre los modelos abiertos.
Limitaciones de la instantánea de la clasificación y de los datos
Las afirmaciones sobre resultados de vanguardia corresponden a la instantánea de Arena del 4 de septiembre de 2026. La instantánea refleja el estado de la clasificación en esa fecha. Los autores publicaron Arena-T2I-Training. Se trata de un subconjunto de datos de entrenamiento de 1K.
Permite reproducir parte de las mejoras del entrenamiento completo. Algunas mejoras quedan fuera del subconjunto. Para verificar el método, es importante distinguir el resultado completo de la parte reproducible.
Conclusión: el criterio de selección es tener en cuenta la fecha de la instantánea y los límites de reproducibilidad. Una afirmación sin estos límites queda incompleta.
Preguntas frecuentes
Material similar
Todos los materiales
Benchmark Zero2Repo: límites de la creación autónoma de proyectos desde un directorio vacío
El estudio propone evaluar agentes de programación en una compilación completa del repositorio: la entrada incluye una especificación, un contrato de interfaz y un entorno vacío; la evaluación se realiza con pruebas ocultas, sin un juez basado en LLM. Incluso los agentes más destacados rara vez superan todas las pruebas, y la mayoría de los fallos se debe a requisitos puntuales que se han pasado por alto.
13 noviembre 2026
FedSocket: modelos intercambiables con ejecución obligatoria en el receptor ante la heterogeneidad multimodal
Se propone FedSocket, un enfoque en el que el modelo intercambiado debe poder ejecutarse en el lado del receptor y los distintos modelos privados se conectan mediante una interfaz común de predicción Q. El artículo describe una agregación que tiene en cuenta la pertenencia, el envío únicamente de los parámetros de Q junto con los contadores y experimentos con seis conjuntos de datos que demuestran un aumento de la precisión cuando faltan modalidades y la ventaja de la inferencia conjunta frente a los ensamblajes independientes.
13 noviembre 2026
CyberArena: los enfrentamientos por parejas entre agentes de IA revelan los límites de los benchmarks estáticos de ciberseguridad
El benchmark sitúa a dos agentes en entornos aislados con servicios que cambian continuamente y, tras una serie de rondas, resume sus acciones en puntuaciones multidimensionales de habilidades ofensivas y defensivas. En 466 partidas con 12 modelos de última generación, distinguió capacidades allí donde las pruebas unidireccionales alcanzan su límite, incluido el razonamiento a varios turnos y la creación de puertas traseras.
13 noviembre 2026