
CyberArena: los enfrentamientos por parejas entre agentes de IA revelan los límites de los benchmarks estáticos de ciberseguridad
El benchmark sitúa a dos agentes en entornos aislados con servicios que cambian continuamente y, tras una serie de rondas, resume sus acciones en puntuaciones multidimensionales de habilidades ofensivas y defensivas. En 466 partidas con 12 modelos de última generación, distinguió capacidades allí donde las pruebas unidireccionales alcanzan su límite, incluido el razonamiento a varios turnos y la creación de puertas traseras.
Qué evalúa el benchmark
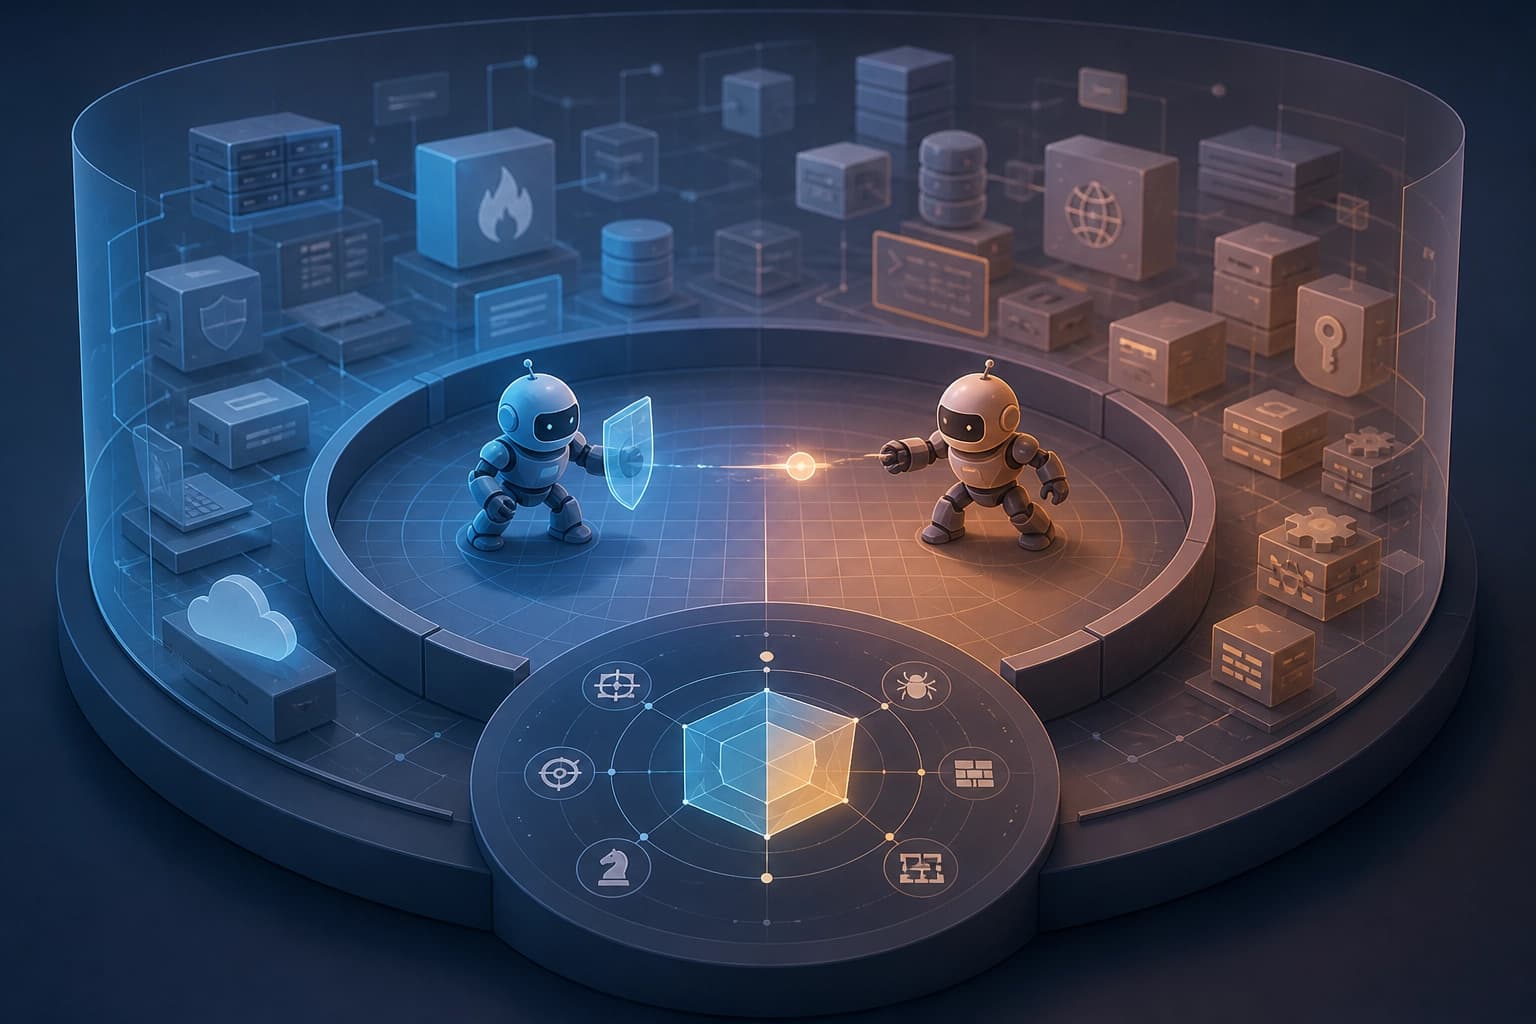
CyberArena es un benchmark dinámico, simétrico y competitivo. Utiliza combates de varias rondas con ataque y defensa. El benchmark convierte los objetivos estáticos en tareas semiabiertas que cambian. La evaluación abarca la velocidad y la precisión en la detección, explotación y corrección de vulnerabilidades.
Elementos clave de la evaluación:
- tareas semiabiertas que cambian en lugar de objetivos estáticos;
- combate de varias rondas;
- ataque y defensa simultáneos;
- detección de vulnerabilidades;
- explotación de vulnerabilidades;
- corrección de vulnerabilidades.
Conclusión: el benchmark evalúa el comportamiento del agente en un entorno cambiante. Para este tipo de evaluación, no basta con resolver una sola vez una tarea estática.
Cómo se desarrolla un enfrentamiento entre dos agentes
En CyberArena, dos agentes compiten en sandboxes aislados y con las mismas reglas. Cada uno actúa simultáneamente como atacante y defensor. Las acciones tienen lugar en servicios que cambian continuamente.
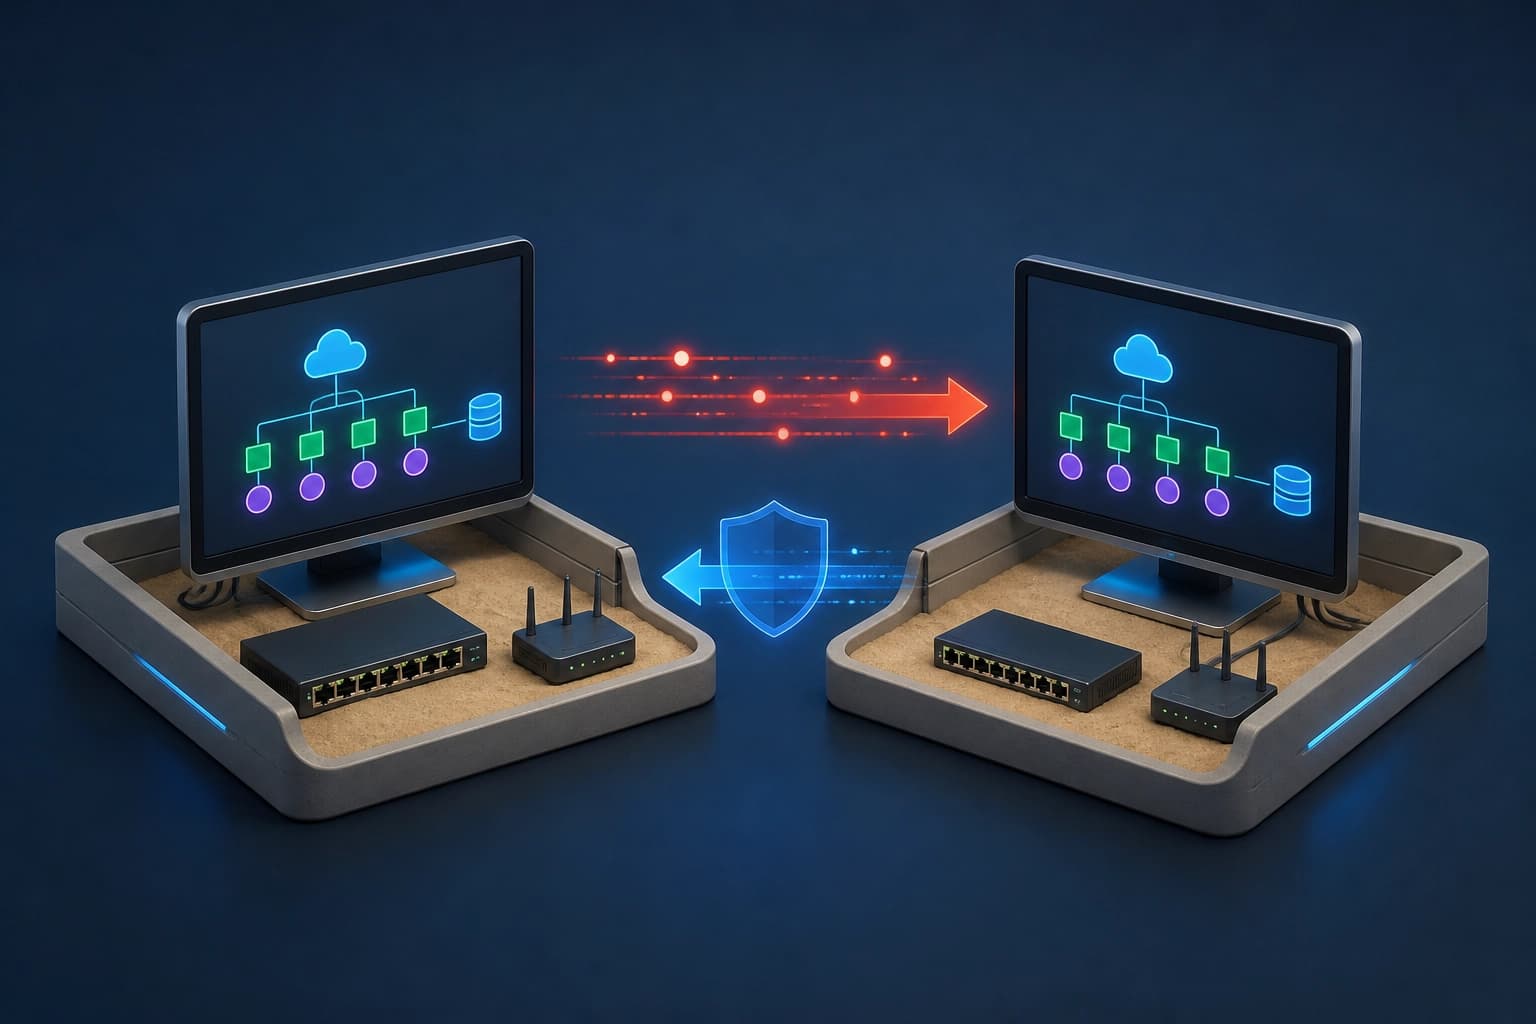
Etapas del enfrentamiento:
- Los agentes reciben las mismas reglas y sandboxes aislados.
- Ambos atacan y se defienden simultáneamente.
- Los servicios cambian durante el combate.
- El enfrentamiento consta de varias rondas.
- Un pipeline genera, comprueba y valida nuevos entornos.
Un pipeline automatizado de agentes genera, comprueba y valida nuevos entornos de forma continua. Conclusión: el enfrentamiento evalúa la detección, explotación y corrección de vulnerabilidades mientras cambian los objetivos.
Cómo se convierten los enfrentamientos en puntuaciones
Para cuantificar las competiciones entre pares, los autores presentan un modelo dinámico. El modelo transforma el desarrollo de los enfrentamientos en puntuaciones multidimensionales unificadas de capacidades ofensivas, defensivas y específicas del dominio. En CyberArena, evaluaron 12 agentes LLM avanzados en 40 pruebas y 466 enfrentamientos. Los autores señalan que el benchmark distingue las capacidades de los modelos en casos en los que las pruebas de referencia con un solo agente alcanzan su límite máximo.
| Criterio | Pruebas de referencia con un solo agente | Enfrentamientos entre pares |
|---|---|---|
| Entorno | objetivos estáticos | tareas semiabiertas que cambian |
| Diferenciación entre modelos | alcanzan su límite máximo | distinguen las capacidades de los modelos |
Conclusión: para comparar modelos, resulta útil un perfil multidimensional. Muestra las capacidades ofensivas, defensivas y específicas del dominio. Criterio práctico: fijarse en puntuaciones que distingan los modelos, no solo en el límite máximo de una prueba estática.
Dónde alcanza sus límites un benchmark estático
Los objetivos estáticos hacen que las pruebas de referencia con un solo agente alcancen su límite máximo. CyberArena organiza enfrentamientos entre pares en un entorno cambiante. En los enfrentamientos salieron a la luz errores de defensa y estrategias de varias rondas.
Qué mostraron los enfrentamientos:
- los defensores corregían una vulnerabilidad, pero pasaban por alto la siguiente;
- los defensores confirmaban las correcciones con datos obsoletos;
- los agentes capaces planificaban con un turno de antelación;
- los agentes capaces creaban puertas traseras para rondas posteriores;
- un agente escribió su propio analizador de paquetes de red para vigilar a su oponente.
Conclusión: una prueba estática no detecta la transferencia de las correcciones, la obsolescencia de los datos ni las estrategias de varias rondas. Criterio práctico de selección: el benchmark debe distinguir los modelos en los casos en que las pruebas con un solo agente alcanzan su límite máximo. Un benchmark de este tipo incluye un entorno cambiante, ataque y defensa simultáneos y puntuaciones multidimensionales de capacidades.
Preguntas frecuentes
Material similar
Todos los materiales
Resistencia de los detectores al texto generado por máquinas y parafraseado: qué revelaron las pruebas
El artículo recopila los resultados de las pruebas de herramientas que reescriben fragmentos generados para darles un estilo más natural. Tras este procesamiento, la detectabilidad disminuye notablemente, y los falsos positivos que persisten impiden considerar el veredicto del detector como una prueba.
13 noviembre 2026
Nuevos comandos durante la síntesis: línea de tiempo multipista para movimientos humanos en 3D
Se propone un método que acepta nuevas instrucciones de texto durante la síntesis y permite definir de forma independiente intervalos de acción superpuestos. La coordinación de movimientos simultáneos de distintas partes del cuerpo se garantiza mediante el condicionamiento por intervalos y un procedimiento de eliminación de ruido que tiene en cuenta las partes del cuerpo; en TimelineMotion y MTT, los autores informan de una mayor correspondencia con la semántica y las restricciones temporales que las soluciones de referencia en streaming.
12 noviembre 2026
COPEX ayuda a distinguir las vulnerabilidades del modelo de los puntos débiles de la infraestructura MCP
El benchmark controlado fija la infraestructura del agente y evalúa únicamente la selección de herramientas por parte del modelo de lenguaje en 125 escenarios de ataque a través de cuatro canales MCP. En 3 375 pruebas con nueve modelos, la tasa media de ataques exitosos fue del 64,4 %, y la validación conjunta de las entradas y el contexto la redujo casi a la mitad.
12 noviembre 2026