
Personalización mediante el desarrollo de wrappers: dónde están los límites de la aproximación, la generalización y la optimización
Los autores estudian agentes personales que se adaptan a las solicitudes de cada usuario con un modelo base fijo y formalizan la mejora de la capa de control —contexto, memoria, herramientas y ejecución— como un problema de aprendizaje. Un benchmark centrado en las preferencias y un análisis teórico de los errores de aproximación, generalización y optimización muestran los límites de la arquitectura, la escala y los algoritmos de autoevolución de la capa envolvente.
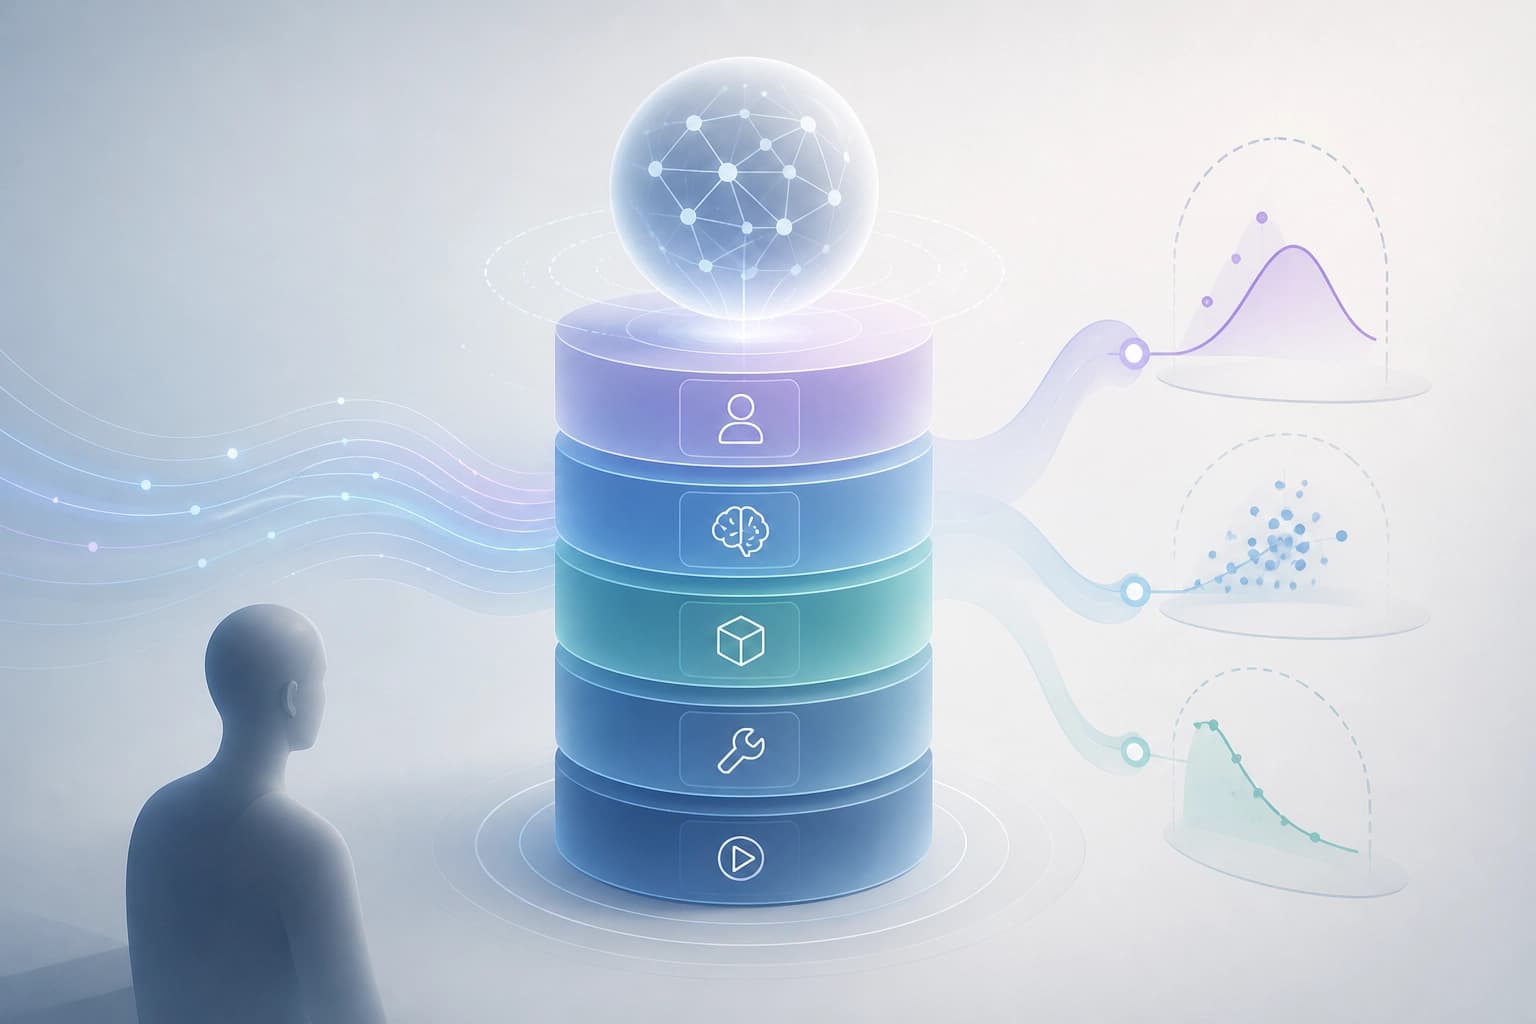
La capa de orquestación del agente personal gestiona el contexto, la memoria, las herramientas y la ejecución. A través de ella, el agente se adapta a las preferencias de cada usuario. El modelo base permanece inalterado. Por tanto, es la capa de orquestación la que define el espacio de personalización.
El trabajo arXiv:2609.36892 «La evolución de la capa de orquestación como aprendizaje: límites de aproximación, generalización y optimización de los agentes personales que se mejoran a sí mismos» se presentó el 29 de septiembre de 2026. Sus autores son Zeyu Gan, Zixuan Gong y Yong Liu. Estudian agentes personales que se adaptan mientras el modelo base permanece inalterado. La adaptación se basa en el diseño y la evolución de la capa de orquestación.
Qué evoluciona: arquitectura, escala y algoritmos
Los autores investigan la evolución de la capa de orquestación desde tres aspectos: arquitectura, escala y algoritmos de autoevolución. La arquitectura determina cómo gestiona la capa de orquestación el contexto, la memoria, las herramientas y la ejecución. La escala y los algoritmos de autoevolución delimitan el mismo proceso.
La parte empírica presenta un benchmark orientado a las preferencias. Describe sistemáticamente las capacidades y limitaciones de los agentes personales en relación con estos tres aspectos. Es decir, los aspectos funcionan como ejes de evaluación, no como mejoras independientes.
Criterio práctico: evaluar un solo aspecto no describe las capacidades y limitaciones del agente en su conjunto. Conviene analizar la capa de orquestación atendiendo a los tres ejes a la vez.
Tres tipos de error como marco de los límites
La parte teórica formula la evolución de la capa de orquestación como un problema de aprendizaje. Explica los fenómenos observados mediante errores de aproximación, generalización y optimización. Estos tres tipos de error definen el marco para hablar de los límites de la personalización.
Los autores proponen una perspectiva unificada de los límites de la personalización mediante la evolución de la capa de orquestación. A partir de ella, analizan el diseño de estas capas. Esto conecta la parte empírica con la teórica.
Criterio práctico: los límites de la personalización se describen mediante un tipo de error concreto, no con una valoración general de la capa de orquestación. Esta descripción muestra dónde se detiene exactamente el desarrollo.
Políticas alcanzables, evidencias y sesgo
El análisis teórico abarca las políticas alcanzables. Se trata del conjunto de estrategias a las que puede llegar el agente. Una estrategia que quede fuera de este conjunto seguirá siendo inaccesible con cualquier ajuste de la capa de orquestación.
El análisis abarca la capacidad con evidencias finitas de interacción. La experiencia de interacción es finita por naturaleza. Su volumen limita las conclusiones que el agente extrae sobre las preferencias del usuario.
El análisis abarca la dinámica de actualización con sesgo. El sesgo influye en cómo se actualiza la capa de orquestación durante la autoevolución. Este factor actúa independientemente de la falta de evidencias.
Criterio práctico: al analizar una personalización fallida, se distinguen las políticas inalcanzables, la falta de evidencias y el sesgo en las actualizaciones. Cada causa requiere una solución diferente.
Criterios para diseñar la capa de orquestación
- Separar la arquitectura, la escala y los algoritmos de autoevolución como ámbitos de decisión independientes.
- Basarse en un benchmark orientado a las preferencias.
- Describir los límites de la personalización mediante errores de aproximación, generalización y optimización.
- Tener en cuenta que las evidencias de interacción son finitas y que existe sesgo en la dinámica de actualización.
- Mantener una perspectiva unificada de los límites de la personalización al diseñar la capa de orquestación.
Este conjunto de criterios mantiene la personalización dentro de los límites de lo que la capa de orquestación puede ofrecer realmente cuando el modelo base permanece inalterado. También muestra dónde termina el diseño y empieza el límite.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026