
Sistema de IA multiagente compuesto con un circuito de evidencia para la planificación de protones en tumores de cabeza y cuello
El trabajo describe la combinación de una política PPO entrenada, que genera varias opciones de plan, y agentes LLM que mantienen un diálogo de уточнение guiado por la verificación de métricas clínicas y restricciones; en una muestra de 21 pacientes, Qwen3-14B, ajustado con entrenamiento adicional, siguió mejor las instrucciones y ayudó a orientar el equilibrio hacia los objetivos prioritarios. La conclusión práctica es que la planificación DRL automatizada puede complementarse con un diálogo guiado, manteniendo el control sobre las restricciones en conflicto.
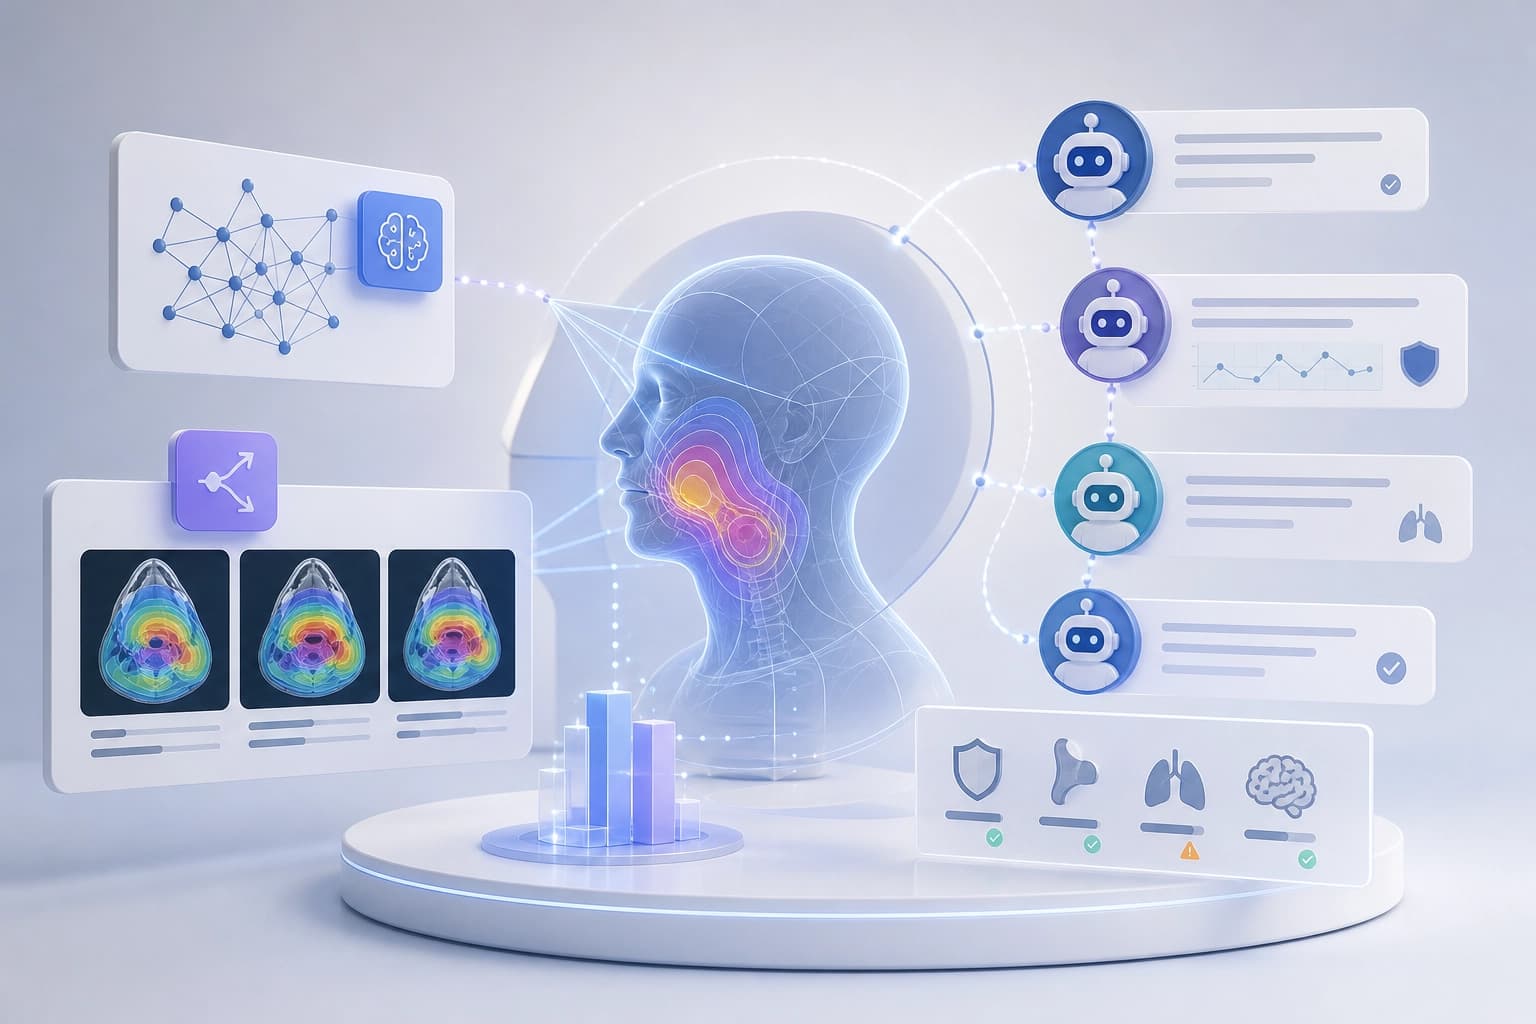
Arquitectura compuesta: generación y refinamiento
Qingqing Wang, Liqiang Xiao y Chang Chang publicaron un artículo en arXiv el 21 oct 2026 (arXiv:2610.29010). En él describieron un sistema para la terapia con protones PBS contra el cáncer de cabeza y cuello. El sistema combina la planificación automática basada en DRL con el refinamiento de planes mediante diálogo con LLM.
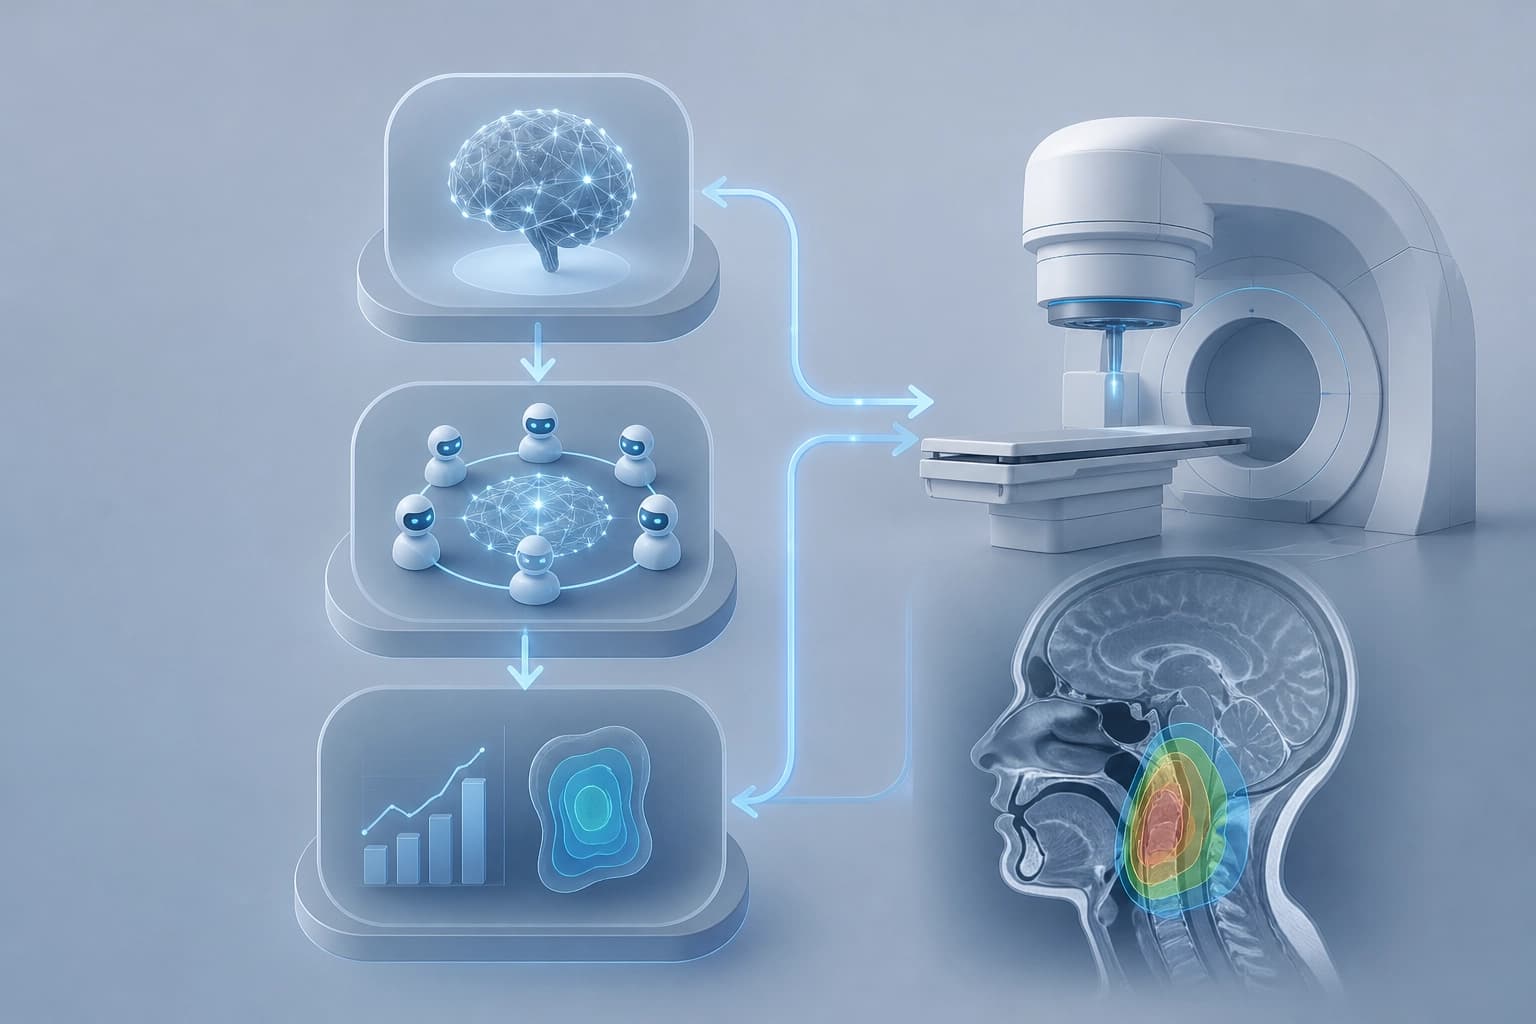
La etapa automática basada en DRL crea un conjunto de planes. El sistema selecciona uno como plan objetivo y utiliza los demás como referencia durante el refinamiento. Para los casos complejos, el sistema contempla una arquitectura multiagente con LLM que refina el plan mediante un diálogo en lenguaje natural. Conclusión: el esquema separa la generación automática del refinamiento dialogado con apoyo de datos.
Generación automática de planes con PPO
La etapa automática se basa en una red de políticas PPO. Los autores entrenaron la red sin intervención humana; primero genera varios planes. El entrenamiento y la evaluación se realizaron con datos de 21 pacientes con cáncer de cabeza y cuello. Para cada paciente, los autores generaron 5 planes PPO.
El conjunto de varios planes proporciona material para seleccionar el plan objetivo y una base de referencia para el refinamiento. El criterio: la generación automática debe producir un conjunto de planes, no solo uno. Así, el circuito de refinamiento contará con una base de apoyo.
Circuito multiagente de refinamiento
Para los casos complejos, el sistema utiliza una arquitectura multiagente con LLM. Esta refina el plan mediante interacciones en lenguaje natural. El circuito incluye un agente de planificación, un chatbot y un agente de evaluación.
El agente de planificación propone ajustes con apoyo de datos. El chatbot sirve como interfaz única para el diálogo. El agente de evaluación establece un circuito basado en evidencia: extrae métricas clínicas e identifica incumplimientos de las restricciones.
Este circuito permite verificar el refinamiento mediante métricas clínicas y restricciones. El criterio: el refinamiento debe basarse en indicadores clínicos medibles, no solo en el texto del diálogo.
Entrenamiento del agente de planificación
El agente de planificación funciona con Qwen3-14B. Justifica sus recomendaciones basándose en los datos de los planes creados anteriormente. Para el entrenamiento adicional en las tareas, los autores aplicaron SFT y GRPO.
En comparación con el LLM de referencia, Qwen3-14B con ajuste fino mostró capacidades mejoradas. Sigue mejor las instrucciones, extrae información y razona en el ámbito especializado.
| Criterio | LLM de referencia | Qwen3-14B con ajuste fino |
|---|---|---|
| Seguimiento de instrucciones | Capacidad básica | Capacidad mejorada |
| Extracción de información | Capacidad básica | Capacidad mejorada |
| Razonamiento en el ámbito especializado | Capacidad básica | Capacidad mejorada |
Criterio práctico: para el agente de planificación no solo es importante la generación, sino también el seguimiento de instrucciones, la extracción de datos y el razonamiento especializado. El entrenamiento con SFT y GRPO potencia estas cualidades.
Evaluación y compromisos clínicos
Los autores seleccionaron 50 planes para refinarlos con instrucciones. Los ajustes mejoraron con mayor eficacia los objetivos prioritarios para el usuario. Al mismo tiempo, el deterioro de los objetivos en conflicto se mantuvo limitado. Los autores señalan que los ajustes permitieron obtener compromisos más adecuados desde el punto de vista clínico al refinar los planes teniendo en cuenta a cada paciente.
Criterio práctico: evaluar el refinamiento según la mejora de los objetivos prioritarios y el deterioro limitado de los objetivos en conflicto.
Preguntas frecuentes
Material similar
Todos los materiales
Selección computacional en lugar de prueba y error empírica: nuevos enfoques para los materiales de baterías
El artículo muestra cómo las bases de datos computacionales, el aprendizaje automático y los modelos generativos reducen el conjunto de composiciones prometedoras, mientras que los laboratorios automatizados aceleran su validación; aun así, el resultado depende de la síntesis y las pruebas, donde las predicciones pueden diferir de la conductividad real.
20 noviembre 2026
Evolución de los benchmarks de agentes al escalar el conjunto de tareas: el papel de la selección de evidencias y las carreras secuenciales
El trabajo explica por qué aumentar el número de tareas puede perjudicar la evolución de los entornos de agentes: la causa es una selección inadecuada de evidencias, no el volumen de datos en sí. El método propuesto, Successive Scale Racing, selecciona sucesivamente combinaciones diversas de tareas y compara candidatos a bajo coste; en tres benchmarks, aumentó la proporción de ejecuciones exitosas al ampliar el conjunto de 40 a 200 tareas, mientras que los métodos de referencia empeoraron y el número de ejecuciones de validación se redujo en aproximadamente un 60 %.
19 noviembre 2026
Persuasión mutua entre modelos: las posturas declaradas no coinciden con su comportamiento en el diálogo
En debates controlados sobre las causas del cambio climático, cuatro parejas de GPT-6 Luna y Gemini 2.5 Flash Lite muestran dinámicas distintas de convergencia o divergencia de posturas. La instrucción explícita de persuadir no produce un efecto sostenido, y la posición declarada y el estilo habitual de debate no reflejan lo mismo.
19 noviembre 2026