
Enfoque OWP: redistribución de evidencias y señales a priori en Omni-LLM
Se presenta Omni-Woodpecker, un framework que no requiere entrenamiento, detecta conflictos entre modalidades y, antes de la decodificación, reajusta el equilibrio entre los datos del contexto y los priors memorizados en los estados ocultos. En Qwen2.5-Omni-7B y VideoLLaMA2-AV, el método mejora la resistencia a los errores audiovisuales en CMM y AVHBench, y ofrece una mejora moderada en benchmarks generales de razonamiento.
Qué es OWP y qué problema resuelve
Omni-Woodpecker (OWP) es un framework sin entrenamiento para corregir alucinaciones intermodales en LLM multimodales. El método traslada la corrección del nivel de los datos de salida al reequilibrio de las representaciones inducido por el conflicto entre modalidades. Los autores presentaron el artículo el 19 de octubre de 2026: Zijian Liu, Chaoyou Fu, Yan Yang, Caifeng Shan, Ran He.
La corrección tradicional trabaja con una respuesta ya generada. OWP interviene en las representaciones internas antes de la decodificación. Esto cambia el punto en el que se aplica el método.
Conclusión: OWP cambia el punto de corrección, en lugar de editar una respuesta ya generada.
Etapas de reequilibrio de evidencias y señales a priori
OWP lleva a cabo el reequilibrio en varias etapas. Primero, el método detecta conflictos intermodales mediante representaciones complementarias de cada modalidad.
- Detección de conflictos intermodales mediante representaciones complementarias de cada modalidad.
- Descomposición ortogonal de los estados ocultos para separar las evidencias de grounding de las estimaciones a priori que compiten con ellas.
- Reequilibrio adaptativo de las representaciones fusionadas: supresión de las señales a priori engañosas y recuperación de evidencias ignoradas.
- Envío de las representaciones corregidas a la decodificación.
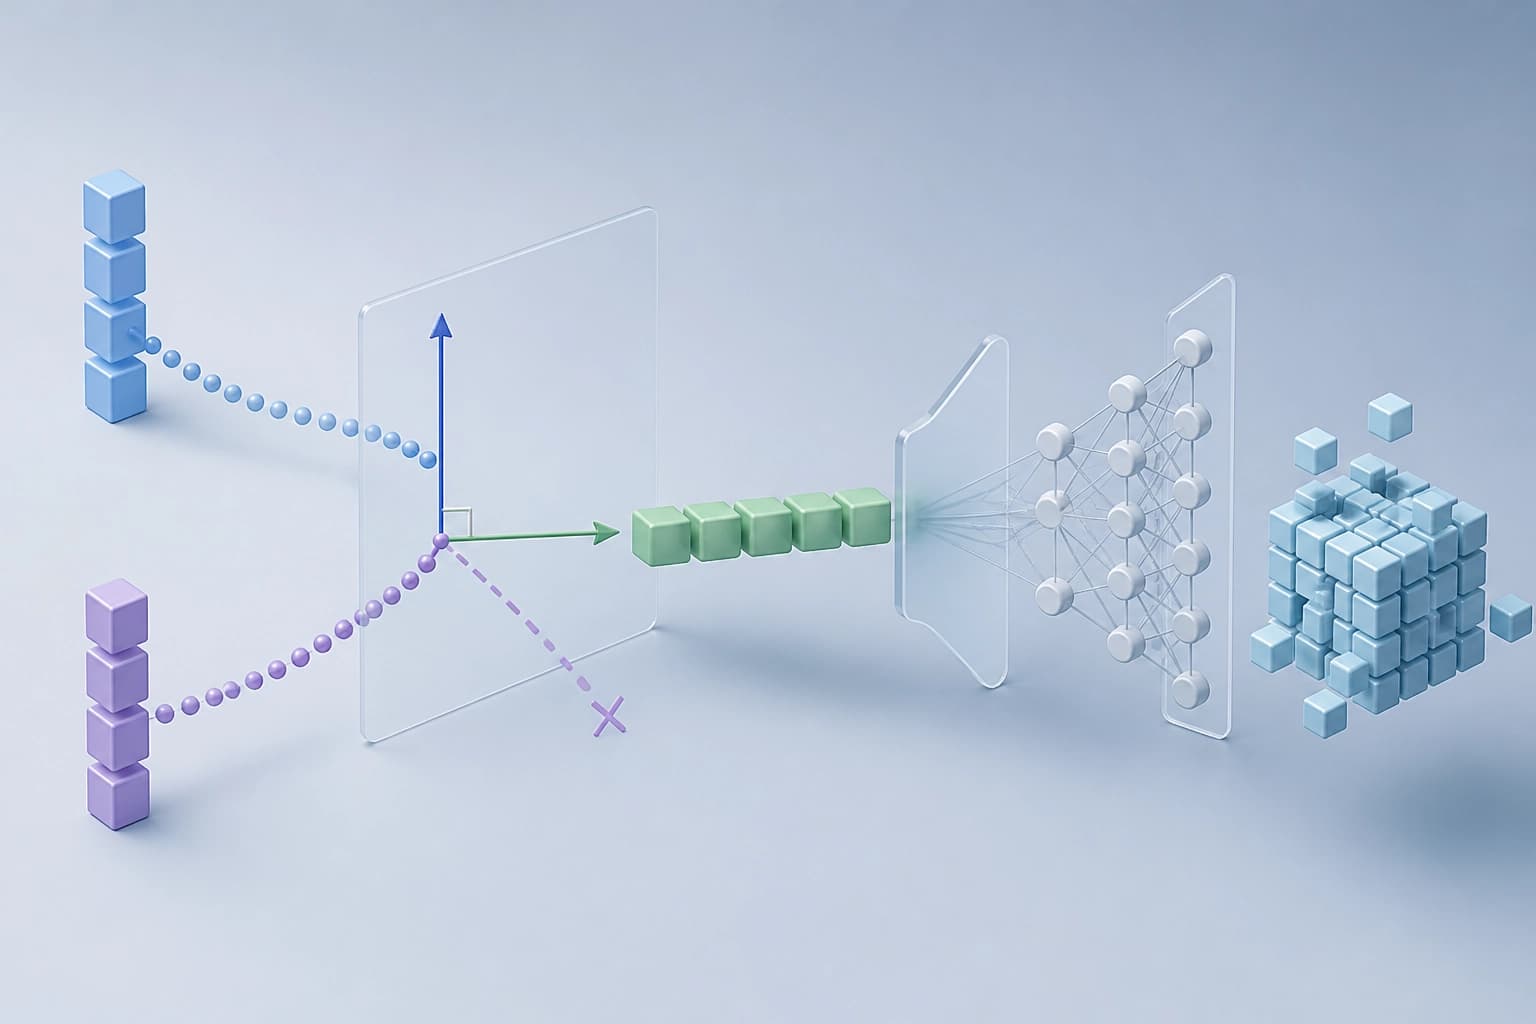
El método no modifica los pesos del modelo. Corrige las representaciones antes de la generación.
Conclusión: OWP no requiere entrenamiento ni cambios en los pesos. Interviene en los estados ocultos antes de la decodificación.
Resultados: mejoras en benchmarks y transferibilidad
En Qwen2.5-Omni-7B, OWP mejora los resultados en 12,9 y 8,6 puntos en CMM y AVHBench. En cuatro benchmarks generales de razonamiento, la mejora de OLLM es de 0,67–2,25 puntos.
| Modelo | CMM | AVHBench |
|---|---|---|
| Qwen2.5-Omni-7B | +12,9 puntos | +8,6 puntos |
| VideoLLaMA2-AV | +4,6 puntos | +3,9 puntos |
El método demostró ser transferible a VideoLLaMA2-AV: mejora de 4,6 y 3,9 puntos en CMM y AVHBench. Los autores afirman que es eficaz y transferible entre arquitecturas. El código está disponible públicamente.
Conclusión: la mejora depende del modelo y del benchmark. Criterio práctico: conviene probar OWP en la propia arquitectura y en el conjunto de tareas objetivo antes de implementarlo.
Criterios prácticos para elegir OWP
OWP es adecuado si se cumplen varias condiciones. El método funciona sin entrenamiento y sin modificar los pesos del modelo.
- Se necesita corregir alucinaciones intermodales sin entrenamiento.
- Se dispone de estados ocultos y representaciones de cada modalidad.
- Se requiere intervenir antes de la decodificación, en lugar de posprocesar la respuesta.
- Es posible reproducir el método: el código está disponible públicamente.
OWP es un método sin entrenamiento para reequilibrar evidencias y señales a priori. Los autores afirman que es transferible entre arquitecturas. Probarlo en un modelo concreto sigue siendo un paso obligatorio.
Preguntas frecuentes
Material similar
Todos los materiales
LightCRS: esquema compacta de recomendación conversacional multidominio sin una VLM independiente por categoría
Los autores presentan un sistema en el que las características multimodales de los productos se calculan offline con codificadores congelados y, durante el diálogo, las procesa un módulo compartido entre todos los dominios, de 5,3 millones de parámetros, con atención cruzada condicionada por la consulta. En un benchmark de 25 dominios, el enfoque mejora las métricas medias de clasificación, reduce notablemente la latencia y muestra que el entrenamiento conjunto ofrece mejores resultados que los modelos independientes para cada dominio.
16 noviembre 2026
Reparación limitada de tácticas en Lean 4 basada en el diagnóstico del compilador
Se propone un módulo paso a paso que, en lugar de descartar una táctica rechazada, pide al modelo corrector que la revise hasta R veces teniendo en cuenta el error de Lean; con K candidatos, esto aumenta la proporción de problemas resueltos. Los experimentos con LeanDojo y Lean Workbook muestran que la mejora se debe principalmente a fallos de ejecución poco profundos, a costa de un mayor tiempo de búsqueda.
16 noviembre 2026
Método Genesis Steering: control de activaciones en los datos utilizados durante el ajuste fino
El método extrae un vector de control a partir de ejemplos contrastivos presentes en los datos de ajuste fino y, si estos no están disponibles, selecciona posibles muestras de entrenamiento mediante inferencia de pertenencia y crea un conjunto proxy. La parte teórica describe el desplazamiento óptimo hacia el límite de decisión y la evaluación con datos proxy; empíricamente, los datos internos de Tülu-3-8B producen un efecto más pronunciado que los conjuntos externos, mientras que la utilidad del proxy MIA en Llama-3.1-8B-Instruct está limitada por la relación entre los desplazamientos de dirección.
16 noviembre 2026