
Método Genesis Steering: control de activaciones en los datos utilizados durante el ajuste fino
El método extrae un vector de control a partir de ejemplos contrastivos presentes en los datos de ajuste fino y, si estos no están disponibles, selecciona posibles muestras de entrenamiento mediante inferencia de pertenencia y crea un conjunto proxy. La parte teórica describe el desplazamiento óptimo hacia el límite de decisión y la evaluación con datos proxy; empíricamente, los datos internos de Tülu-3-8B producen un efecto más pronunciado que los conjuntos externos, mientras que la utilidad del proxy MIA en Llama-3.1-8B-Instruct está limitada por la relación entre los desplazamientos de dirección.
Qué es Genesis Steering
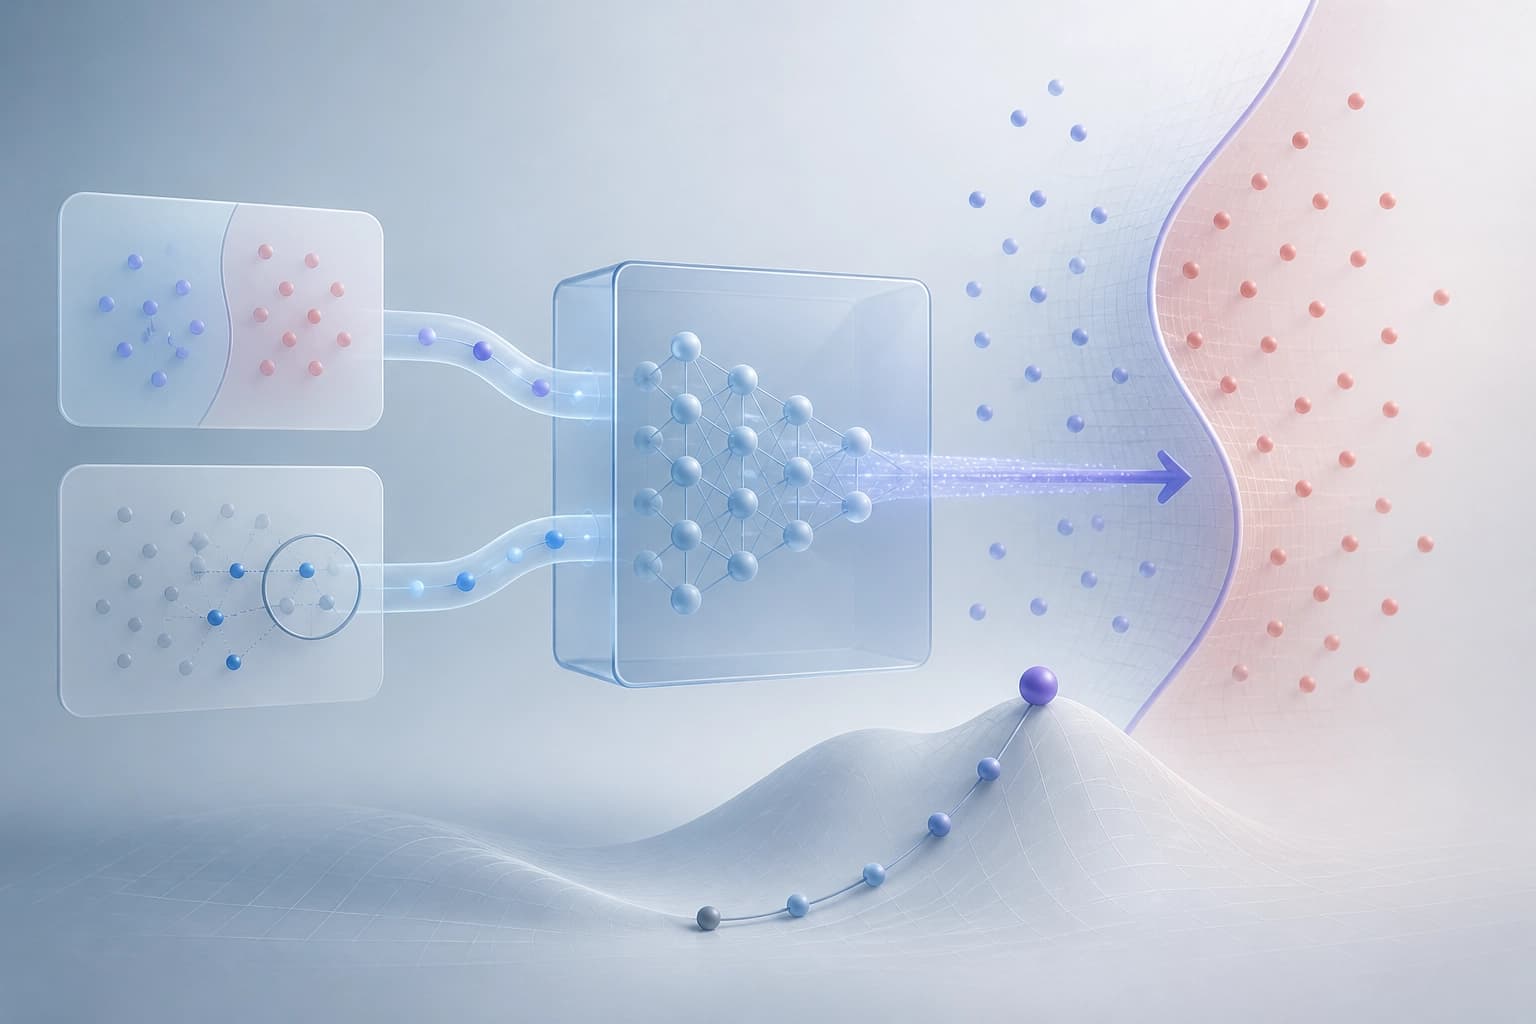
El steering de activaciones controla los modelos de lenguaje grandes durante la inferencia. La eficacia del método depende de la elección de los datos de referencia. Genesis steering construye un vector genesis a partir de ejemplos contrastivos de los propios datos de ajuste fino del modelo.
Si estos datos no están disponibles, el método utiliza enfoques de la literatura sobre inferencia de pertenencia. Estos enfoques encuentran ejemplos de entrenamiento probables y crean un conjunto de datos proxy.
El artículo «Genesis Steering: Better Activation Steering Through Training Data» se presentó el 13 oct 2026 (v1). La actualización es del 19 oct 2026 (v2). Autores: Tora Bodin, Eric Aubinais, Ilaria Torre, Chih-Hong Cheng.
Conclusión: Genesis steering vincula el steering a los datos de ajuste fino. El parámetro clave es la fuente de los ejemplos contrastivos.
Cómo se construye el vector genesis
El método toma ejemplos contrastivos de los datos de ajuste fino. A partir de ellos, se construye un vector de dirección. Este vector se aplica al modelo durante la inferencia.
Los autores establecen dos resultados teóricos. El primero trata sobre el sesgo óptimo hacia el límite de decisión. El segundo, sobre la reducción del sesgo al hacer estimaciones con datos proxy.
Conclusión: la teoría establece pautas para el sesgo. La calidad del vector depende de la elección de los ejemplos contrastivos.
Datos proxy mediante inferencia de pertenencia
Cuando los datos de ajuste fino no están disponibles, el método recurre a la inferencia de pertenencia. Este enfoque busca ejemplos de entrenamiento probables. Con los ejemplos encontrados, se crea un conjunto de datos proxy.
El conjunto de datos proxy sustituye a los datos originales al construir el vector genesis. El método utiliza los ejemplos encontrados como referencia. La diferencia está en la fuente de los ejemplos.
Conclusión: el conjunto de datos proxy amplía la aplicabilidad del método. El criterio para aplicarlo es la falta de acceso a los datos de ajuste fino.
Qué mostraron las evaluaciones en los modelos
Las evaluaciones se realizaron en Tülu-3-8B y Llama-3.1-8B-Instruct. Los datos de ajuste fino de Tülu-3-8B están disponibles públicamente. Llama-3.1-8B-Instruct se utilizó como modelo de control.
Los datos de seguridad de la mezcla de entrenamiento de Tülu-3-8B produjeron un steering más fuerte que los conjuntos de datos externos. Esto se cumple para ambos modelos.
En Tülu-3-8B, las puntuaciones de pertenencia coincidieron en gran medida al identificar ejemplos de entrenamiento. Los vectores basados en los ejemplos con las puntuaciones más altas dieron resultados comparables a los de submuestras aleatorias del mismo tamaño.
Los resultados en Llama-3.1-8B-Instruct establecen una condición para la MIA. El método solo tendrá un efecto positivo si el desplazamiento medio de dirección de los datos intradominio filtrados por MIA es significativamente menor que el desplazamiento de los datos OoD.
Conclusión: los propios datos de ajuste fino producen un steering más fuerte que los conjuntos de datos externos. La MIA requiere comprobar la condición relativa al desplazamiento de dirección.
Criterios prácticos de selección
La elección del método depende del acceso a los datos de ajuste fino. La tabla siguiente relaciona la situación, la acción y la comprobación.
| Situación | Acción | Comprobación |
|---|---|---|
| Los datos de ajuste fino están disponibles | Construcción del vector genesis a partir de ejemplos contrastivos de esos datos | Comparación con conjuntos de datos externos |
| Los datos no están disponibles | Búsqueda de ejemplos de entrenamiento probables mediante inferencia de pertenencia y creación de un conjunto de datos proxy | Comprobación de la condición relativa al desplazamiento medio de dirección |
| Se ha creado un conjunto de datos proxy | Construcción de vectores a partir de los ejemplos con las puntuaciones más altas | Comparación con submuestras aleatorias del mismo tamaño |
Conclusión: Genesis steering se elige según la disponibilidad de los datos de ajuste fino. Para el conjunto de datos proxy, se comprueba la condición relativa al desplazamiento y se compara con submuestras aleatorias.
Preguntas frecuentes
Material similar
Todos los materiales
Aprendizaje en contexto de datos tabulares con expertos dispersos: OrionMoE-Small-v1.0, un modelo compacto
Se presenta un modelo básico y compacto para tareas tabulares que predice nuevas observaciones a partir de una tabla de referencia etiquetada, sin ajustar parámetros adicionales. La selección adaptativa de expertos en función del conjunto de datos y de las representaciones de características ofrece resultados competitivos, especialmente con poco contexto y alta dimensionalidad.
15 noviembre 2026
Búsqueda local de cambios en las covariables para perfiles con predicciones poco fiables
El artículo describe un flujo de diagnóstico que primero identifica grupos de pacientes interpretables en los que el modelo tiene poca confianza y, después, comprueba si existe un cambio perjudicial de covariables dentro de esos grupos. En los experimentos con MIMIC-IV, tres tareas clínicas y tres cambios artificiales en subgrupos, el enfoque permitió localizar un cambio relacionado con la edad que apenas se apreciaba en la evaluación agregada.
15 noviembre 2026
FedPix: transmisión de imágenes comprimidas desde el cliente para reducir las filtraciones en el aprendizaje federado
El artículo analiza qué información debe permitirse que el cliente envíe al servidor y propone entrenar la transmisión de imágenes compactas y verificables visualmente, en lugar de pesos del modelo o representaciones intermedias. En BloodMNIST, CIFAR-10, FashionMNIST y MNIST, el método obtiene un PSNR bajo en la reconstrucción y reduce el tiempo en el cliente hasta un 96,0%, con una precisión del 65,63–99,18%.
15 noviembre 2026