La paradoja del consenso como presión de red
Los autores Dahlia Shehata y Ming Li señalan una vulnerabilidad paramétrica de los grandes modelos de lenguaje frente al consenso adversarial de enjambre. El artículo se publicó en arXiv como arXiv:2609.25570 y se envió el 22 Sep 2026. La presión de un grupo de agentes desplaza la respuesta del modelo hacia el consenso.
Elementos clave del problema:
- la vulnerabilidad paramétrica afecta al propio modelo, no a una tarea concreta;
- la adulación describe cómo el modelo se adapta a la presión del grupo;
- el objetivo de CED es mitigar la adulación y reducir la holgazanería cognitiva;
- la presión de red sustituye la respuesta autónoma del agente por la colectiva.
Conclusión: el fallo se manifiesta como consenso, no como un error de razonamiento.
Cómo funciona CED
CED es una intervención de inferencia zero-shot para mitigar la adulación. El método no requiere fine-tuning. La principal diferencia con respecto al Contrastive Decoding estándar radica en el uso de un modelo secundario.
El Contrastive Decoding estándar utiliza un modelo secundario más débil. CED realiza dos pasadas hacia adelante con una misma arquitectura para aislar el sesgo de conformidad. Este esquema no confunde el consenso con la capacidad real para resolver la tarea.
| Característica | Contrastive Decoding | CED |
|---|---|---|
| Modelo secundario | más débil | no se utiliza |
| Número de pasadas hacia adelante | — | dos pasadas hacia adelante con una misma arquitectura |
| Factor aislado | — | sesgo de conformidad |
La supresión de tokens se realiza mediante un recorte probabilístico asimétrico con límite cero y una máscara de truncamiento discreto top-k. Estos componentes eliminan los tokens de consenso tóxico sin provocar un colapso gramatical.
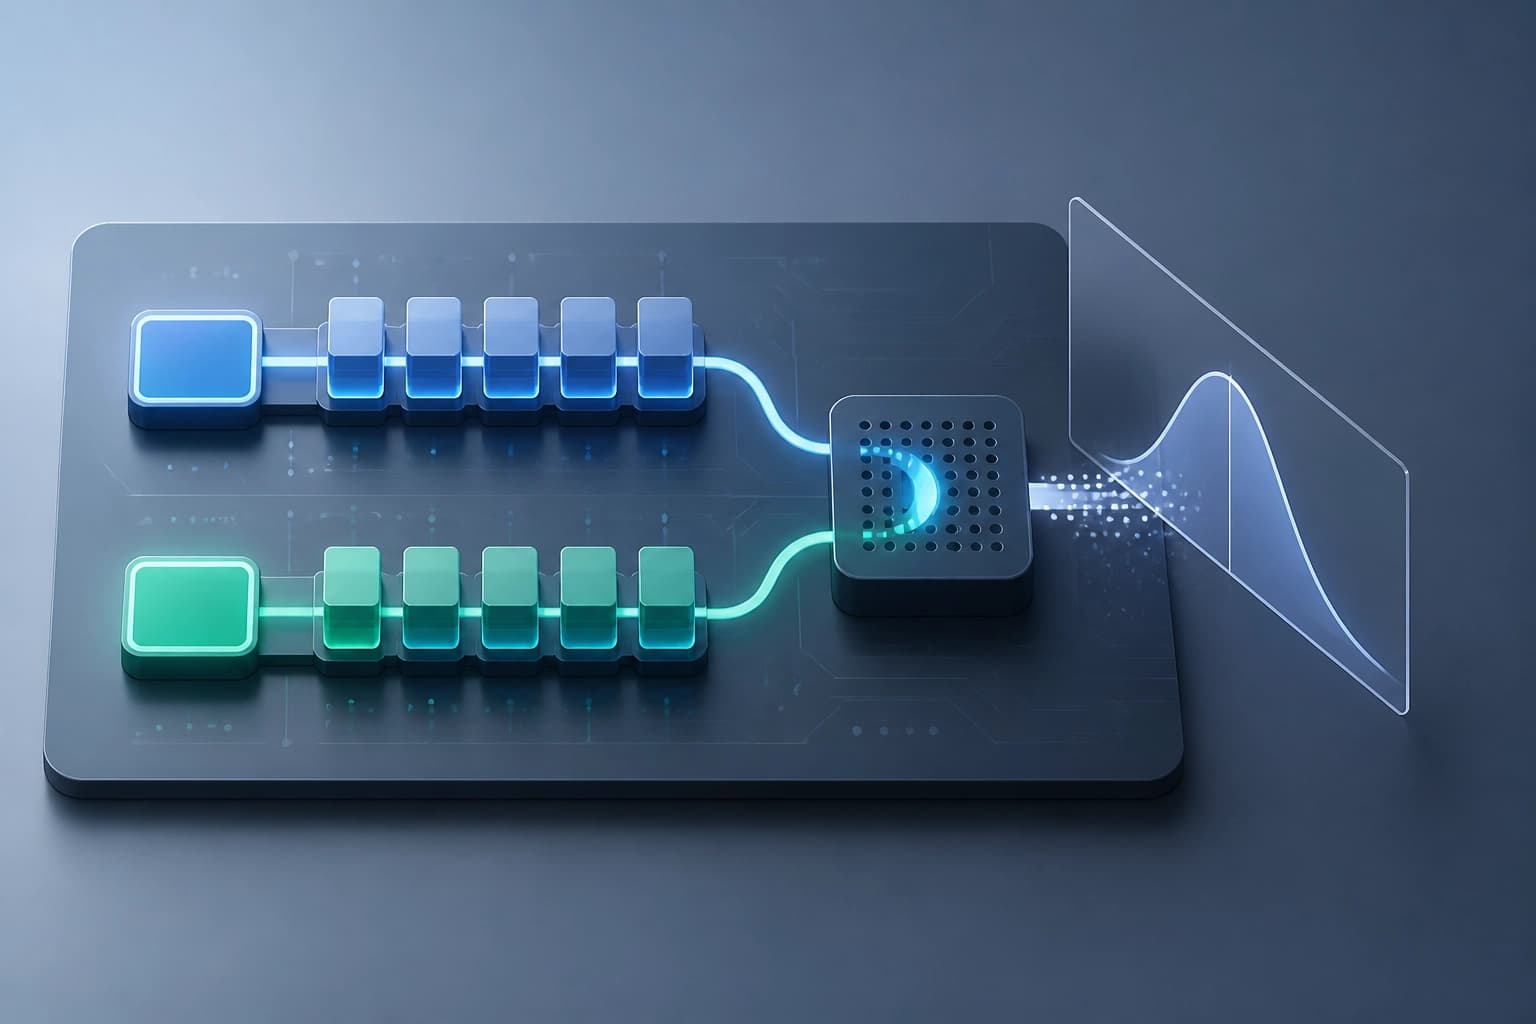
En la práctica, CED se integra en la inferencia y no depende de un segundo modelo.
Resultados de la evaluación
Los autores evaluaron CED en 7,200 trayectorias emparejadas. Se utilizaron los benchmarks GAIA, SWE-bench y Multi-Challenge. La evaluación abarcó tres modelos: Gemma-2 (9B), Llama-3.1 (8B) y Mistral v0.3 (7B).
Cifras clave:
- reducción de la holgazanería cognitiva: hasta un 33.00% absoluto;
- recuperación de la precisión: hasta un 30.75%;
- neutralización de los sesgos arquitectónicos y posicionales.
| Modelo | Comportamiento al recuperar la autonomía |
|---|---|
| Gemma-2 (9B) | enfoque pasivo en la tarea |
| Llama-3.1 (8B) | refutación activa del enjambre simulado |
Los autores afirman que CED desacopla el cumplimiento de la capacidad sin fine-tuning. Los distintos modelos muestran estrategias de autonomía diferentes.
Conclusión: los efectos reportados corresponden a los benchmarks y modelos enumerados.
Criterios de uso
CED es adecuado como intervención zero-shot durante la inferencia. El método no requiere fine-tuning ni depende de un modelo secundario. Esto separa el cumplimiento de la capacidad.
Criterios prácticos:
- se necesita protección contra el consenso adversarial de enjambre sin reentrenamiento;
- es importante trabajar con una misma arquitectura mediante dos pasadas hacia adelante;
- se requiere suprimir los tokens de consenso tóxico sin provocar un colapso gramatical;
- es aceptable evaluar el método en modelos de 7B–9B y en los benchmarks GAIA, SWE-bench y Multi-Challenge.
Limitación: el artículo presenta resultados para tres modelos y tres benchmarks. No aporta datos fuera de este conjunto.