
Neptuna: comparación de arquitecturas de ML en flujos multifásicos compresibles con discontinuidades
Se presenta Neptuna, un gran benchmark de 3 TB de cálculos para tareas de colapso de burbujas y fragmentación de gotas bajo el efecto de ondas de choque, en el que se evalúan modelos convolucionales, espectrales, transformers y modelos PDE preentrenados. Conclusión: no hay un líder universal, y las funciones de pérdida compuestas y SoftAdapt ayudan a conservar mejor las interfaces y a reproducir el espectro con mayor precisión.
Objetivo del benchmark
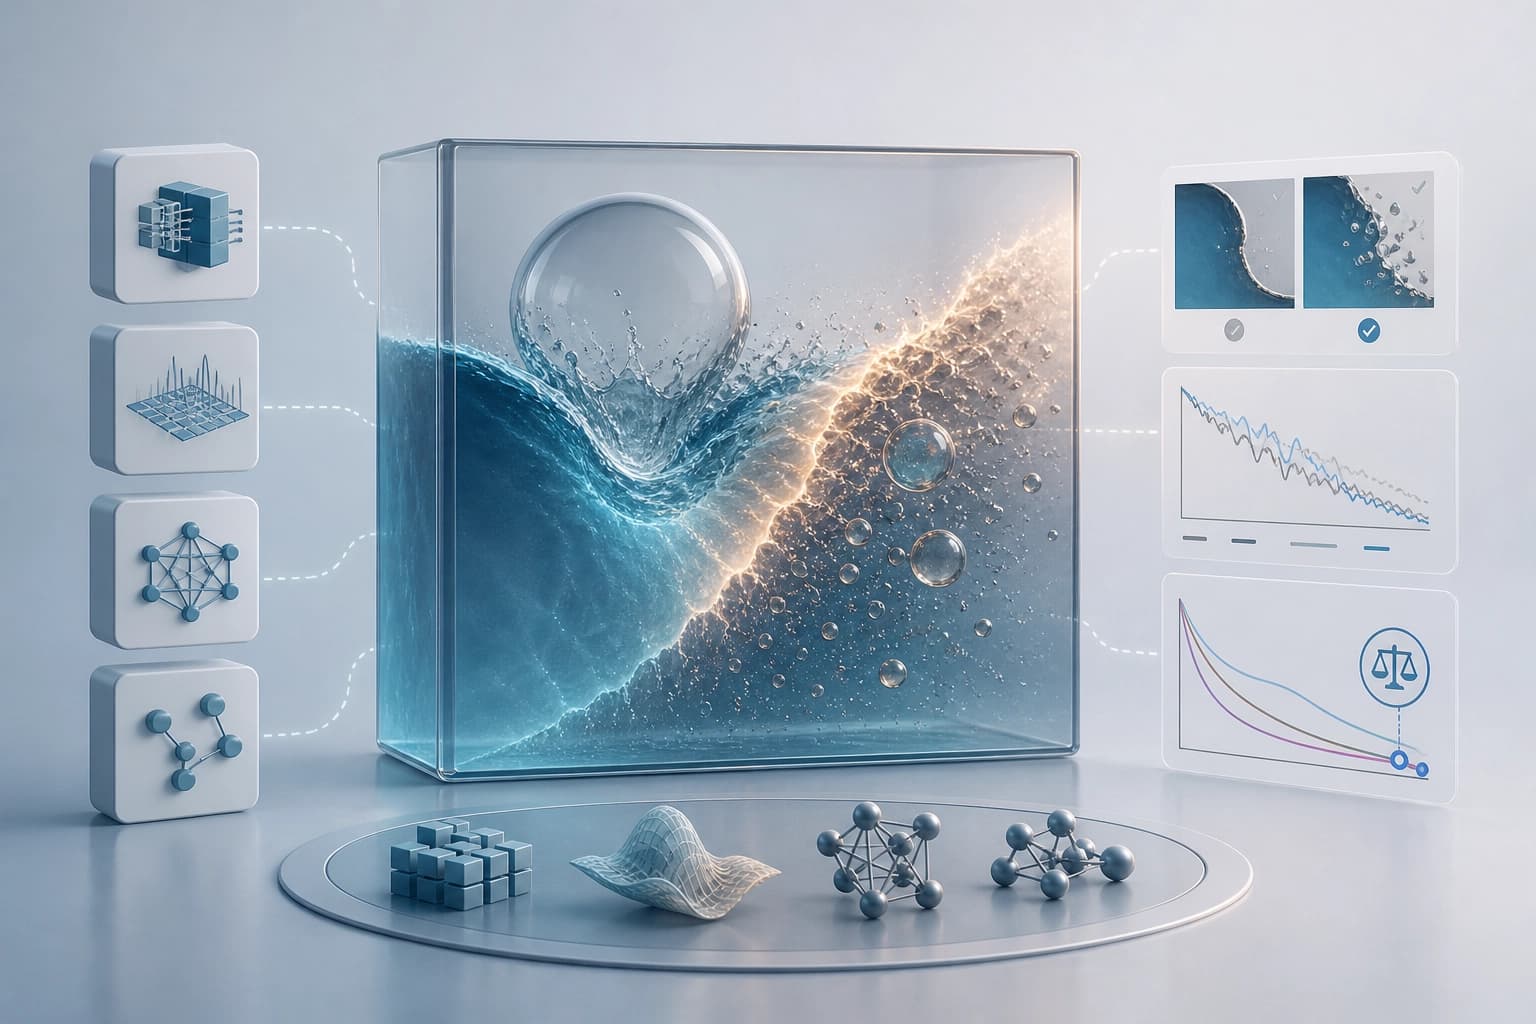
Neptuna es el primer benchmark a gran escala para flujos compresibles multifásicos impulsados por ondas de choque. Está diseñado para comparar modelos de ML con datos que contienen ondas de choque e interfaces entre materiales. El benchmark evalúa no solo una arquitectura, sino una combinación de arquitectura, función de pérdida y métricas.
| Componente de evaluación | Opciones |
|---|---|
| Arquitecturas | convolucionales, espectrales, transformers, modelos fundacionales de PDE |
| Funciones de pérdida | MSE, funciones compuestas, SoftAdapt, GradNorm |
| Métricas | puntuales, espectrales, orientadas a características, estructurales, basadas en la física |
Conclusión: el benchmark establece un entorno común para realizar comparaciones reproducibles. Criterio práctico: usarlo para comparar modelos con los mismos datos y métricas.
Datos y física
El benchmark incluye 3 TB de datos 2D y 3D de alta precisión. Los datos describen el colapso de burbujas y la fragmentación de gotas provocados por ondas de choque. Estos flujos presentan ondas de choque e interfaces entre materiales.
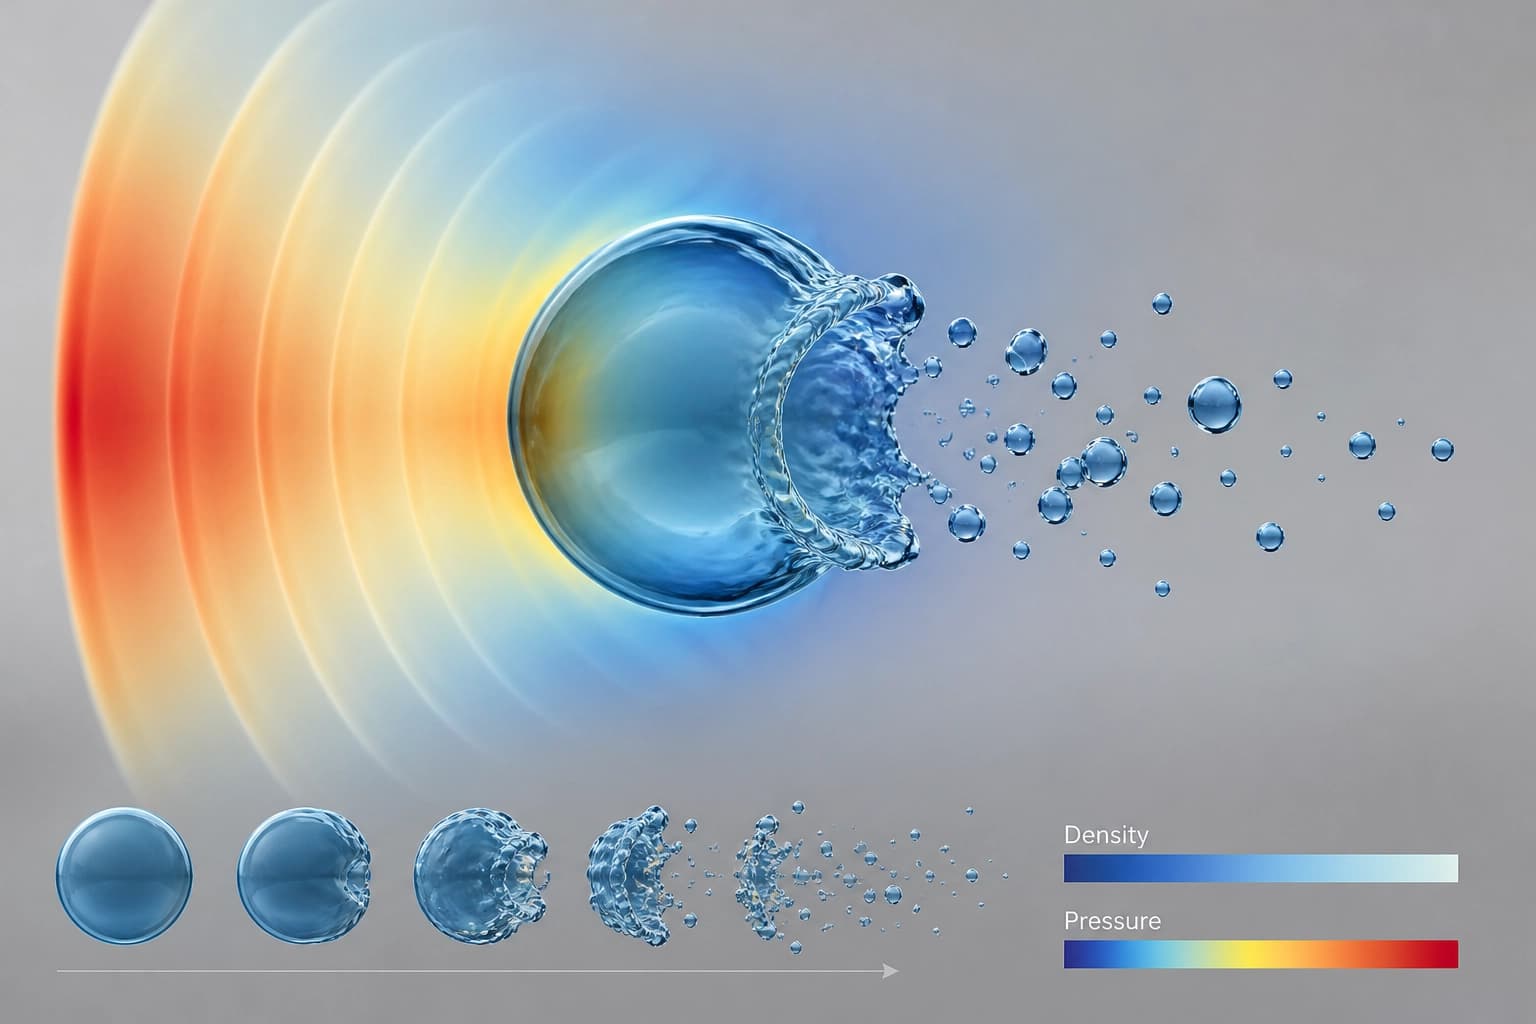
Las fuertes interacciones no lineales provocan una deformación compleja de las interfaces, mezcla y dinámica multiescala. Tres factores dificultan la construcción de modelos sustitutos fiables:
- compresibilidad;
- discontinuidades bruscas;
- efectos multifásicos.
Estos factores están presentes al mismo tiempo.
Conclusión: los datos ponen a prueba los modelos ante discontinuidades e interfaces. Criterio práctico: incluir en la evaluación escenarios con discontinuidades e interfaces.
Arquitecturas comparadas
En el benchmark se evaluaron modelos convolucionales, espectrales y basados en transformers. La evaluación también incluyó modelos fundacionales de PDE preentrenados. El benchmark pone a prueba estas familias con flujos compresibles multifásicos que presentan discontinuidades.
La comparación abarca distintas formas de construir un modelo sustituto. No se limita a una sola familia. Las arquitecturas se evalúan con los mismos datos y métricas.
Conclusión: la arquitectura se elige en función de la tarea, no del nombre de la familia. Criterio práctico: evaluar la arquitectura con el conjunto de datos en el que se utilizará.
Funciones de pérdida
El entrenamiento estándar del benchmark utiliza MSE. También se evaluaron funciones de pérdida compuestas. Estas combinan MSE con componentes de Sobolev, conscientes de las interfaces y conscientes de la estructura.
Para el balanceo adaptativo de las pérdidas se utilizaron SoftAdapt y GradNorm. El benchmark incluye ambas opciones.
| Opción | Composición |
|---|---|
| MSE | Función de pérdida básica |
| Funciones compuestas | MSE + Sobolev + consciente de las interfaces + consciente de la estructura |
| SoftAdapt | Balanceo adaptativo de las pérdidas |
| GradNorm | Balanceo adaptativo de las pérdidas |
Conclusión: la elección de la función de pérdida depende de la métrica objetivo. Criterio práctico: incluir SoftAdapt y GradNorm para evaluar el balanceo adaptativo.
Métricas de evaluación
La evaluación incluye cinco grupos de métricas:
- puntuales;
- espectrales;
- orientadas a características;
- estructurales;
- basadas en la física.
El conjunto de métricas es multidimensional. Conclusión: no se puede juzgar un modelo por una sola métrica. Criterio práctico: definir de antemano qué grupo de métricas es fundamental para la tarea.
Resultados de la comparación
Ningún modelo resultó ser el mejor en todos los conjuntos de datos y según todas las métricas. Este resultado abarca distintas arquitecturas y configuraciones. Las funciones de pérdida compuestas mejoran significativamente la conservación de las interfaces y la precisión espectral.
SoftAdapt ofrece las mejoras más consistentes prácticamente sin costes computacionales adicionales en comparación con el entrenamiento solo con MSE. GradNorm también se incluyó en la evaluación. No hay un ganador único en todos los indicadores.
| Qué se comparó | Conclusión |
|---|---|
| Arquitecturas | Ninguna es la mejor en todos los conjuntos y métricas |
| Funciones de pérdida compuestas | Mejoran la conservación de las interfaces y la precisión espectral |
| SoftAdapt | Mejoras más consistentes prácticamente sin costes adicionales |
Conclusión: la elección depende del conjunto de datos y de la métrica. Criterio práctico: determinar la métrica fundamental y, después, probar la función de pérdida y la arquitectura con el conjunto objetivo.
Estado y acceso
El trabajo sobre Neptuna ha sido aceptado en NeurIPS-2026 (Evaluations and Datasets Track). El artículo se presentó el 24 jul 2026 (v1); la última revisión es del 18 oct 2026 (v3). arXiv:2607.22280.
El repositorio del benchmark y el conjunto de datos están disponibles en this https URL. Esto permite reproducir la evaluación y comparar modelos con los resultados del benchmark.
Conclusión: el benchmark está disponible para realizar pruebas prácticas. Criterio práctico: utilizar el repositorio como base para una comparación reproducible.
Preguntas frecuentes
Material similar
Todos los materiales
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026
AffordanceWAM: las affordances como intermediarias entre la predicción de la escena y el control del manipulador
El trabajo describe un modelo generativo que predice simultáneamente futuras observaciones RGB, campos escalares, mapas de calor de affordances y comandos continuos para el robot, utilizando videos de personas para ampliar la diversidad de interacciones sin anotaciones de acciones ni retargeting. En RoboCasa, CALVIN ABC→D y tareas reales, el enfoque ofrece mejoras consistentes frente a las líneas de base que utilizan solo RGB o solo datos robóticos.
9 noviembre 2026
Edición de presentaciones como operaciones controladas: el framework EditPPT y el benchmark DeckEdit-Bench
Los autores abordan la edición de diapositivas centrándose en objetos concretos, acciones permitidas y la verificación de que el contenido ajeno permanezca intacto, en lugar de generar código libremente. Para medir la calidad, crearon DeckEdit-Bench (183 tareas en 28 presentaciones creadas por personas), y el sistema multiagente EditPPT, probado con cinco modelos base, alcanza el éxito en el 66,7–74,9 % de las tareas, con una conservación superior al 97 %.
8 noviembre 2026