
AffordanceWAM: las affordances como intermediarias entre la predicción de la escena y el control del manipulador
El trabajo describe un modelo generativo que predice simultáneamente futuras observaciones RGB, campos escalares, mapas de calor de affordances y comandos continuos para el robot, utilizando videos de personas para ampliar la diversidad de interacciones sin anotaciones de acciones ni retargeting. En RoboCasa, CALVIN ABC→D y tareas reales, el enfoque ofrece mejoras consistentes frente a las líneas de base que utilizan solo RGB o solo datos robóticos.
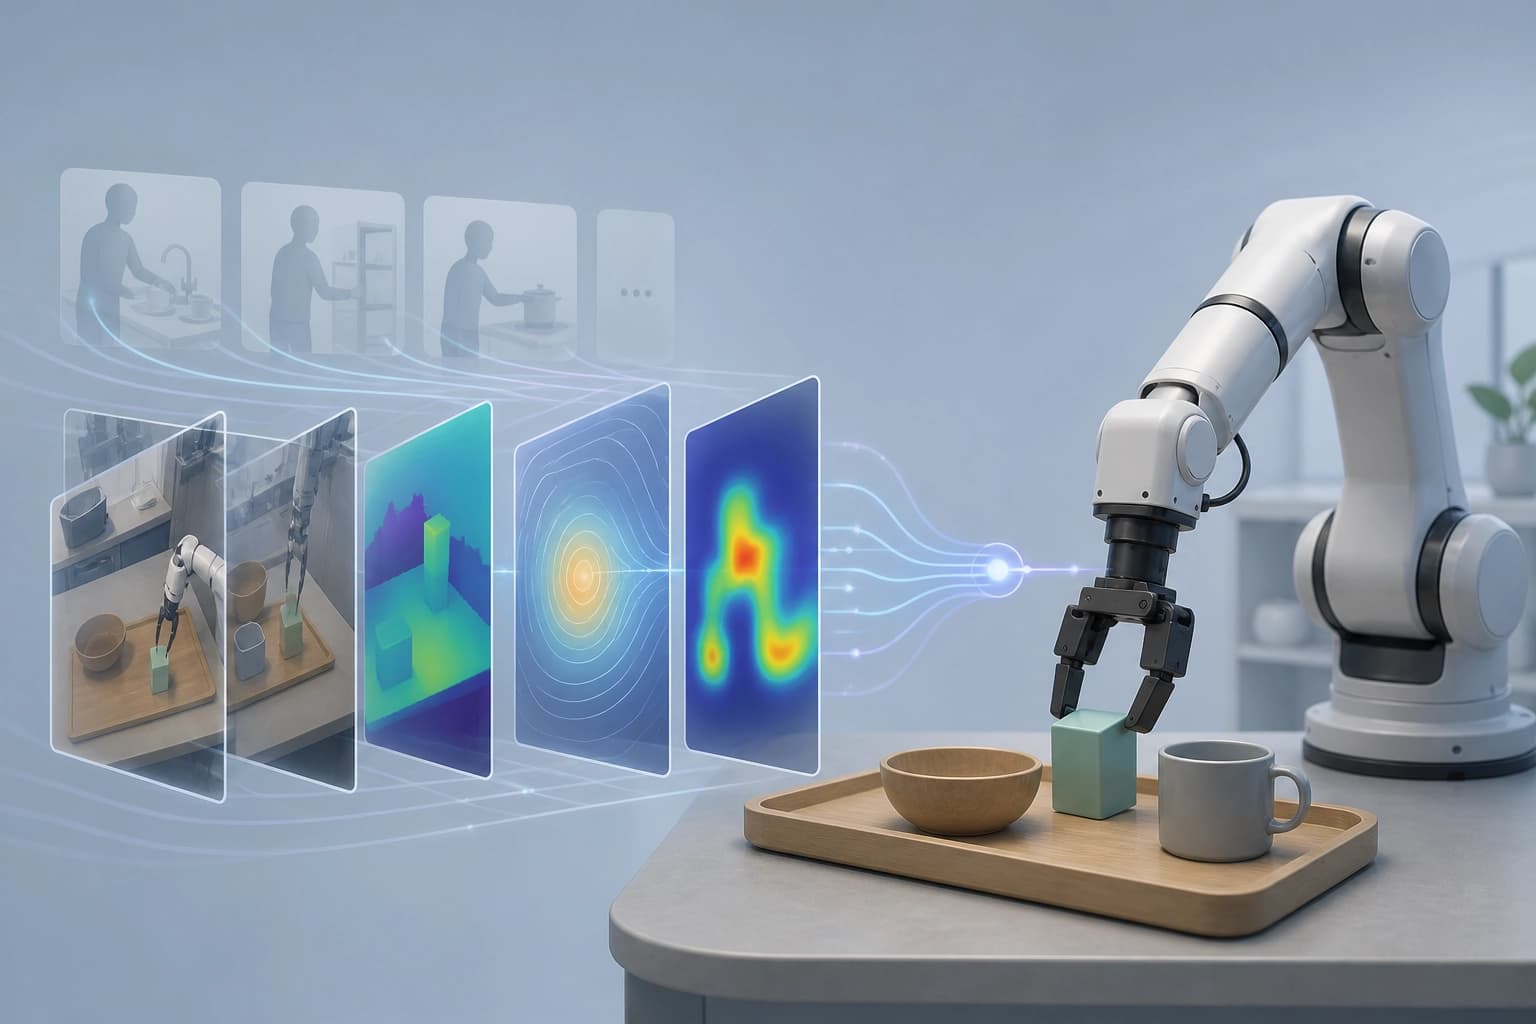
Qué representa el modelo
El artículo arXiv:2609.22332 presenta AffordanceWAM, un modelo generativo World Action Model que tiene en cuenta las affordances para la manipulación robótica. La primera versión se envió el 16 de septiembre de 2026. La última versión indicada es la v3, revisada el 18 de octubre de 2026. El modelo representa affordances espaciotemporales centradas en objetos. Utiliza dos formatos:
- Scalar Affordance;
- Affordance Heatmap.
Estas representaciones forman parte del mundo futuro generado. Las affordances vinculan la predicción visual con los objetos relevantes para la tarea y las áreas de interacción. Sirven como base común para las interacciones en vídeos de personas y robots. Así, las affordances actúan como intermediarias entre la predicción de la escena y el control del manipulador.
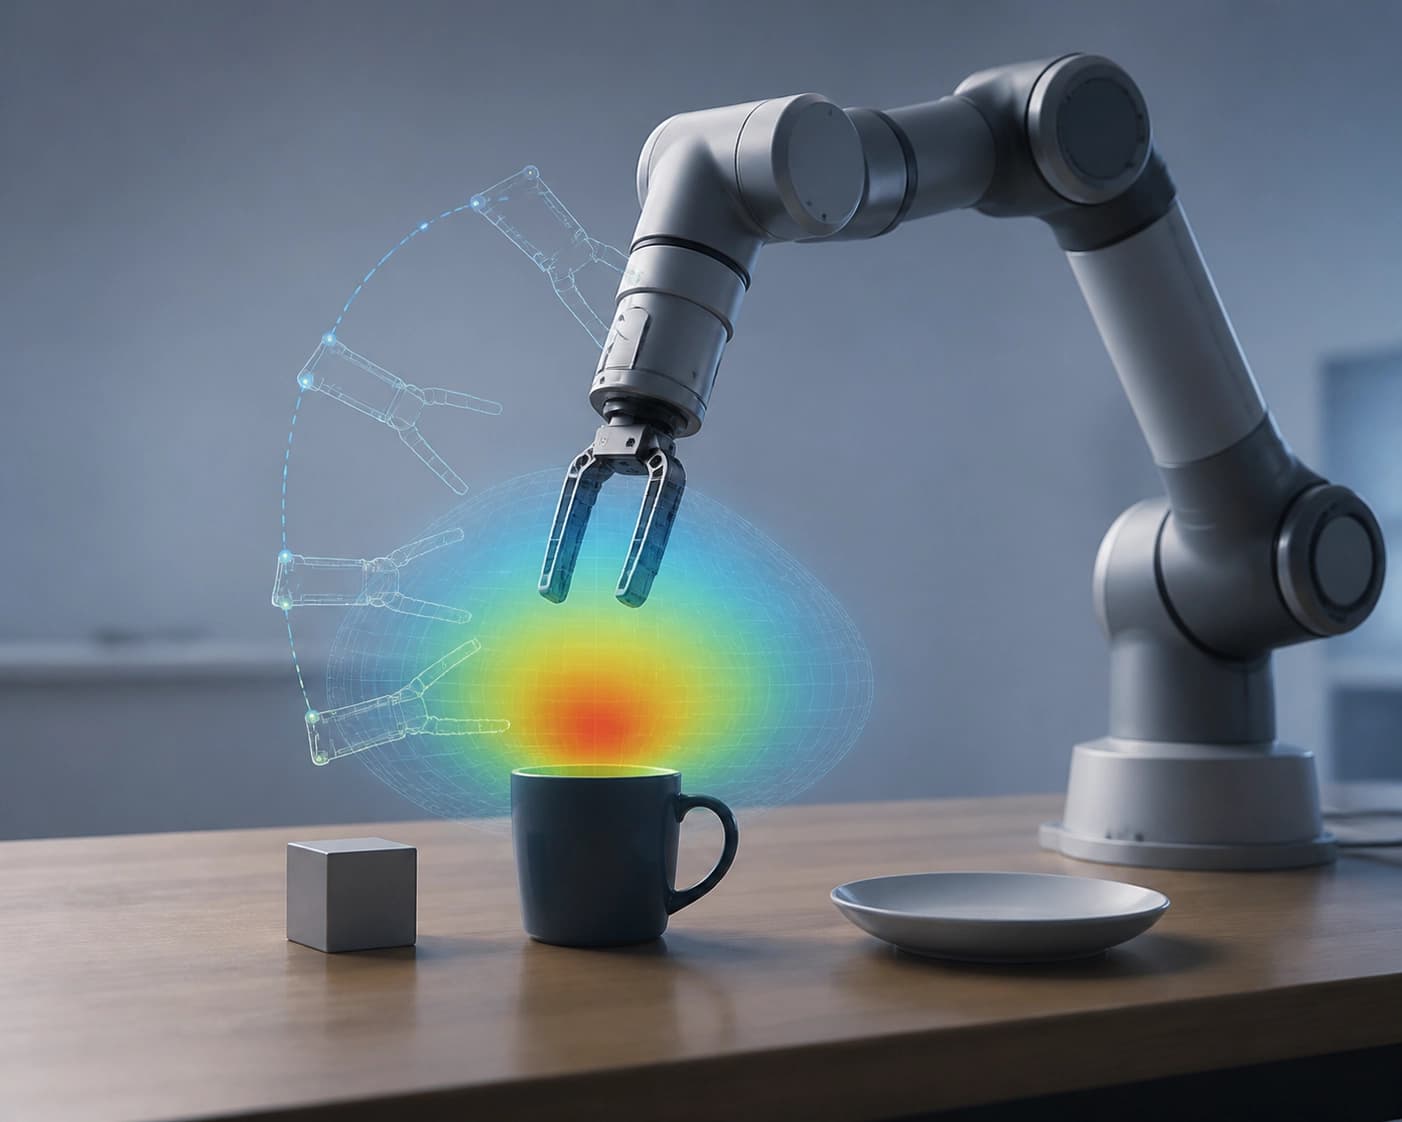
Conclusión: el modelo ofrece un formato explícito para los objetos y las áreas de acción. Este formato vincula la predicción del futuro con el control.
Arquitectura: dos expertos y un objetivo común
AffordanceWAM se basa en un Transformer de difusión de vídeo preentrenado. El modelo utiliza un World Expert y un Action Expert con parámetros independientes. Ambos están conectados mediante Masked Joint Self-Attention.
| Elemento | Función según la descripción del artículo |
|---|---|
| World Expert | experto del mundo con parámetros independientes |
| Action Expert | experto en acciones con parámetros independientes |
| Masked Joint Self-Attention | conecta World Expert y Action Expert |
| Objetivo común de flow matching | unifica la predicción de RGB, affordances y acciones |
El modelo predice conjuntamente observaciones RGB futuras, campos Scalar Affordance, Affordance Heatmaps y acciones robóticas continuas. Todos estos resultados se unifican mediante un objetivo común de flow matching. Los parámetros independientes de los expertos no impiden el entrenamiento conjunto. Su conexión permite la predicción conjunta del mundo y la acción.
Conclusión: la arquitectura separa los parámetros del mundo y de las acciones. Al mismo tiempo, Masked Joint Self-Attention y el objetivo común mantienen la predicción conjunta.
Entrenamiento con vídeos de personas y trayectorias robóticas
El entrenamiento de AffordanceWAM utiliza vídeos de personas para los tres flujos del mundo futuro. Las trayectorias robóticas aportan, además, supervisión de las acciones. La transferencia no requiere etiquetas de acciones humanas ni retargeting.
| Fuente de datos | Aporte al entrenamiento |
|---|---|
| Vídeos de personas | entrenan los tres flujos del mundo futuro |
| Trayectorias robóticas | aportan, además, supervisión de las acciones |
Las affordances sirven como base común para las interacciones en vídeos de personas y robots. Por eso, se pueden utilizar vídeos de personas sin etiquetas de acciones humanas. Los autores describen la affordance como una interfaz eficaz para la visión-lenguaje-acción y la transferencia de habilidades de personas a robots.
Conclusión: las affordances ofrecen una interfaz común para los vídeos de personas y robots. Esto elimina la necesidad de etiquetas de acciones humanas y de retargeting.
Experimentos: mejoras y dependencia de los datos
Los autores evaluaron AffordanceWAM en RoboCasa, CALVIN ABC→D y en tareas de manipulación reales. Los experimentos muestran mejoras constantes respecto a los métodos de referencia. Estos métodos utilizan solo RGB o solo datos robóticos.
En RoboCasa, los resultados mejoran de forma monótona a medida que aumenta el volumen de vídeos de personas anotados con affordances. Esto ocurre con un volumen fijo de supervisión robótica. Este efecto indica la contribución de las affordances al entrenamiento.
| Condición | Resultado según el artículo |
|---|---|
| Referencia basada solo en RGB | mejora constante de AffordanceWAM |
| Referencia basada solo en datos robóticos | mejora constante de AffordanceWAM |
| Más vídeos de personas con affordances, con supervisión robótica fija | mejora monótona en RoboCasa |
Un criterio práctico de selección es el volumen de vídeos de personas anotados con affordances. Con una cantidad fija de supervisión robótica, el aumento de ese volumen mejora de forma monótona los resultados en RoboCasa.
Preguntas frecuentes
Material similar
Todos los materiales
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026
Edición de presentaciones como operaciones controladas: el framework EditPPT y el benchmark DeckEdit-Bench
Los autores abordan la edición de diapositivas centrándose en objetos concretos, acciones permitidas y la verificación de que el contenido ajeno permanezca intacto, en lugar de generar código libremente. Para medir la calidad, crearon DeckEdit-Bench (183 tareas en 28 presentaciones creadas por personas), y el sistema multiagente EditPPT, probado con cinco modelos base, alcanza el éxito en el 66,7–74,9 % de las tareas, con una conservación superior al 97 %.
8 noviembre 2026
Geometría no euclidiana de factores: mapa FactoMap para separar representaciones
Se propone un método para describir el espacio de factores mediante regiones, identificaciones definidas por el generador y escalas locales, lo que permite distinguir casos topológicamente cercanos con geometrías diferentes. El método FactoMap aprende prototipos interpretables en una retícula estructurada y, en los experimentos, demuestra una conservación más robusta de la continuidad y la separación de los factores.
8 noviembre 2026