
Tareas verificables y entrenamiento adicional en trayectorias largas: cómo Navalia potencia a los agentes cooperativos de LLM
El trabajo describe un marco que, a partir de informes financieros corporativos, construye cadenas computacionales con evidencias trazables, las valida de forma independiente y luego las aplica a SFT y RL. Basada en Qwen3.6-35B-A3B, esta canalización mejora los resultados en cinco benchmarks y, según los autores, optimiza la vinculación de evidencias, el uso de herramientas y la ejecución de tareas prolongadas, incluidos los escenarios de oficina.
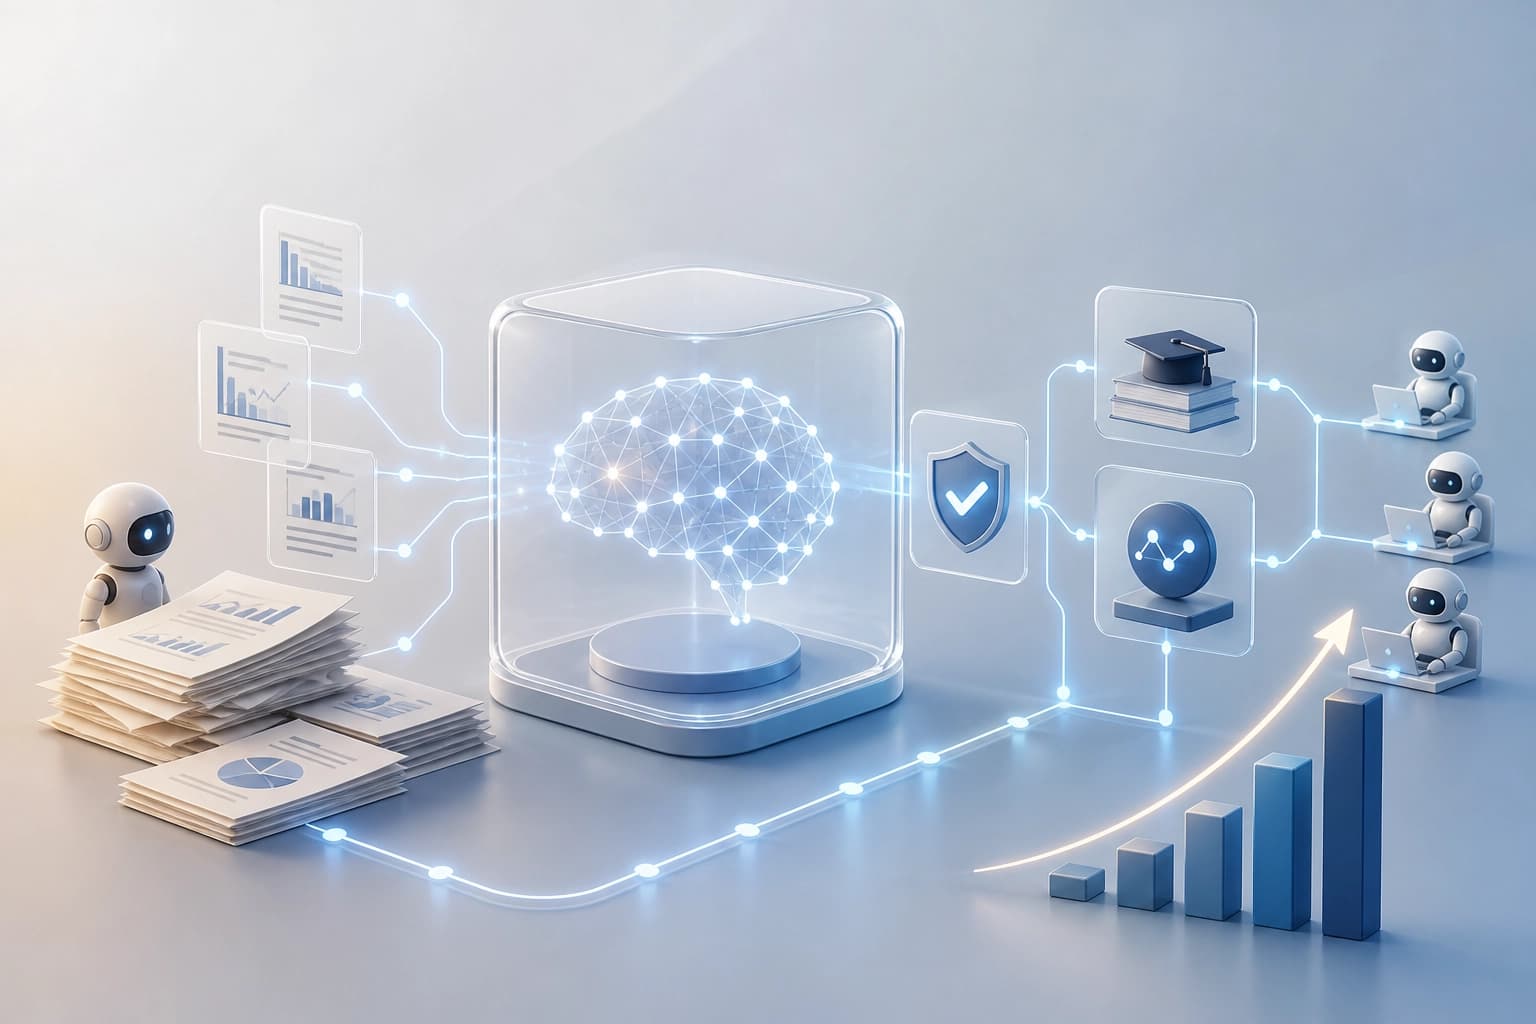
Problema que resuelve Navalia
Navalia es un framework para Cowork Agents. Combina la síntesis de tareas verificables con el postentrenamiento en horizontes largos. Para el análisis financiero, el framework utiliza informes financieros corporativos.
Navalia selecciona semánticamente evidencias que respaldan los resultados a partir de conjuntos completos de hechos. Después, construye cadenas de cálculo ejecutables. Así, el framework crea tareas analíticas con evidencias trazables y dependencias de datos reales entre los pasos.
Criterio práctico: una tarea es adecuada para la síntesis verificable si cuenta con evidencias trazables y dependencias entre pasos.
Verificación de evidencias y respuestas
La coherencia de las evidencias y la corrección de las respuestas se verifican mediante una revisión independiente con LLM y comprobaciones programáticas. Son dos circuitos de control distintos. El primero evalúa el aspecto semántico; el segundo, la corrección formal.
Criterio práctico: una tarea verificable requiere tanto una revisión con LLM como comprobaciones programáticas.
Postentrenamiento en trayectorias largas
Las tareas verificadas proporcionan material para recopilar trayectorias. Navalia aplica supervised fine-tuning desde cero y reinforcement learning. Ambas etapas mejoran la ejecución de tareas en horizontes largos.
El framework, inicializado con Qwen3.6-35B-A3B, muestra una mejora sostenida con respecto al modelo base. La mejora se observa en los cinco benchmarks. Los autores afirman que Navalia mejora la integración de evidencias, el uso de herramientas y la ejecución de tareas en horizontes largos.
Criterio práctico: el postentrenamiento tiene sentido cuando la tarea requiere una larga cadena de acciones y el uso de herramientas.
Benchmarks y transferencia de resultados
La evaluación de Navalia se realiza en cinco benchmarks: OfficeQA Pro, FinSearchComp, Finance Agent Benchmark, APEX-Agents-AA y Workspace-Bench-Lite. En los cinco, el framework muestra una mejora sostenida con respecto al modelo base.
Los autores afirman que los resultados se transfieren a escenarios Cowork más amplios, incluidas tareas generales de oficina. Criterio práctico: conviene observar si las habilidades se transfieren más allá del análisis financiero. Las tareas generales de oficina son un indicio de una aplicabilidad más amplia.
Preguntas frecuentes
Material similar
Todos los materiales
IA física: límites del concepto, herramientas y aspectos difíciles
La monografía, de 388 páginas, reúne en un marco unificado las definiciones de la IA física, sus diferencias con campos afines y sus métodos principales, desde la percepción y la simulación hasta el control y los sistemas multiagente coordinados. Ofrece un mapa de los desafíos de investigación y las limitaciones que dificultan pasar de soluciones especializadas a sistemas con una amplia capacidad de generalización.
17 noviembre 2026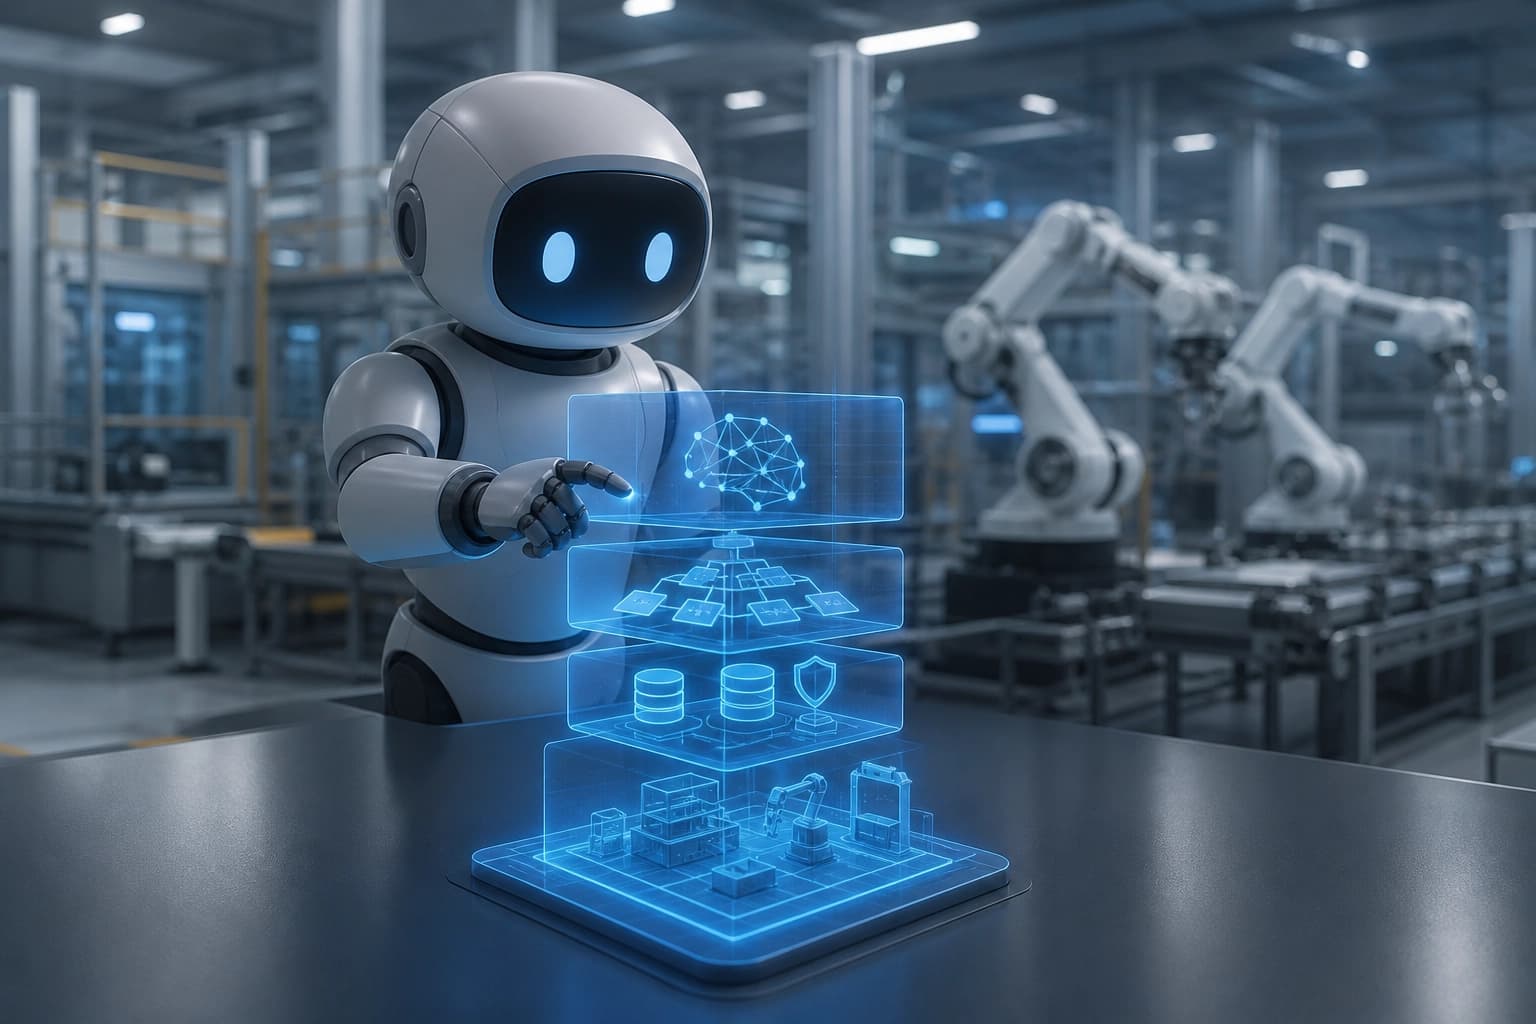
Agentes LLM en producción: taxonomía, arquitectura y limitaciones de implementación
El artículo organiza la investigación sobre la aplicación de modelos de lenguaje grandes en agentes de producción: identifica los obstáculos, los niveles de capacidad y una arquitectura de cuatro capas. Permite comprender qué escenarios del ciclo de vida ya se están estudiando y dónde persisten las brechas para una planificación autónoma fiable.
17 noviembre 2026
Enfoque OWP: redistribución de evidencias y señales a priori en Omni-LLM
Se presenta Omni-Woodpecker, un framework que no requiere entrenamiento, detecta conflictos entre modalidades y, antes de la decodificación, reajusta el equilibrio entre los datos del contexto y los priors memorizados en los estados ocultos. En Qwen2.5-Omni-7B y VideoLLaMA2-AV, el método mejora la resistencia a los errores audiovisuales en CMM y AVHBench, y ofrece una mejora moderada en benchmarks generales de razonamiento.
17 noviembre 2026