
NAQD-Env: suspensión selectiva de operaciones en agentes lingüísticos
Se ha publicado un banco de pruebas sintético en el que una referencia determinista define las dependencias entre datos, permisos y restricciones, y los modelos deben detener solo los pasos afectados sin perder el resto del trabajo. Las pruebas de tres modelos abiertos revelaron una baja tasa de detención y la ausencia de reanudaciones correctas; el ajuste fino mejora la precisión de las decisiones, pero genera efectos secundarios.
La esencia de la suspensión selectiva
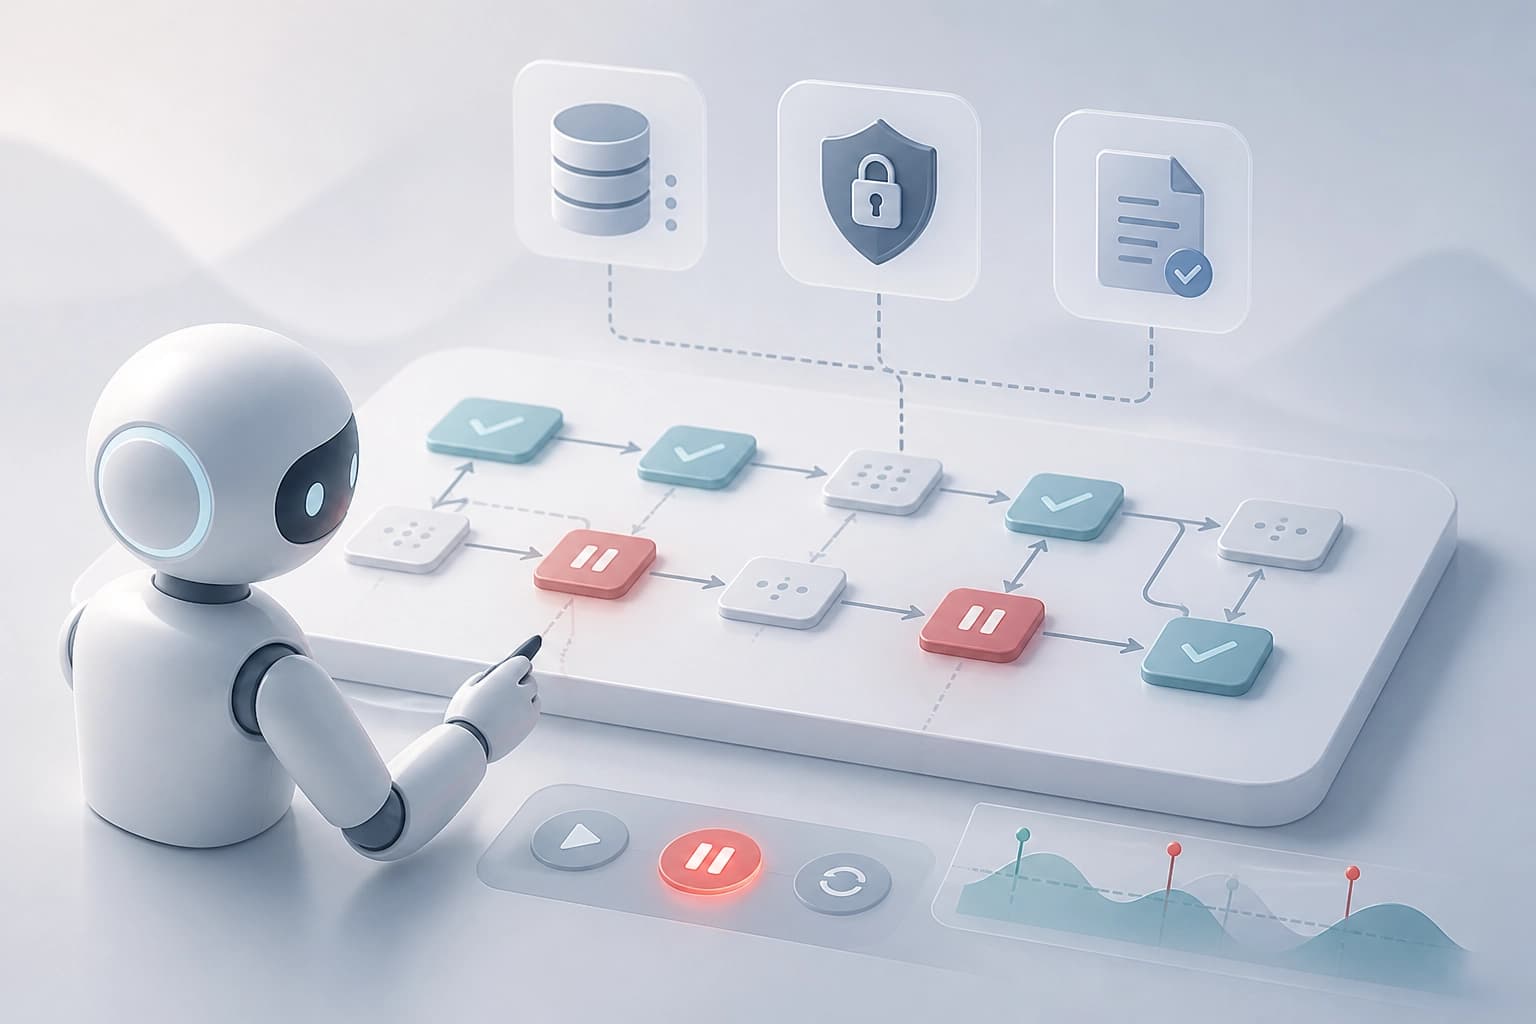
NAQD Env es un entorno sintético para evaluar las decisiones de los agentes lingüísticos sobre la interrupción selectiva de acciones. La política de referencia es determinista. Se basa en dependencias explícitas entre evidencias, permisos y restricciones. Cuando cambian las evidencias, se revoca un permiso o se recibe una instrucción de detenerse, el agente debe suspender las acciones afectadas. El agente conserva el trabajo no afectado. Solo reanuda las acciones tras una corrección suficiente. El criterio: el entorno evalúa la selectividad de la suspensión, no la detención completa.
Cómo funciona la evaluación
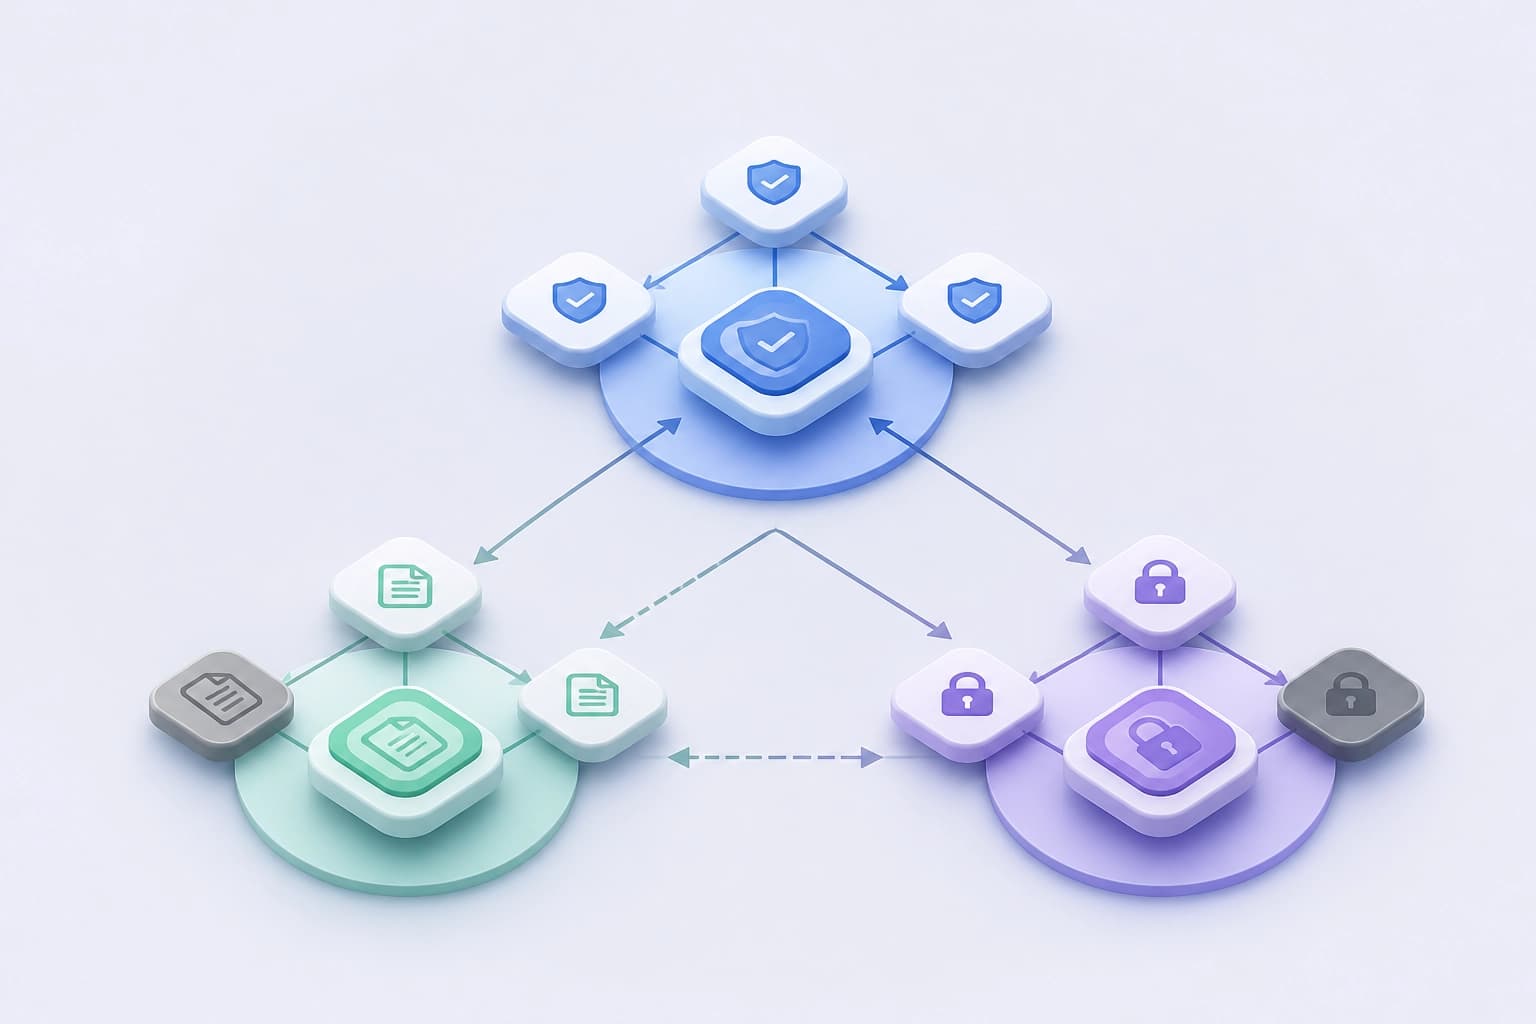
La evaluación utiliza 11 familias de dependencias. El conjunto incluye estructuras para el desarrollo, familias reservadas y combinaciones de estructuras reservadas. Las métricas contabilizan por separado los intentos de infracción y las infracciones cometidas por el mecanismo de ejecución simulado. Las métricas conjuntas reflejan la conformidad con la política, el valor de la tarea, la interrupción de acciones, la reanudación y la comunicación de eventos. Este conjunto distingue la intención de la infracción efectiva. También relaciona la seguridad con la utilidad y la comunicación. Criterio práctico: analizar todas las métricas en conjunto, no solo si se detienen las acciones.
Resultados en tres modelos
En el estudio se evaluaron tres modelos de pesos abiertos. Están ajustados para seguir instrucciones y pertenecen a dos familias. Se utilizaron tres condiciones de prompt y 350 escenarios fijos. En total, se obtuvieron 3 150 episodios «modelo—prompt» antes de volver a reproducirlos mediante el mecanismo de ejecución. En las condiciones analizadas, la exhaustividad de la interrupción de acciones no superó 0,06. No se observó ninguna reanudación correcta cuando se presentaron las condiciones adecuadas. Solo un episodio coincidió plenamente con la política de referencia.
Comparación de modelos con el prompt de NAQD:
| Modelo | Observación |
|---|---|
| Qwen2.5-7B | Menos episodios con intentos no seguros que Qwen2.5-3B y Llama-3.1-8B. Pero menos trabajo útil y menor precisión al conservar las acciones no afectadas. |
| Qwen2.5-3B | En las pruebas de ajuste fino controlado, la precisión de las decisiones aumentó de 0.45–0.54 a 0.83–0.92. |
| Llama-3.1-8B | En la comparación de intentos no seguros, queda por detrás de Qwen2.5-7B. |
Conclusión: incluso con un prompt especializado, los modelos rara vez siguen plenamente la política de referencia. La mejora de la seguridad puede reducir el trabajo útil. Criterio práctico: comprobar no solo los intentos de infracción, sino también la conservación de las acciones no afectadas.
Limitaciones del entorno y del ajuste fino
El entorno evalúa la aplicación de políticas con datos de entrada estructurados y confiables. No confirma la capacidad de contención real ni la verificación de fuentes. En las pruebas de investigación de ajuste fino controlado, aumentó la precisión de las decisiones de Qwen2.5-3B. Un diagnóstico aparte detectó interrupciones de acciones inapropiadas tras omisiones en el programa de entrenamiento. También mostró una disminución en la frecuencia de los informes de eventos. El trabajo de Mohamed Abouzahra se presentó el 29 de septiembre de 2026. Criterio práctico: el ajuste fino requiere verificar las detenciones inapropiadas y la calidad de los informes de eventos.
Conclusión práctica para la selección
NAQD Env mide la suspensión selectiva en condiciones controladas. El entorno trabaja con datos de entrada estructurados y confiables. No ofrece garantías de contención real ni de verificación de fuentes. Al elegir un agente, conviene tener en cuenta la exhaustividad de la interrupción, la corrección de la reanudación, la conservación del trabajo no afectado y los informes de eventos. El ajuste fino puede mejorar la precisión de las decisiones, pero conlleva el riesgo de detenciones inapropiadas y una menor comunicación. Criterio: utilizar el entorno como diagnóstico de políticas, no como prueba de fiabilidad en condiciones reales.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026