
Mensajes no confiables del agente anterior y sustitución de la respuesta correcta en LLM multiagente: un experimento controlado
En experimentos con cinco conjuntos de tareas y cinco agentes receptores, un mensaje poco fiable de un participante de nivel superior alteró la respuesta correcta de un participante de nivel inferior en hasta el 32 % de los episodios; en el 94 % de esos casos se observó una sustitución por una respuesta concreta e incorrecta. Los resultados indican que, al transmitir mensajes, es necesario evaluar la fiabilidad de la fuente y las pruebas de las que ya dispone el receptor.
Diseño del experimento
El estudio se publicó en arXiv el 29 de septiembre de 2026. Título: “Cuando los mensajes de agentes ascendentes anulan las respuestas correctas: un estudio controlado de la colaboración entre LLM multiagente”. Autores: Yaxin Gong, Gangyi Zhang, Chongming Gao, Leyang Shen, Chenxiao Fan, Jiakai Wang, Dong Wang, Yang Liu, Wenjie Wang, Xiangnan He.
El trabajo examina cómo influyen los mensajes de un agente ascendente en las respuestas de un agente descendente. Se realizaron experimentos controlados en cinco benchmarks y con cinco destinatarios. Parámetros clave:
- cinco benchmarks;
- cinco destinatarios;
- tarea invariable;
- pruebas invariables disponibles para el agente descendente.
Criterio práctico: evaluar el mensaje por separado de la tarea y las pruebas.
Tres condiciones
Se compararon tres condiciones. La tarea y las pruebas son las mismas en todas las condiciones. Solo cambia el mensaje.
| Condición | Qué recibe el agente descendente |
|---|---|
| Sin mensaje | La tarea y las pruebas disponibles |
| Con el mensaje original | El mensaje del agente ascendente |
| Con una conclusión opuesta | Un mensaje con una conclusión opuesta a la original |
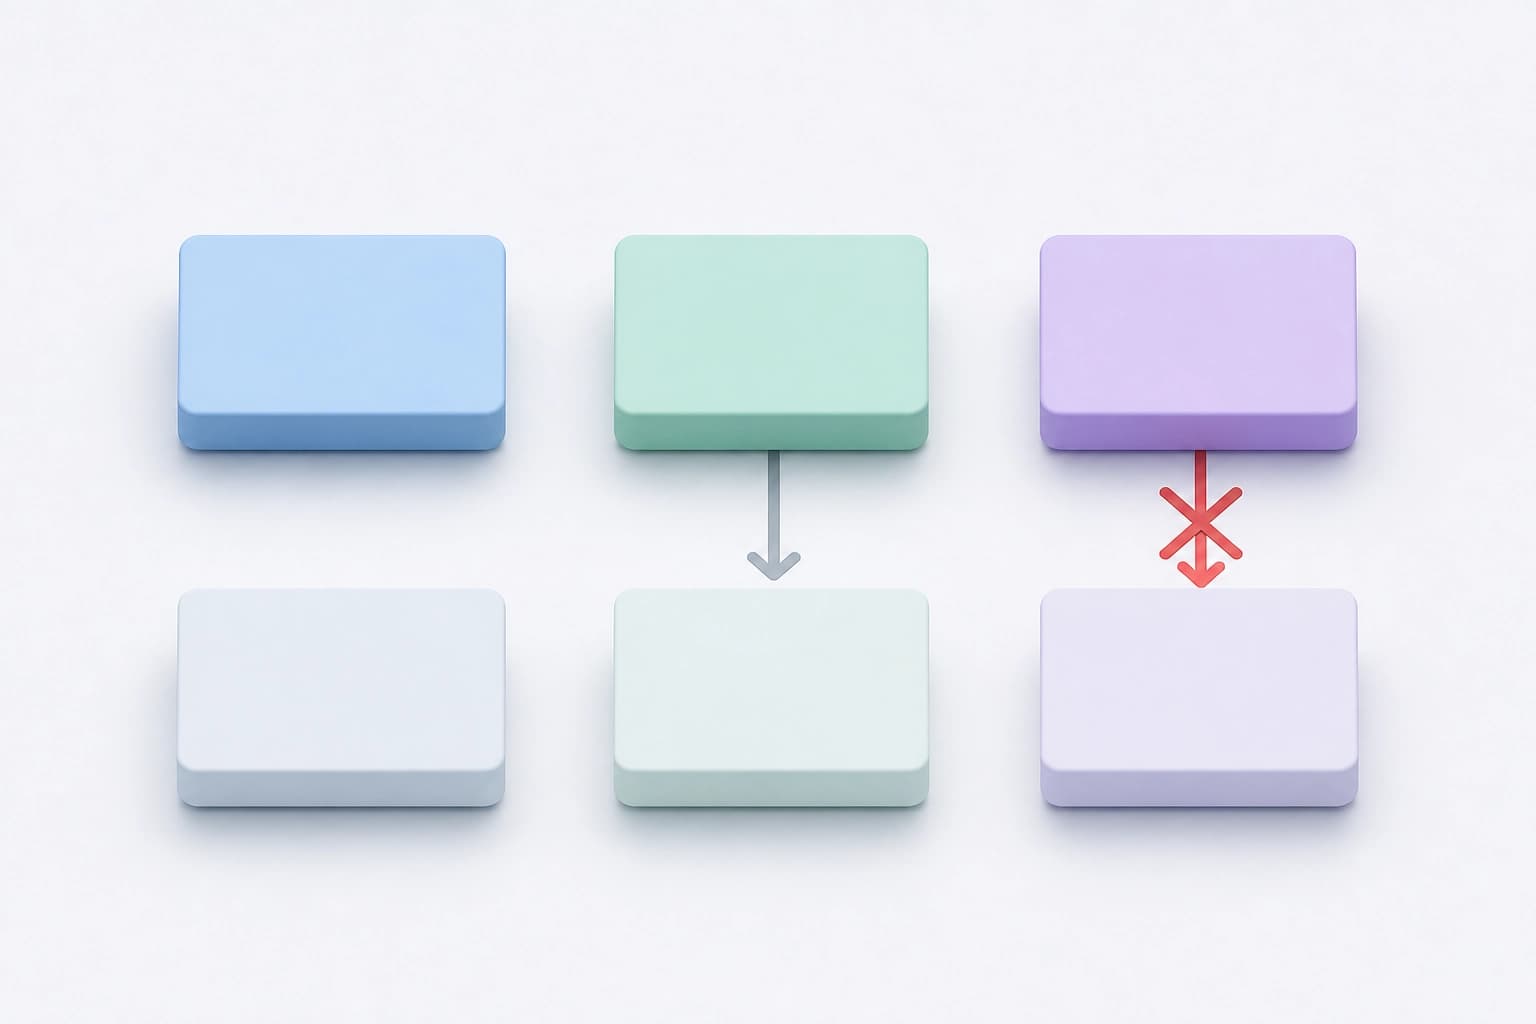
Este diseño separa el efecto del mensaje del efecto de la tarea. Criterio: considerar el mensaje como un factor independiente que se puede activar y desactivar.
Efecto positivo de los mensajes
Los mensajes suelen ayudar cuando, sin ellos, el agente descendente respondería incorrectamente. En este caso, el mensaje del agente ascendente respalda la respuesta correcta.
Criterio práctico: transmitir el mensaje cuando el agente descendente no disponga de pruebas suficientes para responder correctamente.
Sustitución de una respuesta correcta
Si, sin el mensaje, el agente descendente respondería correctamente, un mensaje incorrecto del agente ascendente cambiaba la respuesta en hasta el 32 % de los casos. Datos clave:
- hasta el 32 % de los casos en los que la respuesta sin mensaje era correcta;
- en el 94 % de los casos comprobados de influencia perjudicial, el agente descendente copiaba una respuesta incorrecta concreta del agente ascendente;
- los autores denominan a este fenómeno “sustitución de respuestas”.
Criterio: comprobar si el mensaje sustituye una conclusión correcta por una incorrecta concreta.
Eliminación de mensajes poco fiables
Eliminar los mensajes poco fiables recuperó parte de la precisión perdida. Esta medida reduce el daño, pero no restablece el nivel original.
Criterio práctico: filtrar los mensajes antes de transmitirlos, no después de responder.
Criterios para seleccionar mensajes
Los autores indican que la selección de los mensajes que se transmitirán debe tener en cuenta la fiabilidad del agente ascendente y las pruebas que ya tiene a su disposición el agente descendente. Por tanto, la fiabilidad del agente ascendente no es el único factor. Hay que contrastar el mensaje con lo que el agente descendente puede verificar por sí mismo.
- Fiabilidad del agente ascendente.
- Pruebas ya disponibles para el agente descendente.
- Coherencia del mensaje con esas pruebas.
Criterio: dar prioridad a los mensajes que concuerdan con las pruebas ya disponibles.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026