
La ciencia molecular lleva mucho tiempo considerándose una de las direcciones más prometedoras —y también de las más complejas— para la IA. A ella está dedicado precisamente el preprint arXiv:2608.23104 «Molecular LLM Agents: From Architectural Design to Scientific Autonomy»: 25 páginas, categorías cs.CL y cs.AI, versión v1 del 24 de agosto de 2026 y una v2 revisada del 25 de agosto. El equipo de autores lo forman Jiatong Li, Wengyu Zhang, Weida Wang, Yuxuan Ren, Wei Liu, Chenyang Mao, Yuqiang Li, Yatao Bian, Changmeng Zheng, Xiaoyong Wei y Qing Li. El trabajo resulta interesante no por otro récord en un benchmark, sino por su intento de poner orden en los términos: qué debe considerarse en realidad un agente molecular, de qué nodos se compone y hasta qué punto puede actuar de forma autónoma.
En qué se diferencia un agente molecular de uno «normal»
Los asistentes conversacionales y los agentes de código viven en el mundo del texto, los repositorios y las páginas web. Las herramientas con las que operan casi siempre aceptan y devuelven algo que se puede leer a simple vista. Con la química ese truco no funciona: una molécula no es un párrafo.
Un agente de dominio tiene que lidiar con varios tipos de datos incompatibles a la vez:
- notaciones simbólicas como SMILES —cadenas compactas donde un solo carácter erróneo convierte un candidato a fármaco en otra sustancia;
- grafos moleculares, donde importan no solo los átomos, sino también el orden de los enlaces, las cargas y la estereoquímica;
- conformaciones tridimensionales —porque las propiedades de una molécula se determinan por su forma, no solo por su fórmula;
- espectros y resultados de simulaciones —largas series numéricas de las que hay que extraer el significado;
- mediciones de laboratorio «húmedo», es decir, datos de experimentos reales con sustancias, no con un archivo.
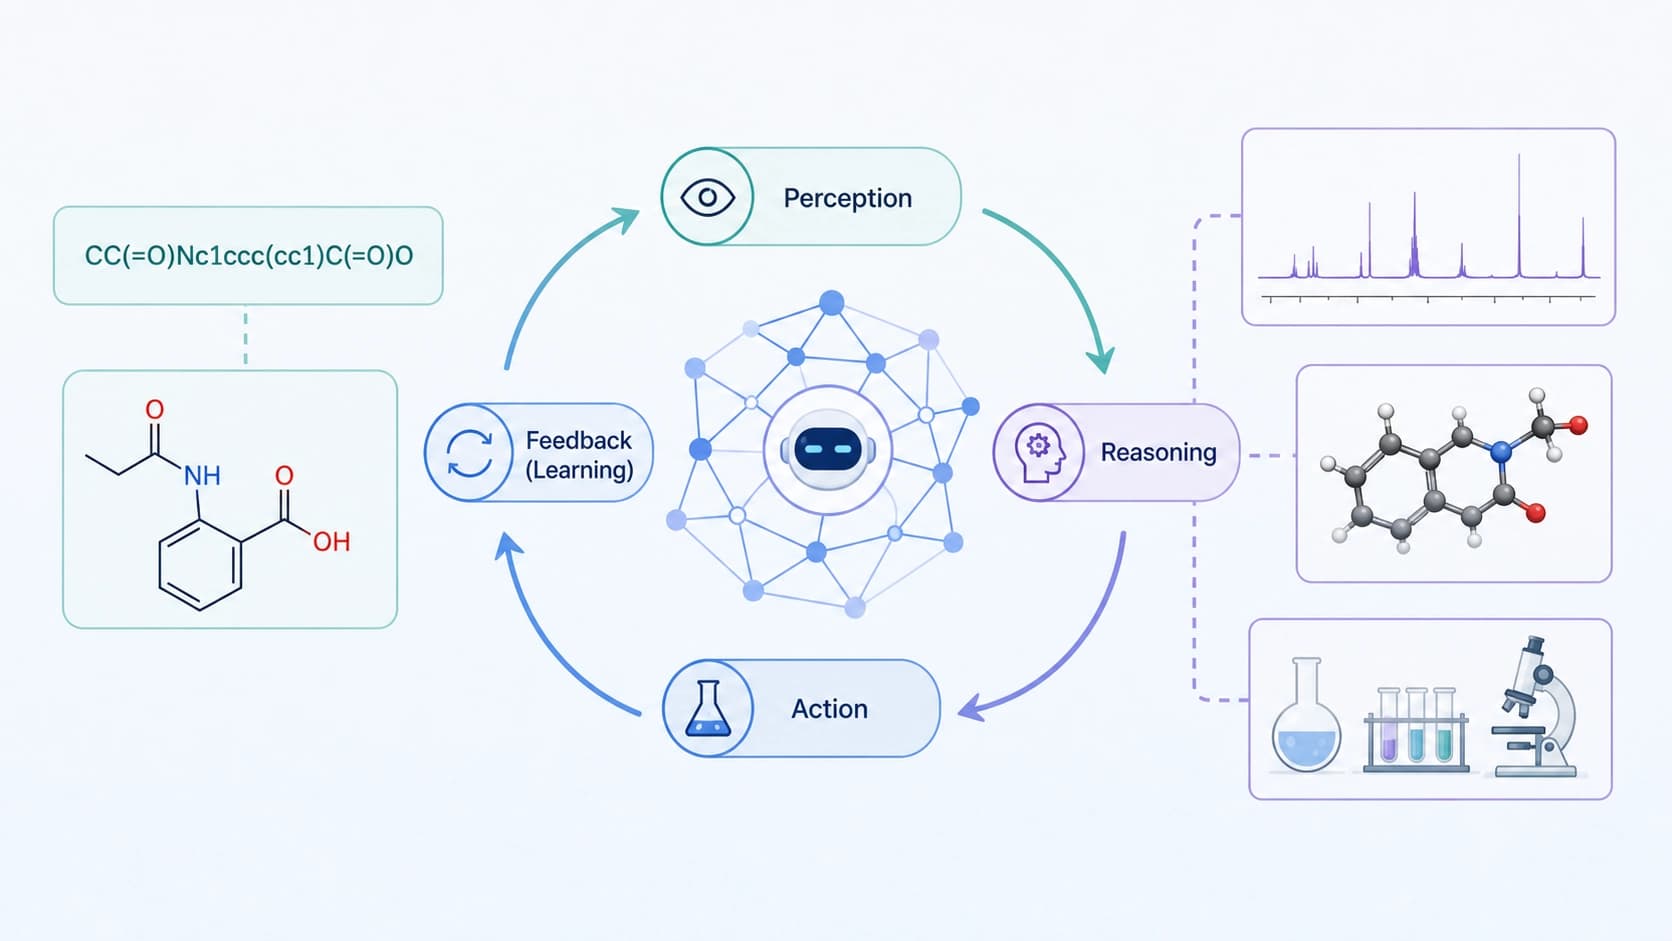
De ahí la idea principal de los autores: las capacidades de un agente así no se componen de un único modelo acertado, sino de varios pilares a la vez. Hace falta una percepción químicamente correcta de los objetos moleculares, un framework agéntico con un modelo de lenguaje en el centro, herramientas vinculadas a un dominio concreto, y también un canal de retroalimentación —computacional o experimental—. Por encima de todo eso se superpone la capacidad de planificar y de invocar la herramienta adecuada en el momento oportuno.
Una mirada arquitectónica: de qué se compone un agente molecular
La primera de las dos perspectivas del artículo es la de ingeniería. Los autores descomponen la construcción en cuatro capas y proponen mirar cualquier proyecto existente precisamente así.
Percepción: la molécula como objeto, no como párrafo
Los modelos de lenguaje se entrenan con texto, por lo que al principio ven una cadena SMILES como un conjunto de tokens y «alucinan» con facilidad valencias inexistentes. Aquí ayuda la combinación con modelos de dominio: por ejemplo, AlphaFold muestra cómo una arquitectura especializada resuelve una tarea molecular concreta con más precisión que una universal. Para un agente, esto significa algo sencillo: antes de razonar, debe saber validar —comprobar si la molécula existe en absoluto, si su grafo concuerda con la fórmula, si no se ha perdido la estereoquímica al convertir entre formatos—.
Framework, toolboxes y entrenamiento
La segunda y la tercera capa son el «cerebro» y las «manos». El modelo de lenguaje planifica y decide qué cálculo lanzar; la toolbox de dominio le proporciona docking, cálculo químico-cuántico, búsqueda en bases de datos y predicción de propiedades. Un buen ejemplo de este enfoque es el agente ChemCrow: allí el valor no lo crea el modelo en sí, sino las herramientas cuidadosamente descritas que invoca.
La cuarta capa es el entrenamiento y la optimización. Al agente se le puede hacer fine-tuning con trayectorias de soluciones exitosas, o bien basta con mejorar la descripción de las herramientas y la estrategia para elegirlas. El segundo camino es más barato, y los autores dejan claro que la mitad de los fracasos en este campo no se deben a un modelo débil, sino a un bucle de retroalimentación mal diseñado.
La escalera de la autonomía científica: L1–L4
La segunda perspectiva del artículo es esa misma «escalera de autonomía», tomada de la lógica de niveles de los sistemas de ingeniería. Sirve para no discutir de forma abstracta si un agente es «inteligente», sino para entender cuántas decisiones asume realmente.
L1 — asistente con un guion fijo
Aquí la persona define la secuencia de pasos y el modelo ejecuta operaciones concretas: convertir una estructura, calcular descriptores, proponer variantes. Apenas hay autonomía, pero la previsibilidad es máxima.
L2 — agente computacional adaptativo
El agente decide por sí mismo qué herramienta invocar y en qué orden, replanifica cuando hay un error y trabaja en un circuito totalmente digital. Este es el mainstream actual: el riesgo se limita a un cálculo estropeado, no a una muestra estropeada.
L3 — agente que tiene en cuenta los resultados de experimentos reales
El nivel más interesante y también el más arriesgado. El agente no solo planifica, sino que además recibe retroalimentación del laboratorio físico —espectros, cromatogramas, datos de síntesis— y ajusta el plan en función de ella. Existen ejemplos de sistemas de esta clase: Coscientist demostró la planificación de síntesis recurriendo a la automatización de laboratorio. Pero es precisamente aquí donde el coste de un error deja de ser abstracto: un paso incorrecto consume reactivos, tiempo de instrumento y, en el peor de los casos, la seguridad de las personas.
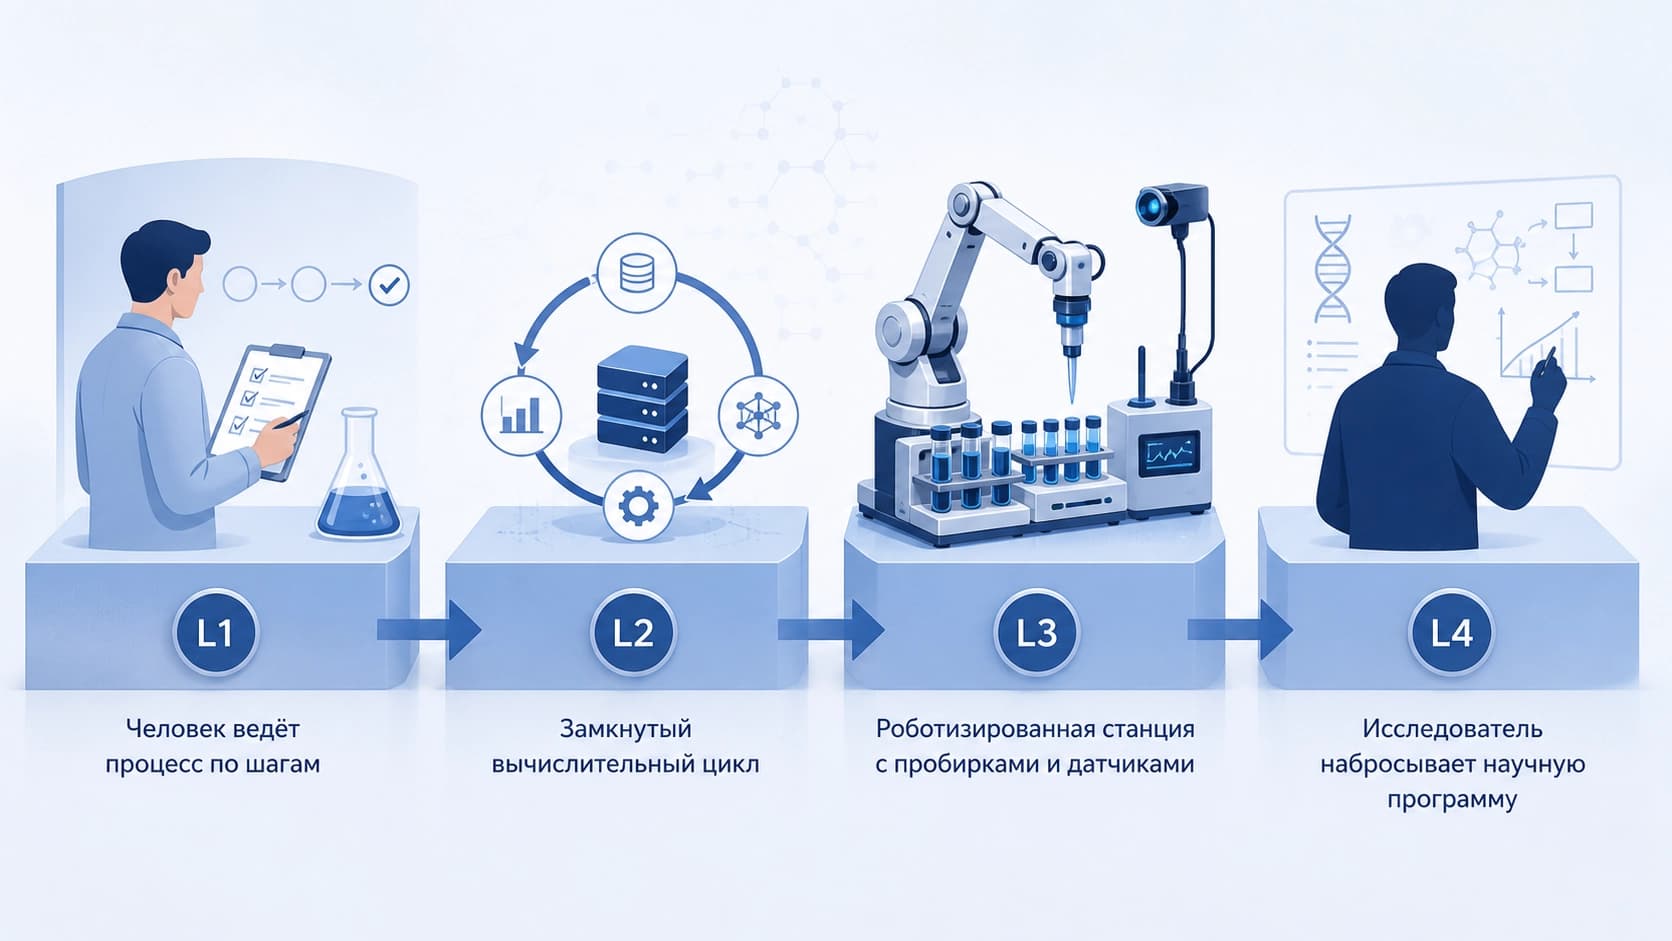
L4 — agente que configura la agenda científica
El escalón superior es cuando el sistema elige por sí mismo qué hipótesis comprobar, qué direcciones considerar prioritarias y dónde buscar lagunas en la literatura. Por ahora esto es más una referencia que una descripción de soluciones que funcionen. Pero es justamente lo que marca la dirección: la diferencia entre un «ejecutor rápido» y un «coautor que plantea el problema» es fundamental, y conviene fijarla con palabras, no con la intuición.
Para qué sirve este marco
La utilidad práctica de las dos perspectivas está en la posibilidad de comparar lo incomparable. Si dos agentes se llaman a sí mismos «autónomos», pero uno gira en un simulador y el otro controla un robot sintetizador, son sistemas de una clase de responsabilidad distinta.
Los autores proponen usar el framework para tres tareas:
- Diagnóstico. Al descomponer el agente por capas, se ve dónde tiene su punto débil: en la percepción de moléculas, en las herramientas o en la planificación.
- Evaluación de riesgos. Cuanto más alto es el escalón, más graves son las consecuencias de un fallo —y más importantes son las comprobaciones antes de actuar, no después—.
- Diseño. Entender qué nivel de autonomía se necesita realmente para una tarea evita la tentación de construir un L4 donde bastaría con un L2 bien hecho.
Limitaciones y lo que queda por resolver
Una advertencia honesta: la escalera es un modelo conceptual, no una escala medida. Ayuda a pensar, pero no sustituye la validación, la certificación ni la reproducibilidad de los resultados. Además, la química tolera mal el «casi correcto»: una errata en un texto es molesta, pero en una fórmula estructural ya es otra sustancia.
Una cuestión aparte sin resolver son los datos. La retroalimentación de un laboratorio real es cara y escasa, y sin ella el agente L3 sigue siendo teoría. La segunda cuestión es la interpretabilidad: quien hace química necesita entender por qué el sistema propuso precisamente esa ruta de síntesis; de lo contrario, no habrá confianza.
En resumen
Los agentes moleculares basados en LLM no son simplemente «química más un chatbot». Son una clase aparte de sistemas en los que el modelo de lenguaje actúa como despachador entre grafos, espectros, paquetes de cálculo y equipamiento de laboratorio. El trabajo arXiv:2608.23104 es útil sobre todo por su vocabulario: cuatro capas arquitectónicas y cuatro escalones de autonomía ofrecen un lenguaje común para hablar de lo que estos agentes ya saben hacer, de lo que les falta y de dónde está la frontera entre una aceleración útil de la rutina y una decisión que es mejor dejar en manos de una persona.


