
Interpretación como medición: el marco matemático MTI describe el malentendido a través de la entropía y la confundibilidad
Blake Reynolds presentó en arXiv un núcleo condensado de la «Teoría matemática de la interpretación»: la comprensión aquí no es una propiedad del texto, sino el resultado de una medición espectral que depende del observador, de su acceso y del método elegido. En el trabajo se introducen la entropía racional como medida de la vaguedad residual y la confusabilidad, que pasa de ser una interferencia a un recurso de diseño, así como un certificado de calidad de lectura de cuatro condiciones con fallos tipificados.
La interpretación suele vivir en la conversación como una etiqueta binaria: «entendí» o «no entendí». El trabajo de Blake Reynolds «A Mathematical Theory of Interpretation: Rational Entropy, Spectral Readout, and Confusability as a Resource» (arXiv:2608.23892, agosto de 2026; núcleo abreviado de la tesis de 2026) propone verlo de otra manera. Aquí la comprensión no es un estado de conciencia, sino el resultado de una medición que depende del observador. Y esa medición no ocurre en el vacío, sino dentro de una estructura de acceso: alguien tiene la clave de los datos, alguien no, y «entendí» sin especificar el acceso pierde sentido.
La publicación salió en cs.IT con un cross-list en cs.AI — y eso ya es revelador. El autor traslada la conversación sobre la interpretación del ámbito de la hermenéutica al de la teoría de la información, donde hay entropía, capacidad de canal y modos de fallo explícitamente enumerados.
Cuatro parámetros en lugar de intuición
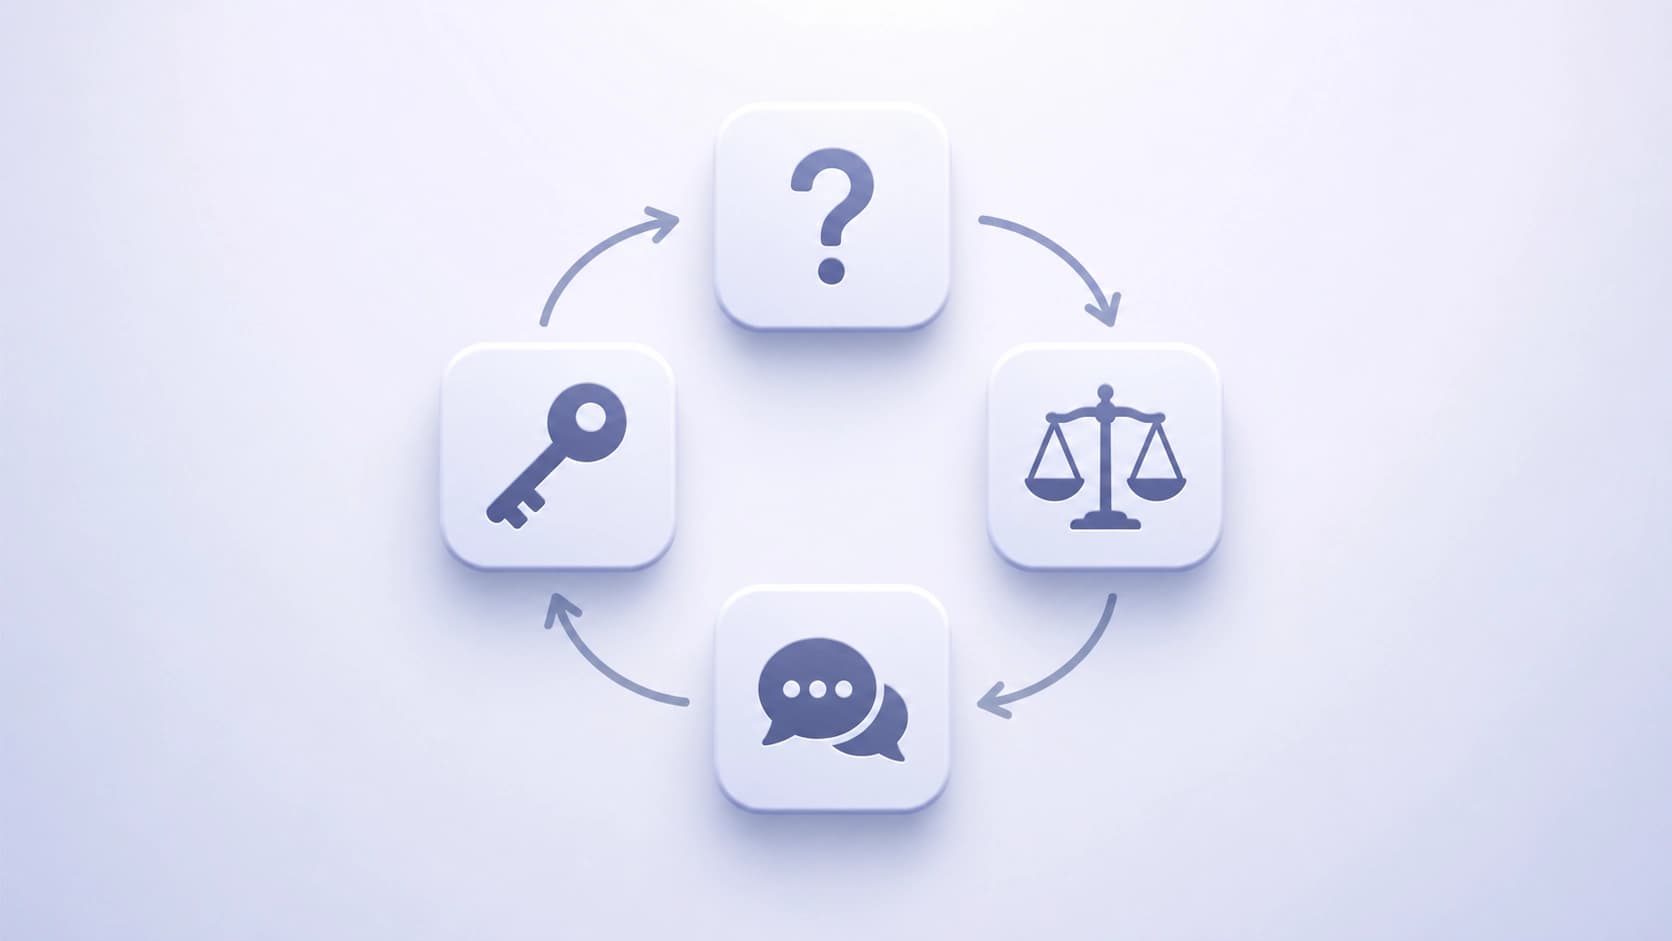
El movimiento central de MTI es convertir la interpretación en un problema de diseño de método. En lugar de preguntar «qué significa esta señal», la teoría pregunta qué posibilidades tiene el observador. Estas posibilidades son cuatro y se definen mediante los parámetros access, query, utility y medium:
- acceso — a qué datos está admitido el observador;
- consulta — qué preguntas tiene derecho a plantear al sistema;
- utilidad — qué cuenta para él como una buena respuesta;
- soporte — en qué medio se distribuye y se almacena la señal.
De este cuarteto depende qué puede elegir el observador, qué puede reconocer, qué puede transmitir a otros o, por el contrario, qué puede rechazar. La conclusión práctica aquí es bastante dura: las disputas sobre la «interpretación correcta» a menudo resultan ser disputas sobre distintos conjuntos de estos cuatro parámetros. Dos personas pueden mirar el mismo objeto y no discrepar en la lógica — simplemente tienen cuotas de acceso distintas y consultas distintas.
Rational Entropy: cuánta incomprensión queda
Después la teoría pasa a una magnitud medible. En la implementación de Hilbert learning-invariant se introduce la Rational Entropy — describe la incertidumbre residual a lo largo de tres ejes a la vez: conocimiento, utilidad y soporte. En términos simples, es la respuesta a la pregunta «cuánto queda aún por resolver», y no en general, sino teniendo en cuenta lo que el observador ya sabe y lo que quiere.
Un detalle importante: en el régimen finito-efectivo, los autores clasifican el conjunto nulo de la entropía racional. Es decir, la teoría no solo introduce una medida, sino que también describe cuándo esta se anula — qué configuraciones de acceso, consultas y entorno producen certeza total. Para la ingeniería este es el punto más interesante: el conjunto nulo es una lista de condiciones bajo las cuales la incomprensión es constructivamente imposible.
Por qué esto no es la entropía habitual
La entropía clásica no sabe nada de los objetivos del observador. Aquí la utilidad entra en la propia medida, lo que significa que dos sistemas con la misma estadística de señal pueden tener distinta entropía racional — si los observadores tienen tareas distintas. Esto es incómodo para quienes buscan una única métrica universal de «comprensibilidad», pero describe la realidad con más honestidad.
La confusabilidad como recurso, no como defecto
El resultado más contraintuitivo: la confusabilidad por pares (cuando dos estados son indistinguibles) equivale a un uniform atomic collapse. Suena a sentencia, pero luego empieza el giro. Un único máximo de utilidad puede seleccionar un átomo, incluso si todos los demás estados permanecen no atómicos a costo cero.
En otras palabras, el papel habitual de la confusabilidad en la teoría de la codificación se invierte. Allí la indistinguibilidad es una fuente de errores de la que uno se deshace. Aquí puede trabajar a favor del observador: el acuerdo en al menos una dirección excluye las lecturas multi-atom no resueltas, y la etiqueta conjunta preserva la identificación del objeto. Si dos estados «se pegan» en una dimensión pero se diferencian en otra, el observador sigue manteniendo el objeto como un todo.
Cuánto resiste el diseño libre
De esta lógica surge una estimación cuantitativa. La capacidad del diseño libre es igual al producto de los presupuestos de todas las direcciones, excepto la menor. La fórmula es corta, pero con un énfasis poco habitual: la dirección más débil no entra en el producto. Esto conviene leerlo como una insinuación de que el cuello de botella en la interpretación está estructurado de manera distinta al cuello de botella en un canal de comunicación — allí precisamente el tramo peor determina el resultado, aquí la aritmética es otra.
Un certificado de cuatro condiciones
Para que los resultados no queden en lo teórico, se introduce un certificado de cuatro condiciones. Caracteriza la lectura como:
- sharp — nítida, sin bordes difusos;
- decodable — que admite decodificación;
- medium-faithful — fiel al soporte, es decir, que no distorsiona el medio de transmisión;
- order-independent — independiente del orden de las operaciones.
Todo esto — sobre un sector conmutativo finito del código. Si al menos una condición se viola, la teoría no devuelve un encogimiento de hombros general, sino obstrucciones tipificadas: indicaciones concretas sobre qué tipo exacto de fallo ocurrió. Para la práctica, esta es quizá la principal aportación del trabajo. En lugar de «el modelo alucina» aparece un vocabulario: aquí se perdió la nitidez, aquí el soporte distorsionó la señal, y aquí el orden de procesamiento rompió la identificación.
Para qué sirve esto más allá de las matemáticas
MTI se presenta como una base teórica para construir métodos de interpretación con supuestos explícitos sobre el acceso, garantías y modos de fallo. Aplicado a sistemas de IA, esto es justo lo que a menudo falta al evaluar modelos: no otra métrica de «calidad de respuesta», sino un marco que obliga a explicitar de antemano quién tiene qué acceso, qué consultas están permitidas y qué se considera útil. Entonces la conversación sobre la incomprensión se vuelve reproducible.
Qué conviene tener en cuenta
Esto es un preprint: versión v1, núcleo abreviado de la tesis, sin un ciclo completo de revisión por pares. El aparato matemático del artículo es denso, y el resumen inevitablemente simplifica las formulaciones — para las definiciones precisas de la implementación de Hilbert y del sector conmutativo es mejor ir a la fuente original.
Pero la idea principal se traslada a la práctica incluso sin los detalles. La incomprensión deja de ser una propiedad de la persona o del modelo y se convierte en una magnitud medible que depende de una configuración estructurada de acceso, consultas, objetivos y entorno. La confusabilidad deja de ser solo un defecto y a veces funciona como un apoyo. Y el certificado de cuatro condiciones ofrece un lenguaje con el que un fallo de interpretación puede llamarse por su nombre — en lugar de achacarlo todo a que «lo explicaron mal».
Preguntas frecuentes
Material similar
Todos los materiales
OpenCollab: coordinación programable de agentes, entorno de ejecución controlado y métrica de cumplimiento de las normas
El framework integra la definición de la estructura de interacción entre agentes, un entorno común para los experimentos y un seguimiento detallado de los eventos, mientras que la métrica Adherence, introducida en este trabajo, refleja hasta qué punto la ejecución real se ajusta al esquema declarado. En los benchmarks, la configuración Duo alcanza un nuevo nivel de SOTA, mientras que la variante de un solo agente destaca por consumir la menor cantidad de tokens.
11 noviembre 2026
Toollery: selección de herramientas para agentes LLM entre decenas de miles de opciones sin necesidad de ajuste fino
Toollery construye un índice de búsqueda a partir de las descripciones de habilidades y herramientas y, al recibir una consulta, solo envía al modelo un conjunto limitado de candidatos. En experimentos con bibliotecas de hasta decenas de miles de funciones, el enfoque permite mantener la calidad de selección con un top-K fijo, aunque el efecto final depende del perfil de carga y del almacenamiento en caché del proveedor.
11 noviembre 2026
WILSON: integración de aumentos y portaobjetos del paciente para el análisis anatomopatológico y la elaboración de informes
El preprint presenta WILSON, un modelo de visión y lenguaje que codifica imágenes de portaobjetos completos y series de muestras de un mismo paciente a distintos aumentos, en lugar de limitarse a un único portaobjetos «mejor». Sin necesidad de ajustarlo a la tarea, supera a modelos especializados y de mayor tamaño para portaobjetos en varias métricas, con una carga computacional considerablemente menor, y sus descripciones diagnósticas obtuvieron puntuaciones más altas de los patólogos.
11 noviembre 2026