
LLM multimodales multiagente en matemáticas: cómo verificar el proceso de razonamiento y la robustez ante distorsiones
Se presenta MAMath-Bench, un conjunto de 1003 problemas de 11 áreas de las matemáticas con materiales textuales, gráficos y de audio; además de la respuesta final, registra los pasos de control y la reacción del sistema ante cambios adversariales en el curso del razonamiento. Los resultados muestran que la cooperación entre varios LLM no necesariamente mejora la precisión, puede aumentar la redundancia de las justificaciones y que las perturbaciones estructurales sutiles siguen siendo una fuente importante de vulnerabilidad.
Qué evalúa el benchmark
MAMath-Bench es un benchmark para evaluar el razonamiento matemático multimodal de sistemas multiagente. Incluye 1 003 tareas de 11 categorías matemáticas. Las tareas abarcan varios niveles de dificultad y tres modalidades: texto, imágenes y audio.
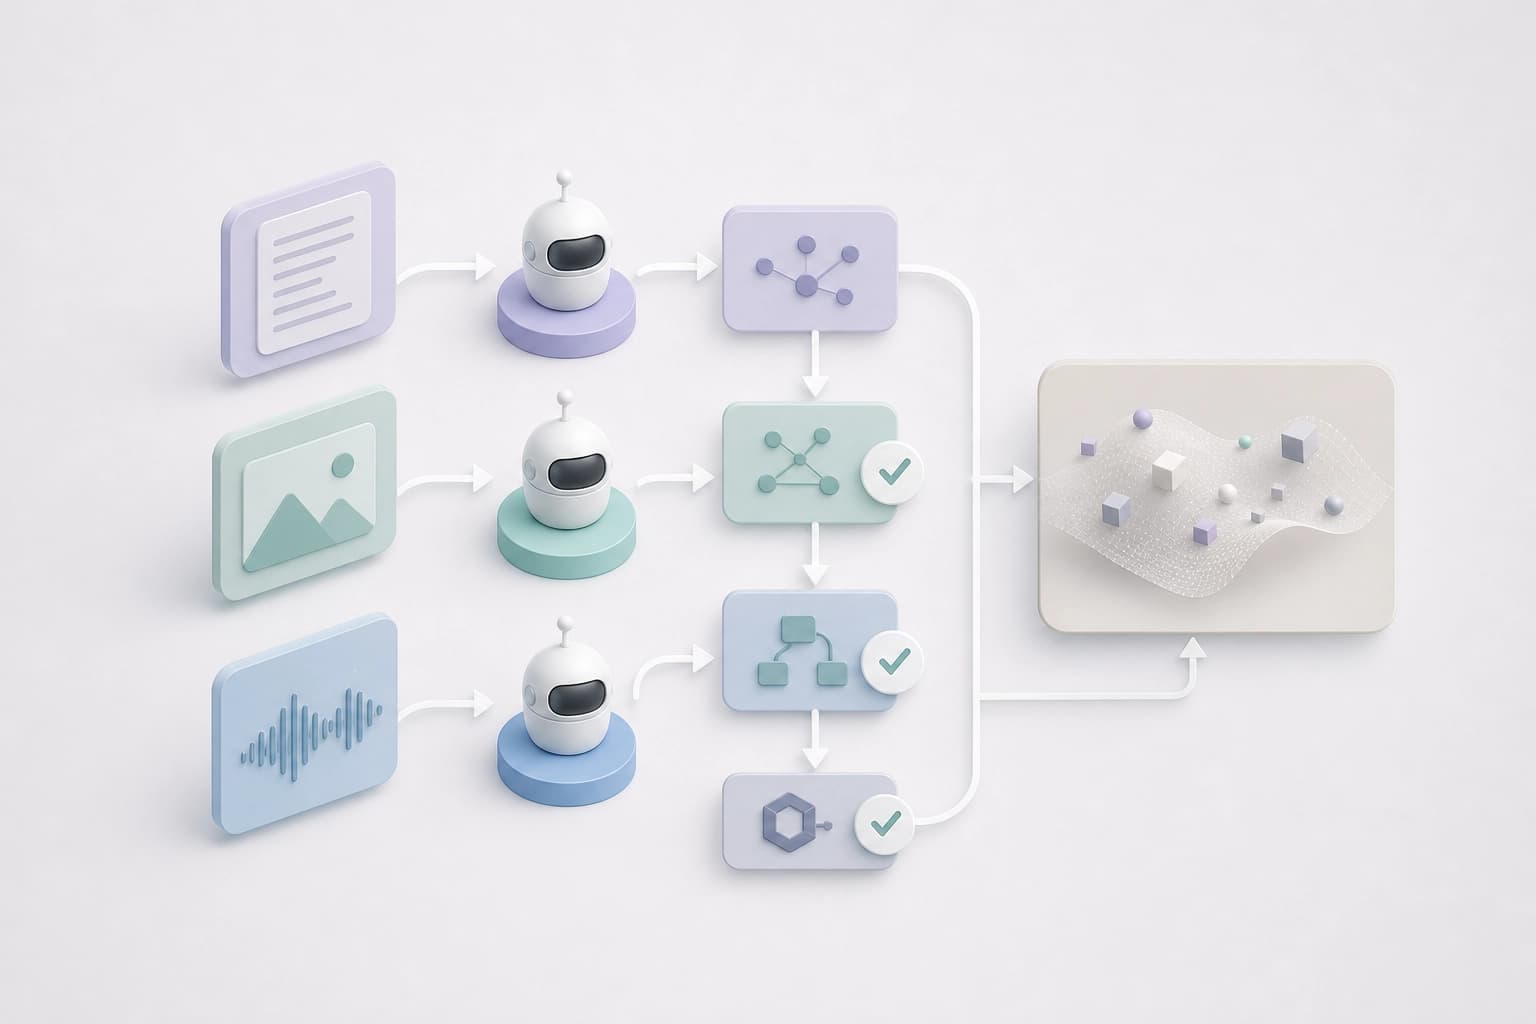
El benchmark contiene anotaciones detalladas de los hitos de control. La evaluación se realiza en tres dimensiones:
- corrección de la solución;
- fiabilidad del proceso de razonamiento;
- resistencia a perturbaciones adversariales de la cadena de razonamiento.
Criterio práctico: elegir una evaluación que diferencie entre la corrección de la respuesta, la fiabilidad del proceso y la resistencia a las perturbaciones. La respuesta final no basta para realizar esta comprobación.
Revisión del proceso de resolución
Las anotaciones de los hitos de control sirven de referencia para revisar los pasos intermedios. La evaluación de la fiabilidad del proceso de razonamiento se distingue de la corrección de la respuesta final. Esto permite comparar sistemas no solo por el resultado.
Qué revisar durante el proceso de resolución:
- la presencia de los hitos de control indicados en las anotaciones;
- la correspondencia entre los pasos intermedios y esos hitos;
- la fiabilidad del proceso de razonamiento como dimensión independiente.
Criterio de revisión: registrar en qué punto exacto la solución se desvía de los hitos de control. La respuesta final por sí sola no muestra la calidad del proceso de resolución.
Sistemas multiagente: precisión, cobertura y redundancia
La evaluación muestra tres efectos distintos de la colaboración entre varios agentes. La precisión de la respuesta final no siempre aumenta en comparación con LLM individuales potentes. La cobertura del razonamiento intermedio puede mejorar considerablemente. El aumento de la cobertura puede ir acompañado de un aumento de la redundancia del razonamiento.
| Qué comparar | Qué muestra la evaluación | Conclusión práctica |
|---|---|---|
| Precisión de la respuesta final | La colaboración entre varios agentes no siempre aumenta la precisión en comparación con LLM individuales potentes | No considerar que un sistema multiagente garantice una respuesta correcta |
| Cobertura del razonamiento intermedio | La colaboración puede mejorar considerablemente la cobertura | Comparar la mejora de la cobertura con otras dimensiones |
| Redundancia del razonamiento | El aumento de la cobertura puede ir acompañado de un aumento de la redundancia | Tener en cuenta el aumento de la redundancia al evaluar la cobertura |
Criterio de selección: no considerar que un sistema multiagente garantice la precisión. Compararlo con un LLM individual potente en cuanto a la respuesta final, la cobertura y la redundancia.
Resistencia a las distorsiones adversariales
La evaluación incluye la resistencia a perturbaciones adversariales de la cadena de razonamiento. Los sistemas actuales siguen siendo vulnerables a errores de razonamiento adversariales, especialmente a los relacionados con perturbaciones estructurales sutiles.
Qué comprobar:
- la reacción del sistema ante perturbaciones adversariales de la cadena de razonamiento;
- los errores de razonamiento ante perturbaciones estructurales sutiles;
- la conservación de la fiabilidad del proceso, no solo de la respuesta final.
Criterio de resistencia: poner a prueba el sistema con perturbaciones adversariales de la cadena de razonamiento. La resistencia a estas perturbaciones forma parte de la evaluación, junto con la corrección de la respuesta.
Preguntas frecuentes
Material similar
Todos los materiales
Cloudflare recurrió a OpenAI para detectar defectos y verificar las correcciones
El artículo analiza cómo Daybreak ayuda a detectar puntos débiles y preparar parches para su verificación, mientras que los desarrolladores utilizan Codex para agilizar el trabajo y mejorar la calidad del código.
18 noviembre 2026
Tareas verificables y entrenamiento adicional en trayectorias largas: cómo Navalia potencia a los agentes cooperativos de LLM
El trabajo describe un marco que, a partir de informes financieros corporativos, construye cadenas computacionales con evidencias trazables, las valida de forma independiente y luego las aplica a SFT y RL. Basada en Qwen3.6-35B-A3B, esta canalización mejora los resultados en cinco benchmarks y, según los autores, optimiza la vinculación de evidencias, el uso de herramientas y la ejecución de tareas prolongadas, incluidos los escenarios de oficina.
18 noviembre 2026
IA física: límites del concepto, herramientas y aspectos difíciles
La monografía, de 388 páginas, reúne en un marco unificado las definiciones de la IA física, sus diferencias con campos afines y sus métodos principales, desde la percepción y la simulación hasta el control y los sistemas multiagente coordinados. Ofrece un mapa de los desafíos de investigación y las limitaciones que dificultan pasar de soluciones especializadas a sistemas con una amplia capacidad de generalización.
17 noviembre 2026