
Control ejecutivo de agentes LLM: externalizar la evaluación del progreso y la capacidad de detenerse, fuera del generador, ahorra un tercio de los tokens
El preprint describe un modo en el que un agente lingüístico, tras alcanzar su objetivo, sigue realizando mejoras y comprobaciones de escasa utilidad, atribuyéndolo a un ciclo de autoafianzamiento en el que la generación, la evaluación del progreso y la decisión de detenerse no están separadas. La capa de control global propuesta, que tiene en cuenta la incertidumbre, mantiene la tasa de éxito en torno al 96,6 % y, al mismo tiempo, reduce el consumo medio de tokens en un 36,4 %, aunque las conclusiones se han obtenido hasta ahora mediante simulaciones mecanicistas.
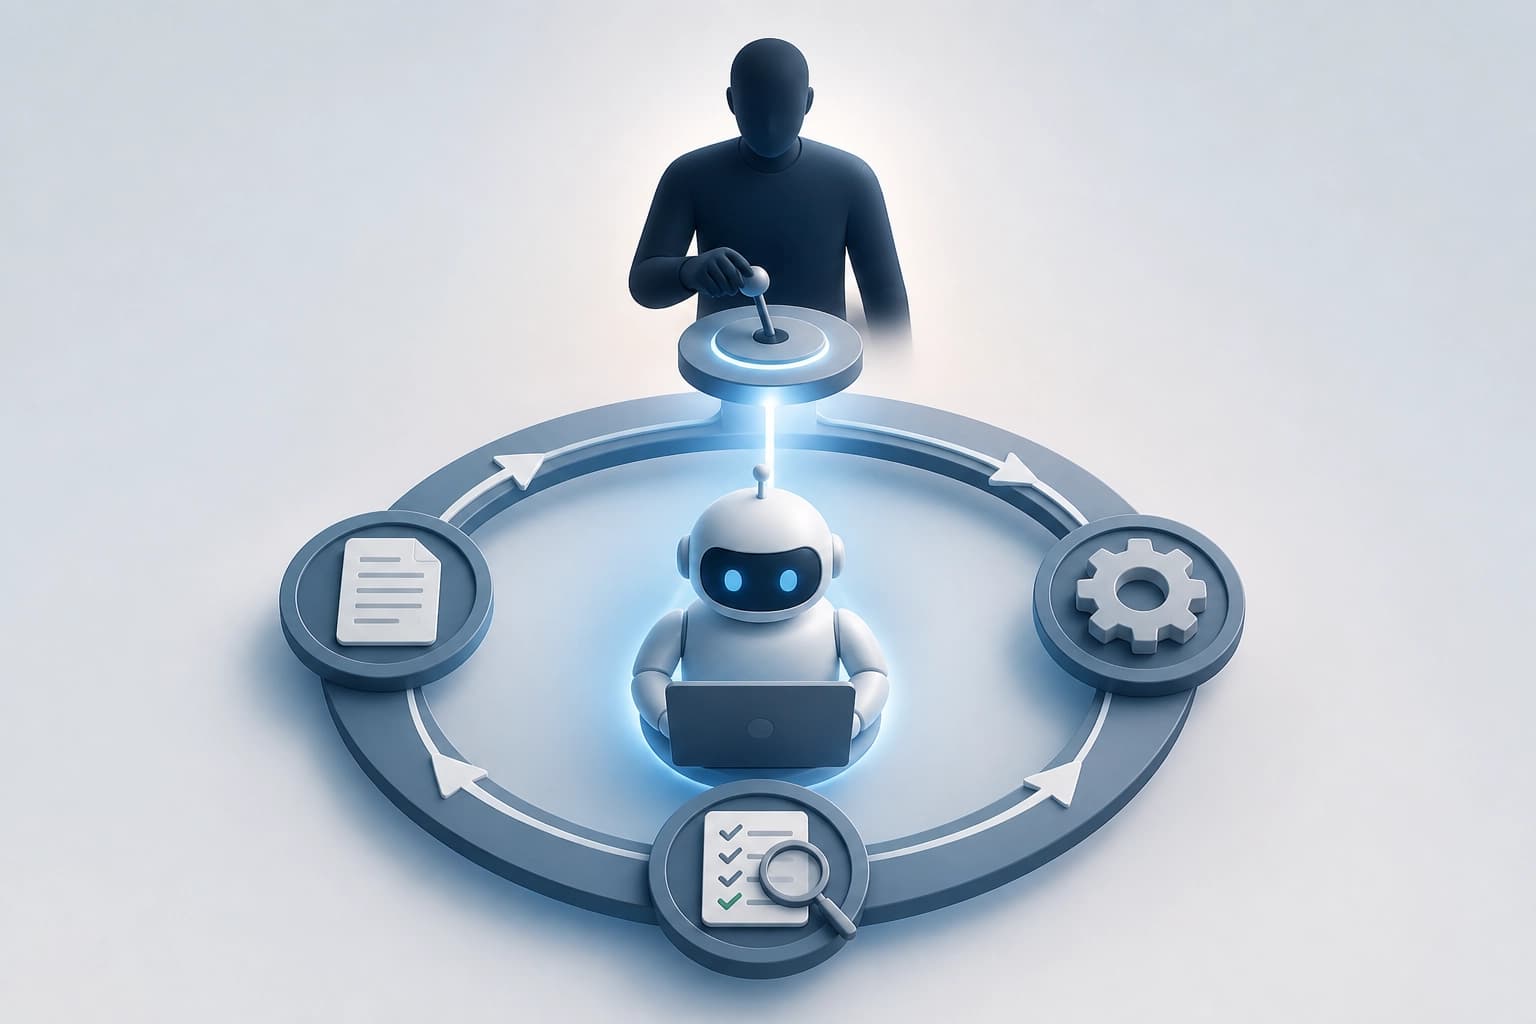
Qué es LLM Parkinsonism
El término LLM Parkinsonism se introduce como una metáfora acotada y no clínica. Describe la continuación persistente de acciones cuando su valor para la tarea disminuye.
Señales de este comportamiento:
- el agente sigue actuando después de alcanzar el objetivo inicial;
- realiza ajustes de poco valor;
- inicia comprobaciones repetidas;
- corrige la complejidad que él mismo ha creado.
Conclusión: la metáfora señala un fallo de control, no una analogía clínica.
Por qué el autocontrol dentro de un único ciclo agrava el problema
Los autores vinculan el problema no solo con la predicción autorregresiva del siguiente token. También se debe a la concentración de cuatro funciones en un mismo ciclo.
- generación de propuestas;
- interpretación del ámbito de la tarea;
- evaluación del progreso;
- autoridad para detenerse.
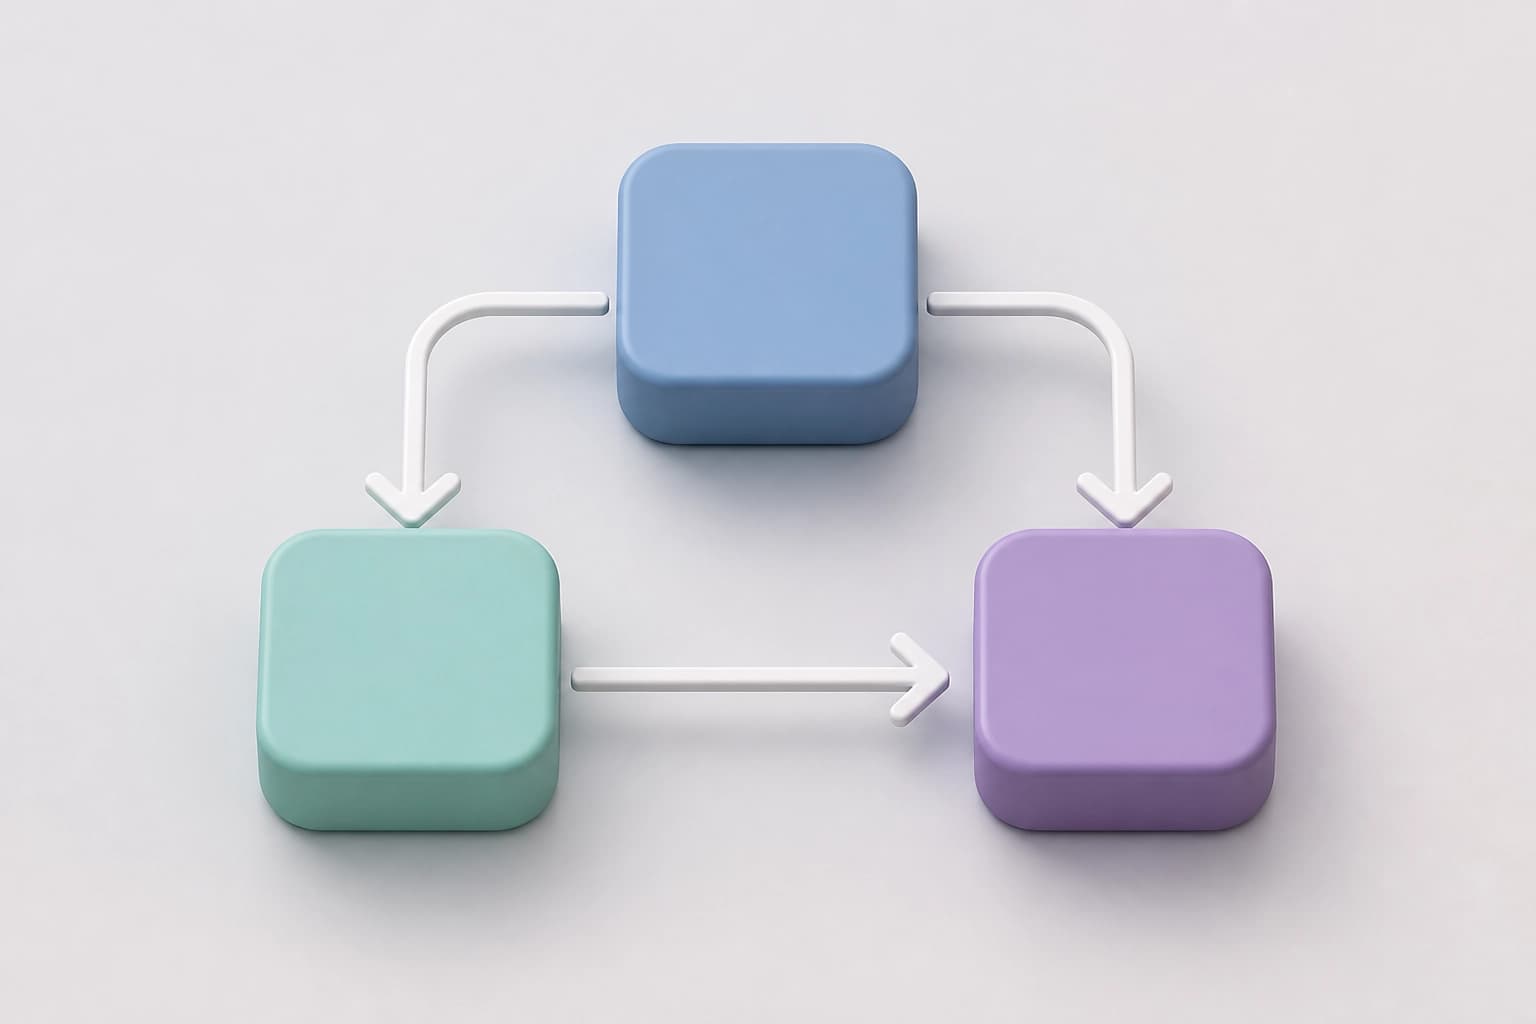
Este ciclo funciona mediante el autorrefuerzo. La evaluación, la generación y la detención se influyen mutuamente.
Conclusión: para romper el autorrefuerzo, hay que trasladar algunas funciones fuera del generador.
Global Executive Control: qué se traslada fuera del generador
Global Executive Control (GEC) v0.2 es una arquitectura de control que tiene en cuenta la incertidumbre. Separa la generación de acciones del control a nivel de proyecto.
Se trasladan fuera del generador:
- el ámbito de la tarea;
- las evidencias;
- el consumo de recursos;
- la detención.
El control a nivel de proyecto recibe la autoridad para detenerse y evaluar el progreso. El generador se encarga de las acciones.
Conclusión: el criterio práctico es que la evaluación del progreso y la detención deben estar fuera del ciclo de generación.
Qué muestran las mediciones
El benchmark incluyó 24,000 episodios con candidatos comparables y un límite total de 40,000 tokens. Se compararon tres variantes.
| Variante de control | Éxito con el objetivo estricto |
|---|---|
| Básico con el primer candidato | 67.42% |
| Control local con un conjunto de candidatos | 96.53% |
| GEC | 96.57% |
El acceso a varias opciones de acción explica la mayor parte del aumento del éxito. GEC mantuvo el nivel de éxito y redujo el uso medio de tokens.
- uso medio de tokens: de 19,782 a 12,574 (36.4%);
- número medio limitado de tokens hasta la finalización con un límite de 40,000 tokens: de 16,136 a 13,114 (18.7%).
GEC eliminó la deriva medida antes de completar la tarea y redujo drásticamente la complejidad excesiva. La sensibilidad a los costes de control siguió siendo favorable al añadir hasta 500 tokens de control sintéticos por ciclo.
Conclusión: el conjunto de candidatos aporta la mayor parte de la mejora en el éxito; GEC añade ahorro de tokens y control de la complejidad.
Criterios prácticos para elegir un control
Conviene comprobar cinco condiciones:
- la evaluación externa del progreso está separada del generador;
- la autoridad para detenerse está fuera del ciclo de generación;
- hay varias opciones de acción disponibles;
- se tiene en cuenta el consumo de recursos;
- se tiene en cuenta la incertidumbre.
Conclusión: si estas funciones siguen dentro del generador, persiste el riesgo de ajustes de poco valor y de un uso excesivo de tokens.
Limitaciones y qué comprobar a continuación
Los resultados se obtuvieron en simulaciones mecanicistas. Los autores consideran que respaldan el control explícito del ámbito de la tarea, las evidencias, el consumo de recursos y la detención.
Limitaciones:
- sigue siendo necesario probarlo con modelos reales;
- las simulaciones mecanicistas no sustituyen esa comprobación.
Conclusión: el principio arquitectónico parece sólido, pero no se pueden extrapolar las cifras a LLM reales sin comprobarlo.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026