
Figure probó Helix 2.5 en 30 hogares: el robot completó por completo 237 de 420 tareas
El robot dobló toallas, hizo las camas y recogió juguetes en casas en las que nunca había estado. Las pruebas demostraron que sus habilidades se transfieren a nuevos espacios, pero 183 tareas sin completar y la evaluación de los resultados realizada por la propia Figure aún no permiten considerar que el sistema esté listo para limpiar de forma autónoma.
Qué se evaluó
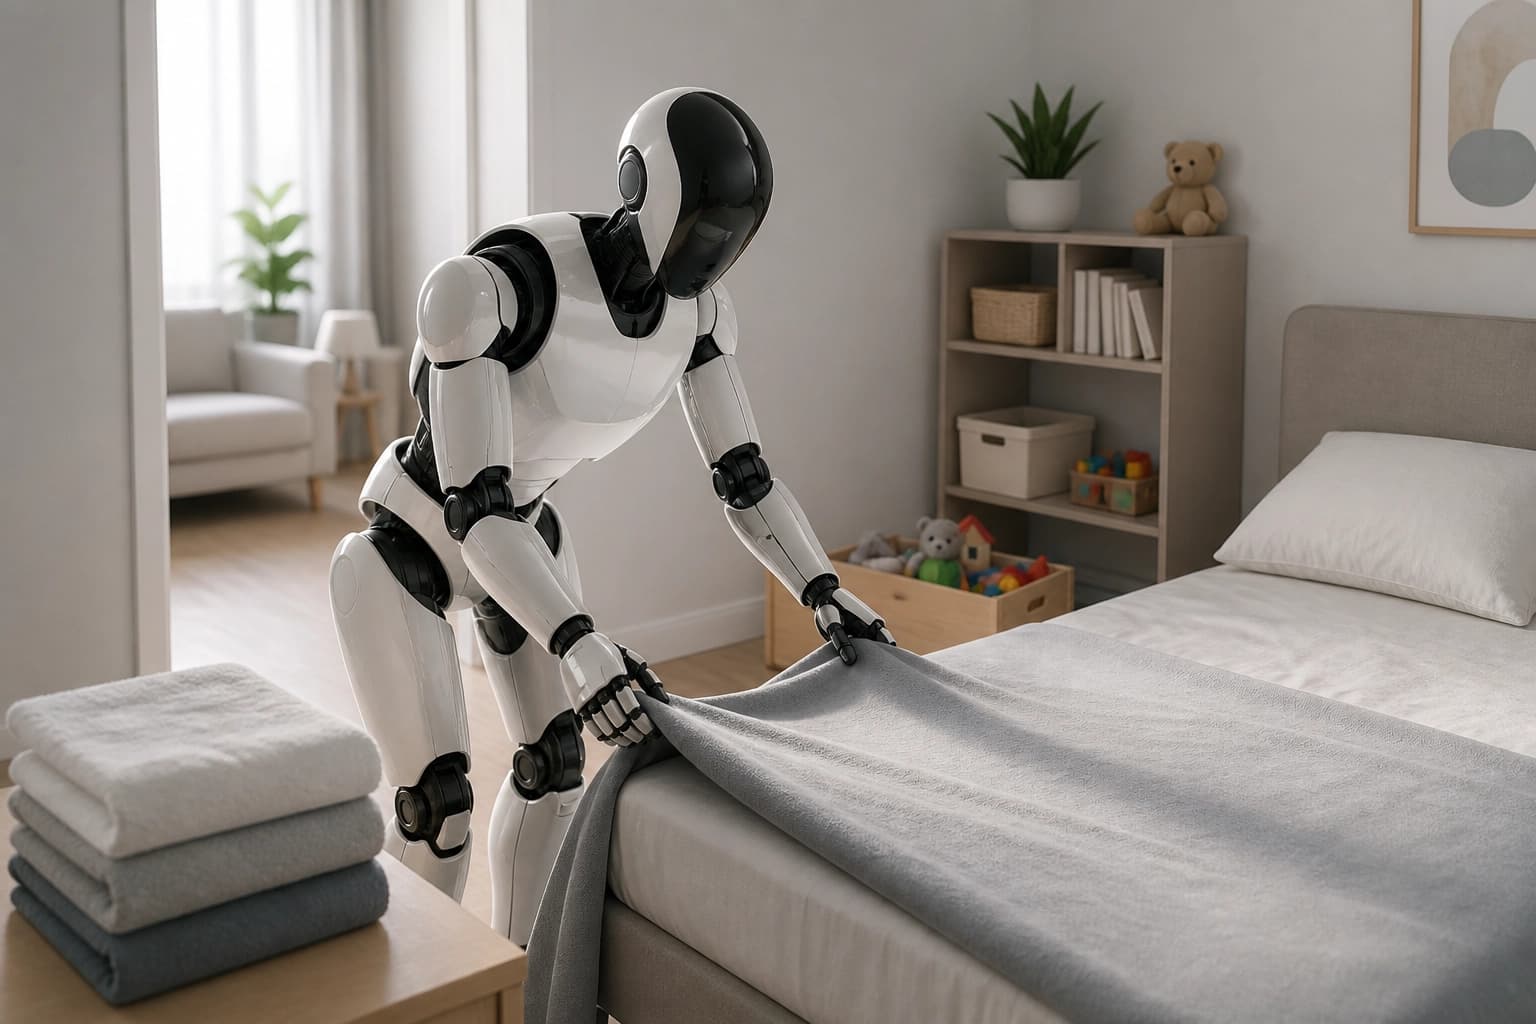
En 30 hogares desconocidos de la zona de la bahía de San Francisco, Helix 2.5 realizó tres tareas: doblar toallas, hacer las camas y recoger juguetes.
Figure no había recopilado datos previamente en esos hogares. En todas las habitaciones se utilizó una misma versión del modelo: no se ajustó en el lugar ni se modificó después de intentos anteriores.
La empresa calificó el experimento de zero-shot. Los hogares y los objetos eran nuevos, pero las tareas no: el modelo se había entrenado previamente con grabaciones de otros espacios.
Cómo se contabilizaron los éxitos
Las pruebas incluyeron 420 tareas. No se concedieron puntos parciales: el robot tenía que completar la tarea por completo.
- Juguetes: guardar en la cesta los 13–15 objetos.
- Toallas: doblar todas las toallas.
- Cama: colocar dos almohadas sobre ella, estirar las esquinas superiores de la manta y alisarla.
Cualquier intervención humana por motivos de seguridad contaba como un fracaso. Por eso, la puntuación final refleja únicamente las tareas completadas por completo sin dicha intervención.
Cuántas tareas completó el robot
Helix 2.5 completó por completo 237 de las 420 tareas. Se le dio mejor hacer las camas y peor recoger los juguetes.
| Tarea | Intentos exitosos | Porcentaje de éxito |
|---|---|---|
| Hacer la cama | 94 de 140 | 67% |
| Doblar toallas | 87 de 140 | 62% |
| Recoger juguetes | 56 de 140 | 40% |
A modo de comparación, Figure entrenó un sistema con los mismos datos especializados, pero partió de una configuración aleatoria, sin preentrenamiento con Index. Esta versión completó 35 de las 420 tareas. El gráfico de Figure muestra un 8%, mientras que el texto adjunto indica un 9%.
Index es el conjunto de datos de Figure con grabaciones de acciones humanas. Los datos de cada una de las tres tareas ocupaban como máximo el 1,9% de este conjunto.
Qué dicen los resultados sobre la preparación para el hogar
La evaluación la realizó la propia Figure; por ahora, no hay una reproducción independiente de los resultados. La empresa tampoco ha indicado cuándo saldrá una versión para el hogar ni qué frecuencia de fallos sería aceptable.
De las 420 tareas, el robot no completó 183. Figure considera que, con tal número de fallos, todavía es pronto para dejarlo limpiar sin supervisión.
Para evaluar su utilidad práctica, no solo importan los mejores resultados en tareas concretas. El criterio es completar las tareas por entero sin intervención humana; la evaluación publicada todavía no confirma que esté listo para limpiar de forma autónoma.
Preguntas frecuentes
Material similar
Todos los materiales
Verificación de alucinaciones de LLM mediante una vista SQL de las fuentes, sin reentrenamiento
El estudio evalúa si un LLM puede aprovechar una habilidad simbólica básica —crear una base de datos SQL a partir de documentos fuente— para fundamentar sus respuestas en las fuentes sin supervisión al detectar alucinaciones. En RAGTruth y DiaHalu, este flujo de trabajo neuro-simbólico resulta más preciso que la predicción directa y comparable a los métodos más avanzados, sin requerir un ajuste fino al dominio.
9 noviembre 2026
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026
AffordanceWAM: las affordances como intermediarias entre la predicción de la escena y el control del manipulador
El trabajo describe un modelo generativo que predice simultáneamente futuras observaciones RGB, campos escalares, mapas de calor de affordances y comandos continuos para el robot, utilizando videos de personas para ampliar la diversidad de interacciones sin anotaciones de acciones ni retargeting. En RoboCasa, CALVIN ABC→D y tareas reales, el enfoque ofrece mejoras consistentes frente a las líneas de base que utilizan solo RGB o solo datos robóticos.
9 noviembre 2026