
Fusión de modelos por grupos compatibles: GRAM reduce la interferencia entre subespacios
El método GRAM determina qué modelos ajustados conviene combinar mediante la geometría de los ángulos principales entre sus subespacios y, a continuación, realiza una fusión de bajo rango dentro de cada grupo. El enfoque solo requiere los pesos, reduce las pérdidas de proyección y demuestra ventajas en experimentos lingüísticos, visuales y médicos.
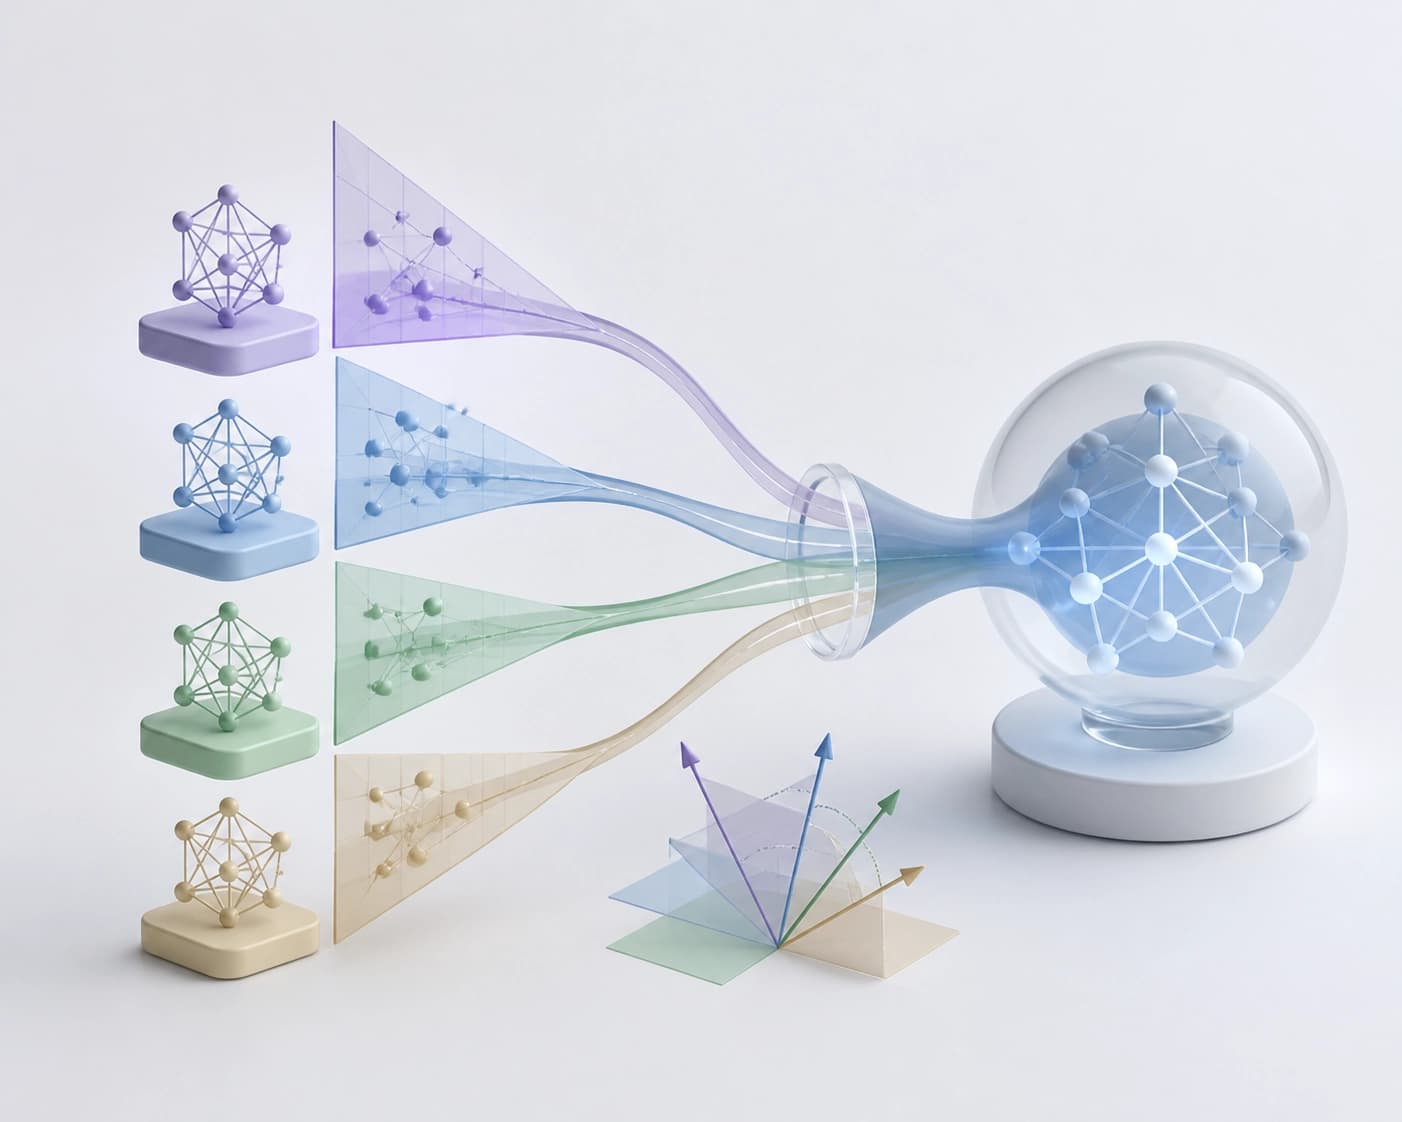
El problema de la interferencia entre subespacios
La fusión de distintos modelos en uno solo es necesaria para el despliegue multitarea. En ámbitos regulados, como la atención sanitaria, los datos suelen permanecer en el entorno local. Por eso, la fusión solo trabaja con los pesos ajustados.
Los métodos anteriores aplican la misma fusión a todas las tareas. No tienen en cuenta las relaciones geométricas entre los subespacios aprendidos. Si las actualizaciones de las tareas ocupan subespacios no alineados, la proyección sobre una base común de bajo rango descarta direcciones importantes. Los autores llaman a este fenómeno interferencia entre subespacios.
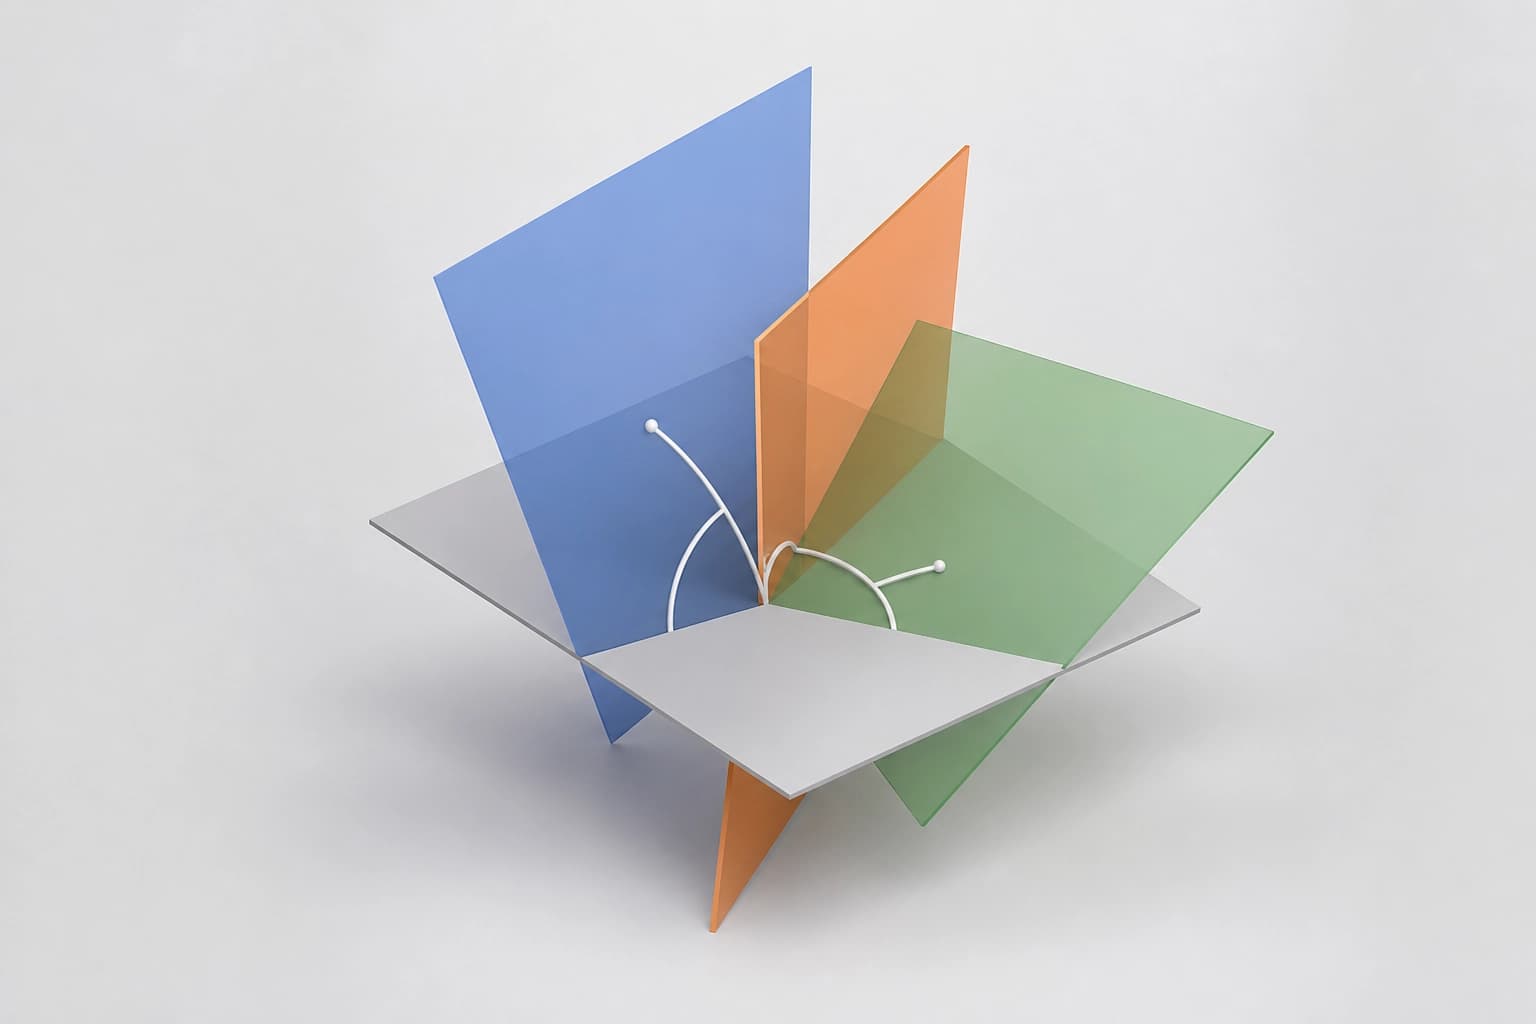
La alineación de los ángulos principales determina el error de proyección de cada tarea. La alineación de los ángulos principales muestra en qué medida el subespacio de una tarea coincide con el subespacio común. Conclusión: la fusión uniforme genera el riesgo de perder direcciones importantes para tareas concretas.
Cómo funciona GRAM: grupos según los ángulos principales
GRAM (Group-wise Rank-Aware Model Merging) utiliza la geometría de los ángulos principales de los vectores de tareas. El método consta de tres etapas:
- Calcular los ángulos principales entre los vectores de tareas.
- Determinar, a partir de esos ángulos, qué tareas deben fusionarse.
- Realizar una fusión estándar basada en SVD dentro de cada grupo.
En la etapa de fusión, el método utiliza solo los pesos ajustados. No requiere acceso a los datos originales. Según los autores, agrupar tareas geométricamente compatibles reduce de forma demostrable el error de proyección dentro de cada grupo.
Criterio práctico: GRAM es adecuado cuando no se pueden transferir los datos y las tareas pueden ocupar subespacios no alineados. El método permite dividir las tareas en grupos compatibles antes de la fusión.
Qué cambia con K=2
El escenario en el que solo se añade un modelo (K=2) muestra el efecto de GRAM. En este caso, el método reduce considerablemente la interferencia entre subespacios. En las pruebas, supera de forma consistente a los métodos de fusión anteriores.
Las evaluaciones abarcan tres áreas:
- comprensión del lenguaje — GLUE with Flan-T5;
- visión artificial — 8-task CLIP;
- ajuste de instrucciones médicas — Qwen2-7B-Instruct with four English/Chinese medical LoRAs.
Conclusión: la ventaja ya se aprecia al fusionar dos modelos. Para el escenario mínimo de añadir un modelo ajustado, GRAM ofrece una opción probada para reducir la interferencia.
Criterios de selección
La elección entre la fusión uniforme y el enfoque por grupos depende de las condiciones de la tarea. A continuación se presentan los criterios que se desprenden de la descripción de GRAM.
| Criterio | Qué tener en cuenta |
|---|---|
| Acceso a los datos | Para la fusión solo están disponibles los pesos ajustados. |
| Geometría de las tareas | Las tareas pueden ocupar subespacios no alineados. |
| Riesgo de interferencia | La proyección sobre una base común puede descartar direcciones importantes. |
| Método de fusión | Agrupar tareas compatibles reduce el error de proyección dentro del grupo. |
| Escenario probado | K=2: se añade un modelo a uno existente. |
Conclusión práctica: si los datos permanecen en el entorno local y las tareas difieren en la geometría de sus subespacios, la fusión por grupos reduce el riesgo de perder direcciones. La fusión uniforme de todas las tareas no tiene en cuenta ese riesgo.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026