
FlightLLM: cómo los modelos semánticos de lenguaje ayudan a explicar las causas de los incidentes de aviación
El enfoque FlightLLM combina modelos estadísticos y grandes modelos de lenguaje para convertir datos de vuelo en explicaciones comprensibles de las acciones del piloto. Las pruebas con datos reales de Airbus A320 mostraron que el método ofrece clasificaciones precisas y formulaciones claras de las causas de un aterrizaje brusco.
¿Por qué explicar los incidentes de aviación?
La seguridad de los vuelos depende directamente de cuán precisamente entendamos las causas de las situaciones anómalas. No basta con detectar un evento peligroso como un aterrizaje brusco: hay que comprender qué acciones de la tripulación y qué parámetros de vuelo llevaron a ese resultado. Sin esto, es difícil desarrollar recomendaciones y prevenir la repetición de errores.
Los métodos tradicionales de IA explicable, como los mapas de importancia de características, muestran qué factores influyeron en la decisión, pero requieren conocimientos de dominio serios por parte del analista. Los modelos de lenguaje saben construir descripciones textuales coherentes, pero al trabajar con datos de aviación surgen dificultades: los indicadores numéricos de los sensores y los informes textuales no encajan bien, los modelos son débiles en clasificación y hay pocos datos etiquetados para el ajuste fino.
¿Qué es FlightLLM?
Los autores de la investigación proponen el enfoque FlightLLM, que combina las fortalezas de los algoritmos estadísticos y los grandes modelos de lenguaje. La tarea no es solo determinar qué ocurrió, sino también explicar por qué. El «experto» numérico se encarga del análisis de parámetros, y el modelo de lenguaje genera una explicación comprensible para el ser humano.
La solución consta de varios bloques. Primero, la ingeniería de características: a los datos de los sensores se añaden características estadísticas e indicadores físicamente significativos para suavizar la brecha entre la representación numérica y la textual. Luego, el módulo de discretización semántica convierte los patrones numéricos en descripciones cualitativas como «disminución brusca de la velocidad vertical». Adicionalmente, se utiliza CatBoost como experto estadístico: su predicción entra en el prompt y sirve como referencia para el modelo de lenguaje.
¿Cómo funciona el proceso de explicación?
En la entrada del sistema se reciben registros de vuelo. Tras la extracción de características y la discretización semántica, los datos numéricos adquieren un aspecto más «humano». Luego, CatBoost emite una evaluación preliminar del evento que, junto con un prompt estructurado y conocimientos de aviación, se transmite al gran modelo de lenguaje. Los prompts están diseñados para que el modelo vea ejemplos tanto correctos como erróneos: esta es una estrategia contrastiva de few-shot. Como resultado, el modelo produce una explicación que señala directamente las causas probables, y no solo enumera características correlacionadas.
¿En qué se probó FlightLLM?
Los experimentos se realizaron con datos reales: 704 muestras de vuelos A320. Como evento objetivo se eligió el aterrizaje brusco.
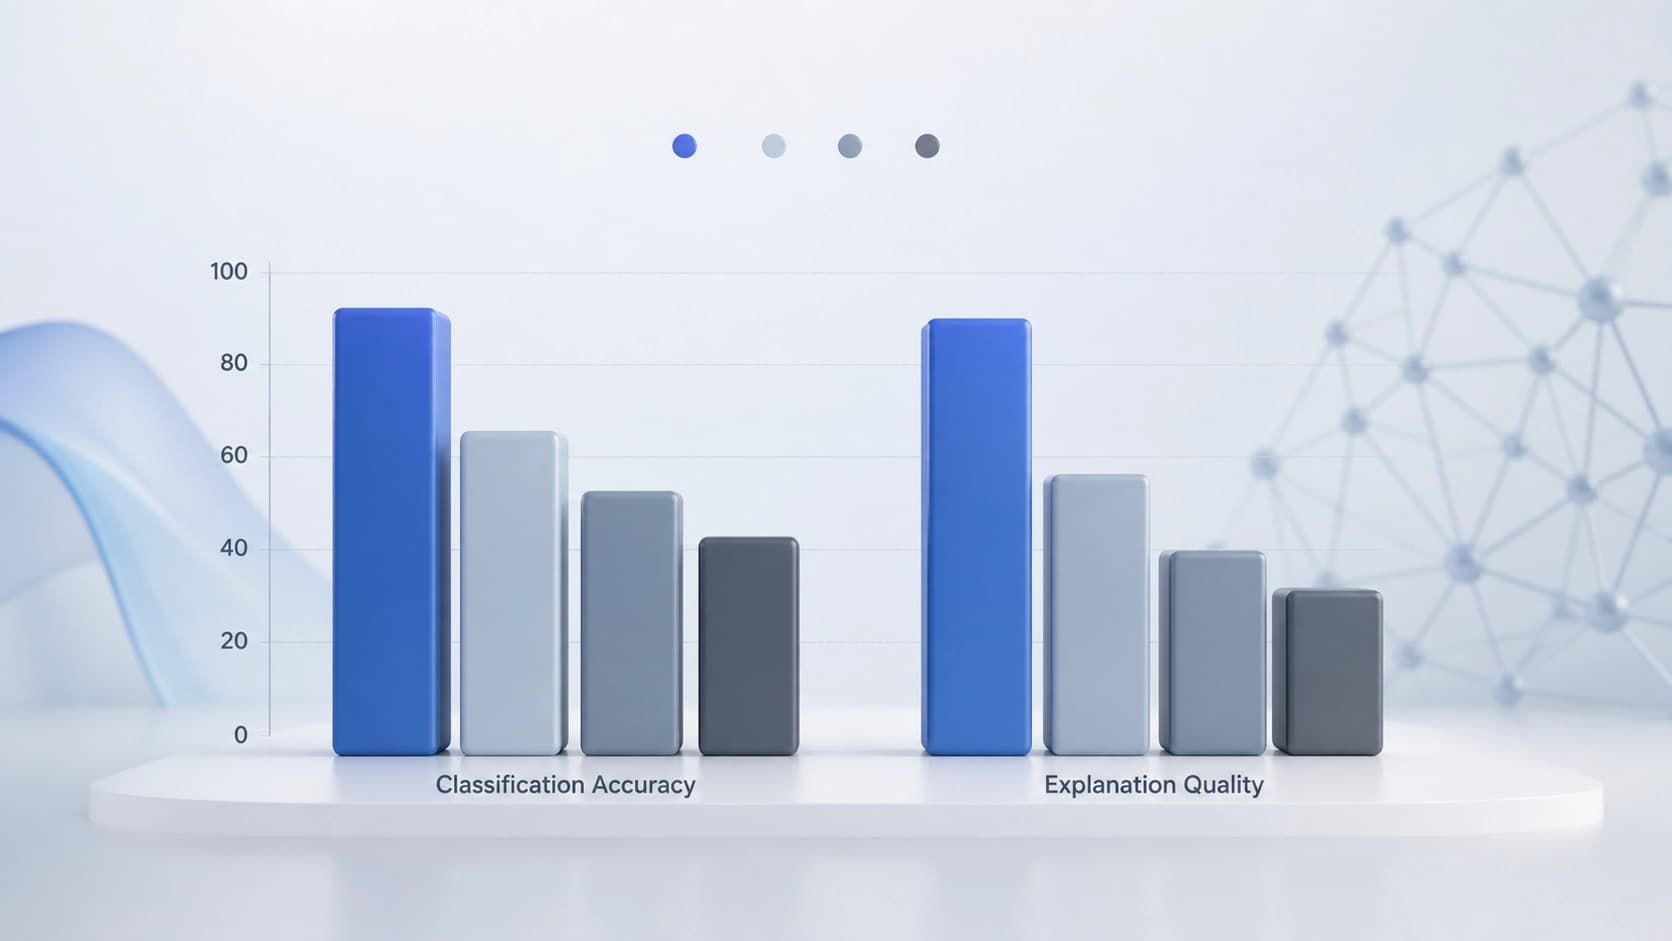
Los resultados mostraron que FlightLLM alcanza una precisión de clasificación competitiva y, además, ofrece explicaciones directas y lógicas de las causas de los incidentes. Es decir, el método no solo no pierde frente a los clasificadores especializados, sino que añade una interpretación importante para el análisis de vuelos.
Por qué es importante
La explicabilidad en la aviación no es un lujo, sino una necesidad. Los pilotos y analistas reciben una herramienta que ayuda a convertir datos brutos en escenarios comprensibles del desarrollo de los eventos. En el futuro, estos sistemas podrían formar parte de los procedimientos estándar de investigación de incidentes y de entrenamiento de tripulaciones.
Preguntas frecuentes
Material similar
Todos los materiales
Invariantes polinómicos canónicos en el diagnóstico de fallos de simuladores de RL: dónde son realmente útiles
El estudio analiza si está justificado incorporar leyes físicas a modelos de dinámica entrenables: los invariantes extraídos de las trayectorias y llevados a una forma canónica mediante bases de Gröbner ofrecen una mejora modesta en las predicciones, pero destacan en el diagnóstico: permiten localizar la restricción incumplida e identificar el parámetro concreto que es erróneo.
10 noviembre 2026
AURA-Eval: cómo comprobar que un agente LLM reconoció el riesgo y cambió su siguiente paso
El framework evalúa el comportamiento de los agentes LLM no por su veredicto final, sino por cómo reaccionan ante el riesgo en puntos clave: se interrumpen las trayectorias de llamadas a herramientas y, a continuación, el modelo debe continuar razonando y actuando, mientras que un panel de jueces LLM analiza la detección del riesgo, la naturaleza del paso y su seguridad. En 1249 tareas recopiladas a partir de 157 trayectorias de R-Judge, los actos inseguros aumentan en 20 modelos cuando no hay una vía segura, y retirar la supervisión antes de la ejecución convierte el 52,3 % de los casos inicialmente seguros en inseguros.
10 noviembre 2026
Memoria del reservorio de Chern-Simons: dinámica autónoma de la conectividad y transporte de densidad
El artículo analiza cómo un reservorio conserva el historial de las señales de entrada tanto en la distribución de densidad como en los grados de libertad geométricos. La comparación de cuatro mecanismos muestra que la corriente crea una componente de conectividad independiente que modifica la respuesta posterior de la densidad, y que tener en cuenta todos los rasgos medidos ofrece una pequeña mejora en la decodificación del orden de los impulsos.
10 noviembre 2026