
Slides gigapíxel frente a los modelos de visión-lenguaje: lo que ha revelado el nuevo benchmark EviPathBench
Investigadores del grupo Dankai Liao presentaron EviPathBench, un conjunto de tareas que evalúa no las respuestas finales de los modelos de patología, sino el propio proceso de búsqueda de evidencia en diapositivas completas. Resultó que los VLM razonan con datos preparados de antemano notablemente mejor de lo que localizan por sí solos las regiones relevantes: la precisión de localización de las zonas diagnósticas y de la búsqueda autónoma cae drásticamente a medida que aumenta el aumento.
Problema: se evalúa el modelo donde ya no hace falta buscar
Una lámina histológica es una imagen de gigapíxeles. Para emitir un diagnóstico, el patólogo primero examina la preparación a bajo aumento, detecta las zonas sospechosas, luego las observa de cerca, compara la imagen a distintas escalas y solo después formula su conclusión. Una parte sustancial de este trabajo no se dedica a observar, sino a buscar: dónde merece la pena mirar en absoluto.
La mayoría de los benchmarks existentes para la IA en patología le quitan al modelo esa parte del trabajo. A la entrada se le da o bien un parche recortado de antemano, o bien características ya extraídas de la lámina, es decir, alguien decidió de antemano qué es lo importante aquí. El modelo recibe pruebas ya preparadas y demuestra su capacidad de razonar sobre ellas. Pero hasta qué punto obtiene las pruebas por sí mismo queda casi sin comprobar.
Precisamente a esa laguna apunta el trabajo EviPathBench. Sus autores son Dankai Liao, Tianyi Zhang, Yufeng Wu, Xinyue Zhang, Qiaochu Xue, Zeyu Liu, Dachun Zhao, Linghan Cai y Yueming Jin; el preprint apareció en arXiv el 21 de julio de 2026 y para el 25 de agosto ya iba por la cuarta versión (arXiv:2607.19261, cs.CV / cs.AI). Esa frecuencia de revisiones ya sugiere por sí sola que los autores consideran el tema vivo y controvertido.
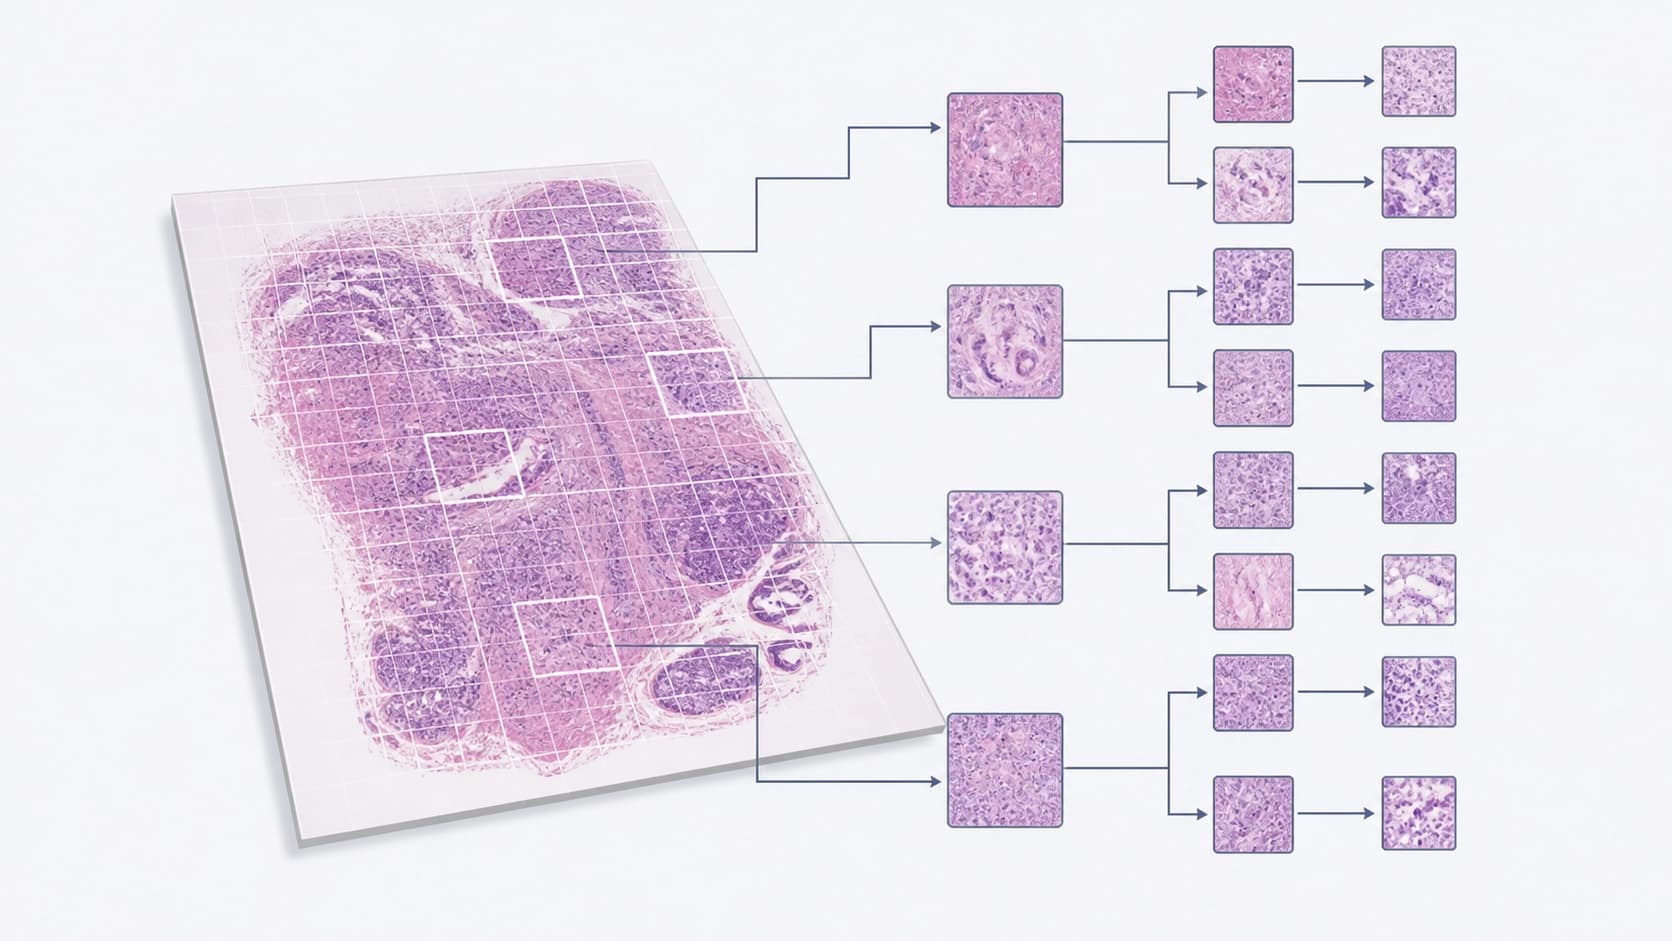
Cómo está estructurado el benchmark
EviPathBench no está construido como un conjunto de preguntas sueltas con opciones de respuesta, sino como un árbol diagnóstico. Las regiones anidadas unas dentro de otras a distintos aumentos están vinculadas a hallazgos específicos de cada escala y, en última instancia, a un diagnóstico del nivel de un informe patológico. Al modelo no se le pide simplemente que emita la etiqueta «cáncer», sino que recorra una cadena: encontrar la región, describir el hallazgo en ese aumento, subir un nivel, conciliar los datos entre escalas y reunirlos en una conclusión general.
Cuatro capacidades evaluables
Los autores descompusieron la habilidad de trabajar con una lámina en sus componentes y evalúan cada una por separado:
- Emparejamiento de imagen con texto — interpretación de la prueba, cuando el modelo relaciona lo visto con una descripción.
- Consulta textual a la imagen (retrieval) — verificación: a partir de una formulación hay que localizar en la lámina el fragmento correspondiente.
- Localización de la región diagnóstica — la recolección de pruebas propiamente dicha: dónde buscar exactamente.
- Razonamiento multinivel — integración de los hallazgos obtenidos a distintos aumentos en una imagen única.
Esta división es valiosa en sí misma: muestra que «entender la lámina» no es una sola capacidad, sino varias, y que pueden divergir mucho entre sí.
Datos y anotación
La base la constituyen 1 822 WSI de TCGA y 17 135 rutas diagnósticas, anotadas por diez patólogos certificados. Además, se utiliza una cohorte privada de 190 láminas de cáncer de mama con anotaciones detalladas: es necesaria para comprobar precisamente la exploración autónoma de una preparación completa, sin pistas sobre dónde se encuentra la zona de interés.
Resultados: razonar se consigue, buscar no
En la evaluación participaron 19 modelos «visión-lenguaje» —universales, médicos y especializados en patología— más un modelo de texto de referencia, necesario como punto de partida.
El panorama resultó contrastante. Los mejores modelos abiertos superan el 93% de precisión en el razonamiento multinivel y más del 50% en ambas tareas de emparejamiento cross-modal. En principio, todo parece ir bien.
Pero con la localización de la región diagnóstica hay un problema serio. El mejor resultado en text-guided mean IoU no llega siquiera a 0,09. Esto es peor que una heurística simple que coloca un rectángulo en el centro de la lámina sin analizar absolutamente nada. En otras palabras, un modelo entrenado para mirar el tejido busca peor que un programa que no mira a ninguna parte.
La escala rompe la búsqueda
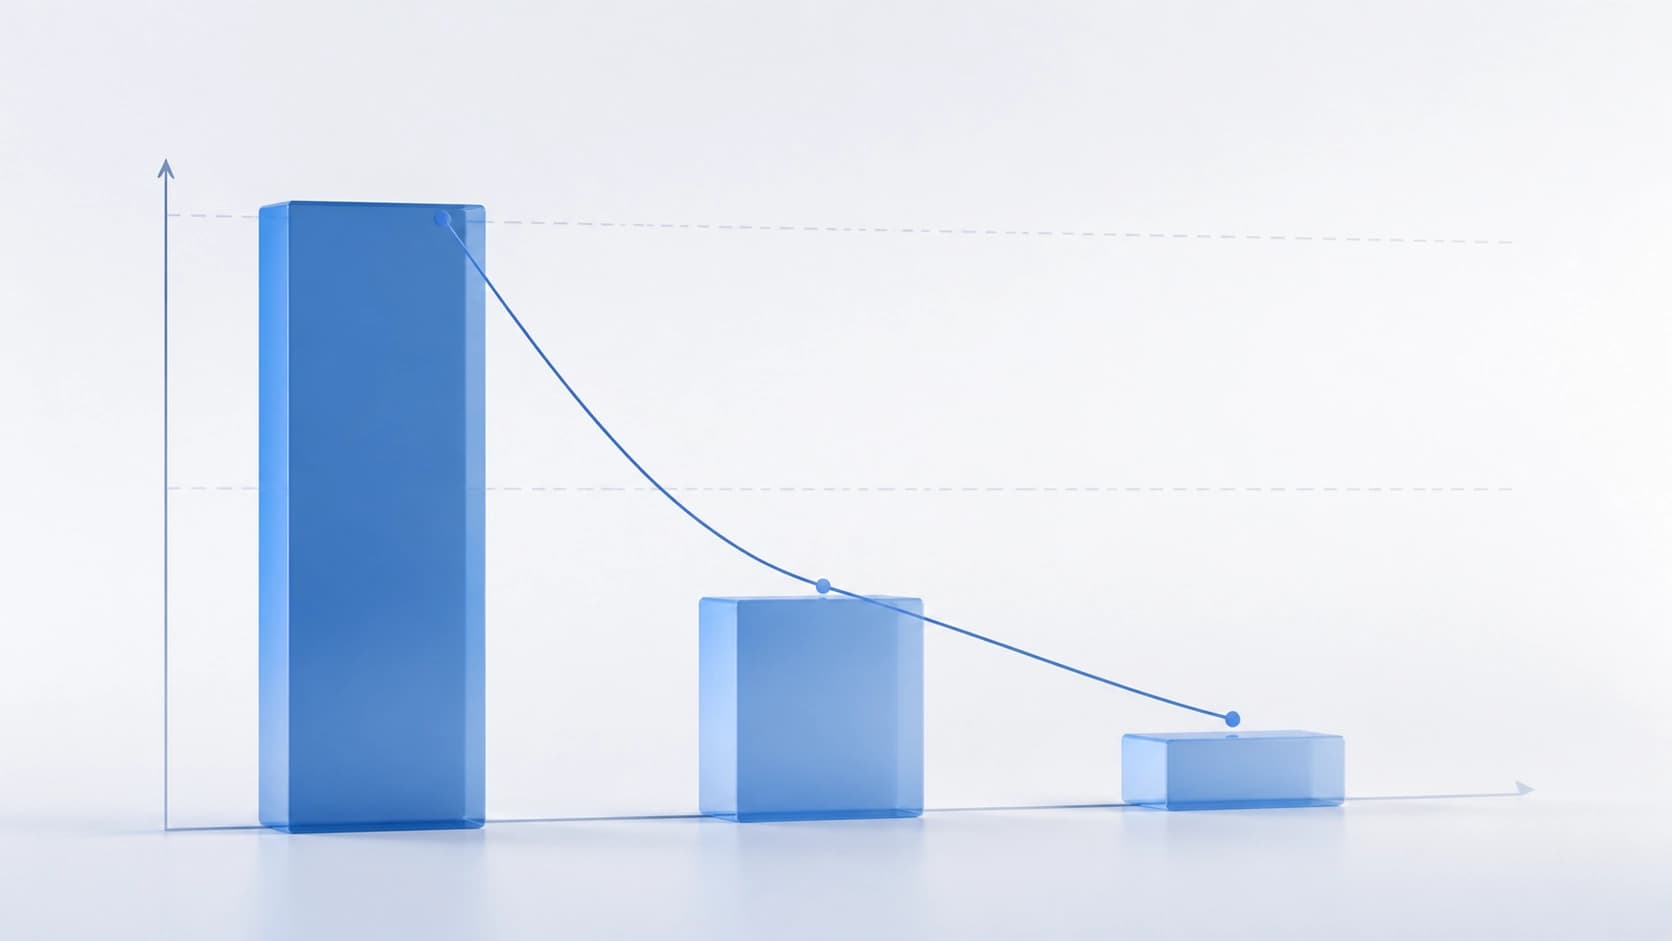
Una línea experimental aparte es la exploración autónoma de la lámina. Aquí la tasa de acierto absoluta se desploma a medida que crece el aumento: 0,522 a bajo aumento, 0,185 a medio y 0,020 a alto. La lógica de esta caída es clara: a bajo aumento el modelo ve la arquitectura general del tejido y acierta con facilidad «en alguna zona correcta», pero cuanto mayor es el zoom, más estrecho es el campo de visión y más caro resulta cada error del paso anterior. Los fallos se acumulan y, hacia el aumento máximo, el modelo casi con seguridad mira donde no debe.
Qué se deduce de esto
La conclusión principal del trabajo se formula de manera sencilla: entre la capacidad de razonar sobre pruebas ya preparadas y la capacidad de obtener esas pruebas media una brecha profunda. Lo primero ya les sale bastante bien a los modelos actuales; lo segundo, casi nada.
Para la práctica, esto significa que la navegación por la lámina todavía no puede dejarse «a merced» del modelo esperando un resultado clínicamente significativo. Sin embargo, el propio benchmark ofrece un marco común: con él se pueden medir ambas capacidades y observar si una mejora concreta —aprendizaje por refuerzo, memoria entre pasos de zoom, búsqueda jerárquica— ayuda a avanzar en la parte que falla.
Conviene tener presentes también las salvedades. La cohorte privada se limita al cáncer de mama, y la mayor parte de los datos son materiales retrospectivos de TCGA, es decir, la variabilidad clínica real no está plenamente representada allí. Las métricas de localización son sensibles a cómo se delimitaron exactamente las fronteras de las regiones, y las cuatro versiones del preprint en un mes indican que las cifras aún pueden precisarse.
Preguntas frecuentes
Material similar
Todos los materiales
OpenCollab: coordinación programable de agentes, entorno de ejecución controlado y métrica de cumplimiento de las normas
El framework integra la definición de la estructura de interacción entre agentes, un entorno común para los experimentos y un seguimiento detallado de los eventos, mientras que la métrica Adherence, introducida en este trabajo, refleja hasta qué punto la ejecución real se ajusta al esquema declarado. En los benchmarks, la configuración Duo alcanza un nuevo nivel de SOTA, mientras que la variante de un solo agente destaca por consumir la menor cantidad de tokens.
11 noviembre 2026
Toollery: selección de herramientas para agentes LLM entre decenas de miles de opciones sin necesidad de ajuste fino
Toollery construye un índice de búsqueda a partir de las descripciones de habilidades y herramientas y, al recibir una consulta, solo envía al modelo un conjunto limitado de candidatos. En experimentos con bibliotecas de hasta decenas de miles de funciones, el enfoque permite mantener la calidad de selección con un top-K fijo, aunque el efecto final depende del perfil de carga y del almacenamiento en caché del proveedor.
11 noviembre 2026
Diagnóstico por etapas de agentes GUI al analizar dashboards: el benchmark DashAct
Se presenta DashAct, un benchmark de 348 trayectorias verificadas por humanos que desglosa el trabajo de los agentes GUI con paneles interactivos en tres etapas y cuatro condiciones visuales. Los resultados revelan problemas persistentes para predecir acciones y vincularlas con objetivos visuales, así como la dependencia de las respuestas de los agentes del apoyo contextual y espacial.
11 noviembre 2026