
Resistencia de los detectores al texto generado por máquinas y parafraseado: qué revelaron las pruebas
El artículo recopila los resultados de las pruebas de herramientas que reescriben fragmentos generados para darles un estilo más natural. Tras este procesamiento, la detectabilidad disminuye notablemente, y los falsos positivos que persisten impiden considerar el veredicto del detector como una prueba.
Cómo cambia la paráfrasis el texto y las señales de los detectores
El contenido de IA humanizado es texto generado por máquinas que se ha parafraseado para que suene más natural. Las herramientas cambian la elección de palabras, la longitud de las oraciones y el tono. Algunas añaden un ritmo irregular o reescriben el texto varias veces. Estos cambios alteran las señales en las que se basan los detectores: la previsibilidad de las palabras y la variación en la longitud de las oraciones.
- elección de palabras;
- longitud de las oraciones;
- tono;
- ritmo irregular;
- reescritura repetida.
Conclusión: la paráfrasis cambia precisamente los rasgos que permiten a los detectores distinguir el texto generado por máquinas.
Qué revelaron las pruebas de textos parafraseados
Las pruebas evaluaron si los detectores seguían siendo fiables después de parafrasear el texto. Un estudio de 2025 analizó 19 herramientas de humanización y paráfrasis.
| Prueba | Resultado |
|---|---|
| Estudio de 2025, 19 herramientas | Muchos detectores no reconocen el texto humanizado. |
| Google Research | El modelo de paráfrasis conserva el significado y evita en gran medida la detección. |
| Paráfrasis de ChatGPT con QuillBot | La precisión del detector en textos de ChatGPT cayó al 49%. |
| Otra prueba | La paráfrasis de ChatGPT logró eludir cada detector al menos en la mitad de los casos. |
| Stanford, lenguaje literario | La detección de texto de IA bajó del 100% al 13% cuando se pidió a ChatGPT que usara un lenguaje más literario. |
Conclusión: los detectores son poco fiables ante textos generados por máquinas y parafraseados.
Qué detectan los detectores en el texto
Los detectores se basan en rasgos que no siempre están relacionados con el origen automatizado del texto. Investigadores de Carnegie Mellon concluyeron que el texto de los modelos básicos a menudo parecía escrito por una persona para GPTZero y Pangram. No ocurría lo mismo con el texto de modelos ajustados para seguir instrucciones. El equipo considera que los detectores rastrean más bien huellas del entrenamiento del modelo que un indicador fiable de escritura automatizada.
- modelos básicos: el texto suele parecer escrito por una persona para GPTZero y Pangram;
- modelos ajustados para seguir instrucciones: el texto no parece escrito por una persona;
- conclusión del equipo: los detectores rastrean huellas del entrenamiento.
Stanford probó siete detectores con 91 ensayos de autores cuyo idioma nativo no era el inglés. La tasa media de falsos positivos fue del 61,3%. Al menos una herramienta marcó más del 91% de los ensayos. Los ensayos de autores nativos de inglés obtuvieron resultados cercanos a cero. Los investigadores atribuyen la diferencia a una elección de palabras sencilla y predecible, que los detectores confunden con texto generado por máquinas.
Conclusión: una señal del detector no demuestra que el texto se haya generado automáticamente; por eso, la evaluación requiere contexto.
La precisión declarada y sus limitaciones reales
Las pruebas independientes y las realizadas por los propios proveedores ofrecen estimaciones de precisión distintas. Las condiciones de evaluación cambian los resultados.
- Análisis de pruebas independientes: la precisión de Turnitin, GPTZero y Originality.ai se sitúa entre el 70% y el 85%. Estas herramientas siguen teniendo problemas con los falsos positivos.
- Turnitin afirma tener una precisión del 98% y una tasa de falsos positivos inferior al 1%. Esta afirmación solo se aplica a documentos en los que la IA generó más del 20% del texto.
- OpenAI cerró su propio clasificador en julio de 2023. El clasificador detectaba solo el 26% del texto generado por IA.
- Los autores del estudio de 2025 entrenaron un modelo con muestras humanizadas. El modelo detectaba texto humanizado con una tasa baja de falsos positivos. También mantuvo su eficacia ante intentos de engañarlo. Los resultados proceden de los propios autores del modelo; se necesitan pruebas independientes.
Conclusión: la precisión declarada depende de las condiciones, y las pruebas independientes muestran los límites de la detección.
Evaluación práctica de un detector
Los expertos recomiendan considerar la puntuación de un detector como una pista, no como una prueba. Para comprobarlo, se puede tener en cuenta el historial de borradores, hacer preguntas orales breves y comparar el texto con trabajos realizados en clase. Los expertos aconsejan a autores y editores solicitar fuentes, entrevistas y datos originales.
- historial de borradores;
- preguntas orales breves;
- comparación con trabajos realizados en clase;
- fuentes, entrevistas y datos originales para autores y editores.
Criterio práctico: el detector sirve como señal para realizar comprobaciones adicionales, no como único fundamento para llegar a una conclusión.
Preguntas frecuentes
Material similar
Todos los materiales
FedSocket: modelos intercambiables con ejecución obligatoria en el receptor ante la heterogeneidad multimodal
Se propone FedSocket, un enfoque en el que el modelo intercambiado debe poder ejecutarse en el lado del receptor y los distintos modelos privados se conectan mediante una interfaz común de predicción Q. El artículo describe una agregación que tiene en cuenta la pertenencia, el envío únicamente de los parámetros de Q junto con los contadores y experimentos con seis conjuntos de datos que demuestran un aumento de la precisión cuando faltan modalidades y la ventaja de la inferencia conjunta frente a los ensamblajes independientes.
13 noviembre 2026
CyberArena: los enfrentamientos por parejas entre agentes de IA revelan los límites de los benchmarks estáticos de ciberseguridad
El benchmark sitúa a dos agentes en entornos aislados con servicios que cambian continuamente y, tras una serie de rondas, resume sus acciones en puntuaciones multidimensionales de habilidades ofensivas y defensivas. En 466 partidas con 12 modelos de última generación, distinguió capacidades allí donde las pruebas unidireccionales alcanzan su límite, incluido el razonamiento a varios turnos y la creación de puertas traseras.
13 noviembre 2026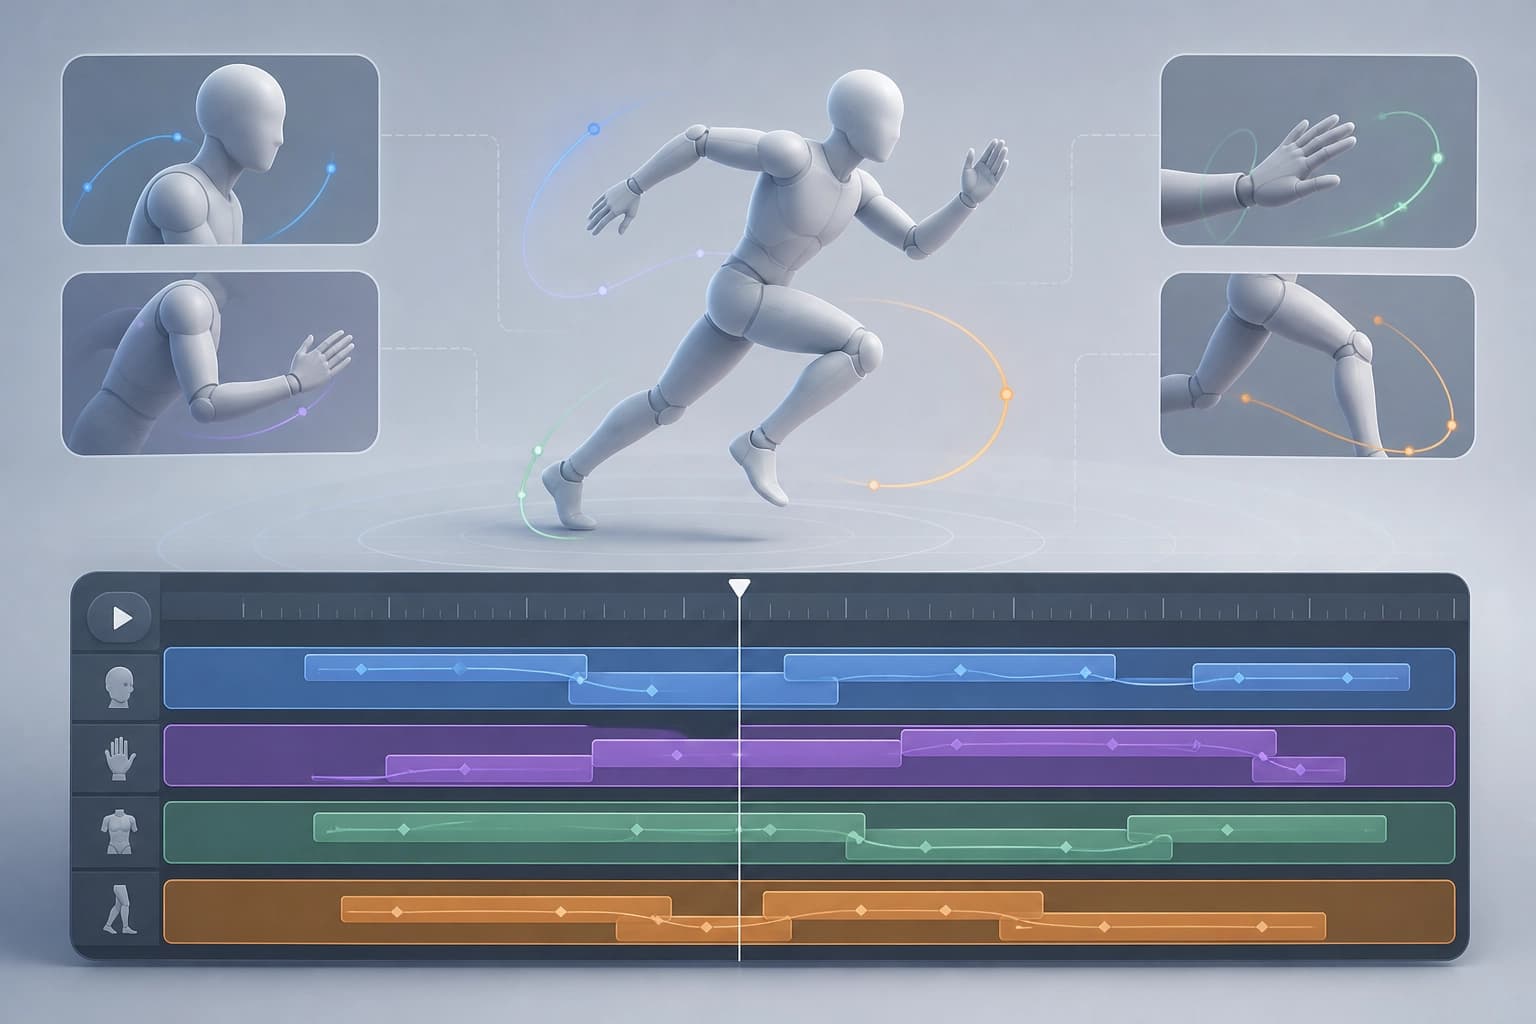
Nuevos comandos durante la síntesis: línea de tiempo multipista para movimientos humanos en 3D
Se propone un método que acepta nuevas instrucciones de texto durante la síntesis y permite definir de forma independiente intervalos de acción superpuestos. La coordinación de movimientos simultáneos de distintas partes del cuerpo se garantiza mediante el condicionamiento por intervalos y un procedimiento de eliminación de ruido que tiene en cuenta las partes del cuerpo; en TimelineMotion y MTT, los autores informan de una mayor correspondencia con la semántica y las restricciones temporales que las soluciones de referencia en streaming.
12 noviembre 2026