
Método CHOIR: la enumeración libre revela las posiciones divergentes de los modelos dentro de sistemas colectivos
Los autores proponen el enfoque CHOIR, en el que los conjuntos solicitan repetidamente listas ordenadas de respuestas y luego comparan la prominencia de los conceptos agregados entre modelos, formulaciones de prompts y condiciones de rol. El trabajo muestra que una gran similitud externa entre las respuestas abiertas no implica consenso: la identidad del modelo subyacente sigue siendo el rasgo diferenciador más estable, mientras que las configuraciones de personajes desplazan los conceptos que se manifiestan.
Qué aporta CHOIR
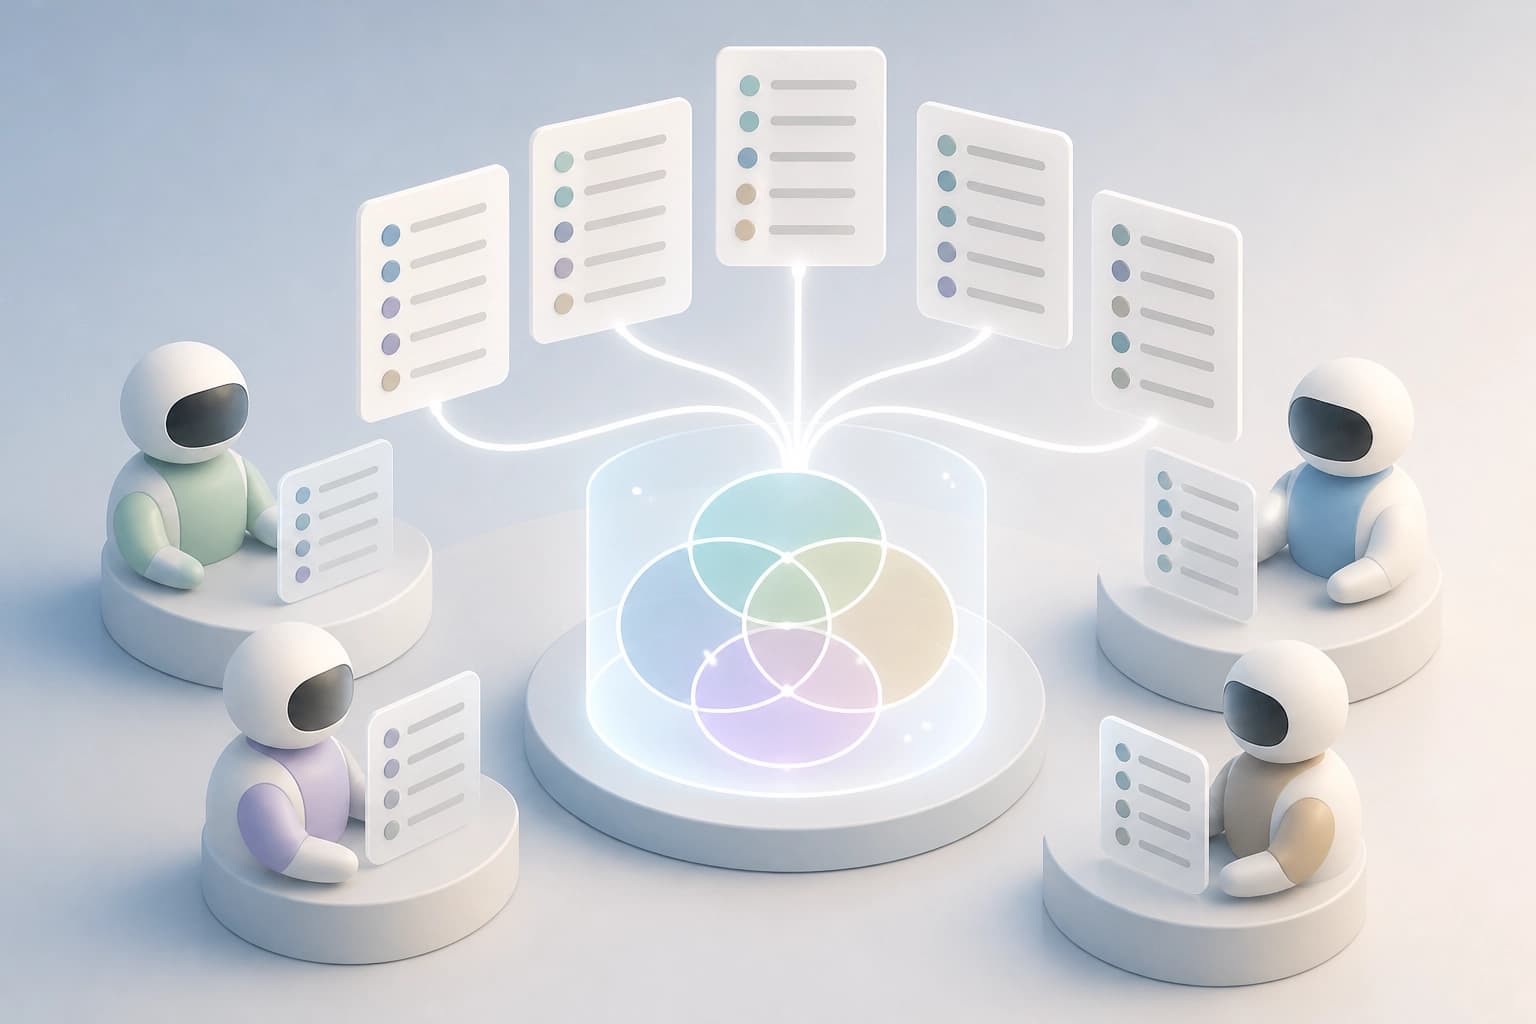
CHOIR significa Collective Hierarchically-Ordered Inquiry Responses. El enfoque adapta la elicitación mediante listas libres a los conjuntos de LLM. Su objetivo es sacar a la luz las posiciones en las que los modelos del conjunto discrepan. El acuerdo superficial entre las respuestas oculta esas discrepancias.
El método trabaja con enumeraciones, no con formulaciones ya preparadas. Las consultas repetidas proporcionan material sobre los temas que los modelos plantean por sí mismos. Después, ese material se normaliza para poder compararlo.
Criterio práctico: recurrir a CHOIR cuando las respuestas del conjunto parezcan iguales, pero se necesite entender en qué aspectos concretos difieren los modelos.
Etapas del método
El método consta de tres pasos.
- Consultar repetidamente a los modelos del conjunto para obtener listas ordenadas.
- Agrupar los elementos de las listas en conceptos a nivel de prompt.
- Medir la prominencia de los conceptos entre modelos, variantes de prompts y condiciones con personas.
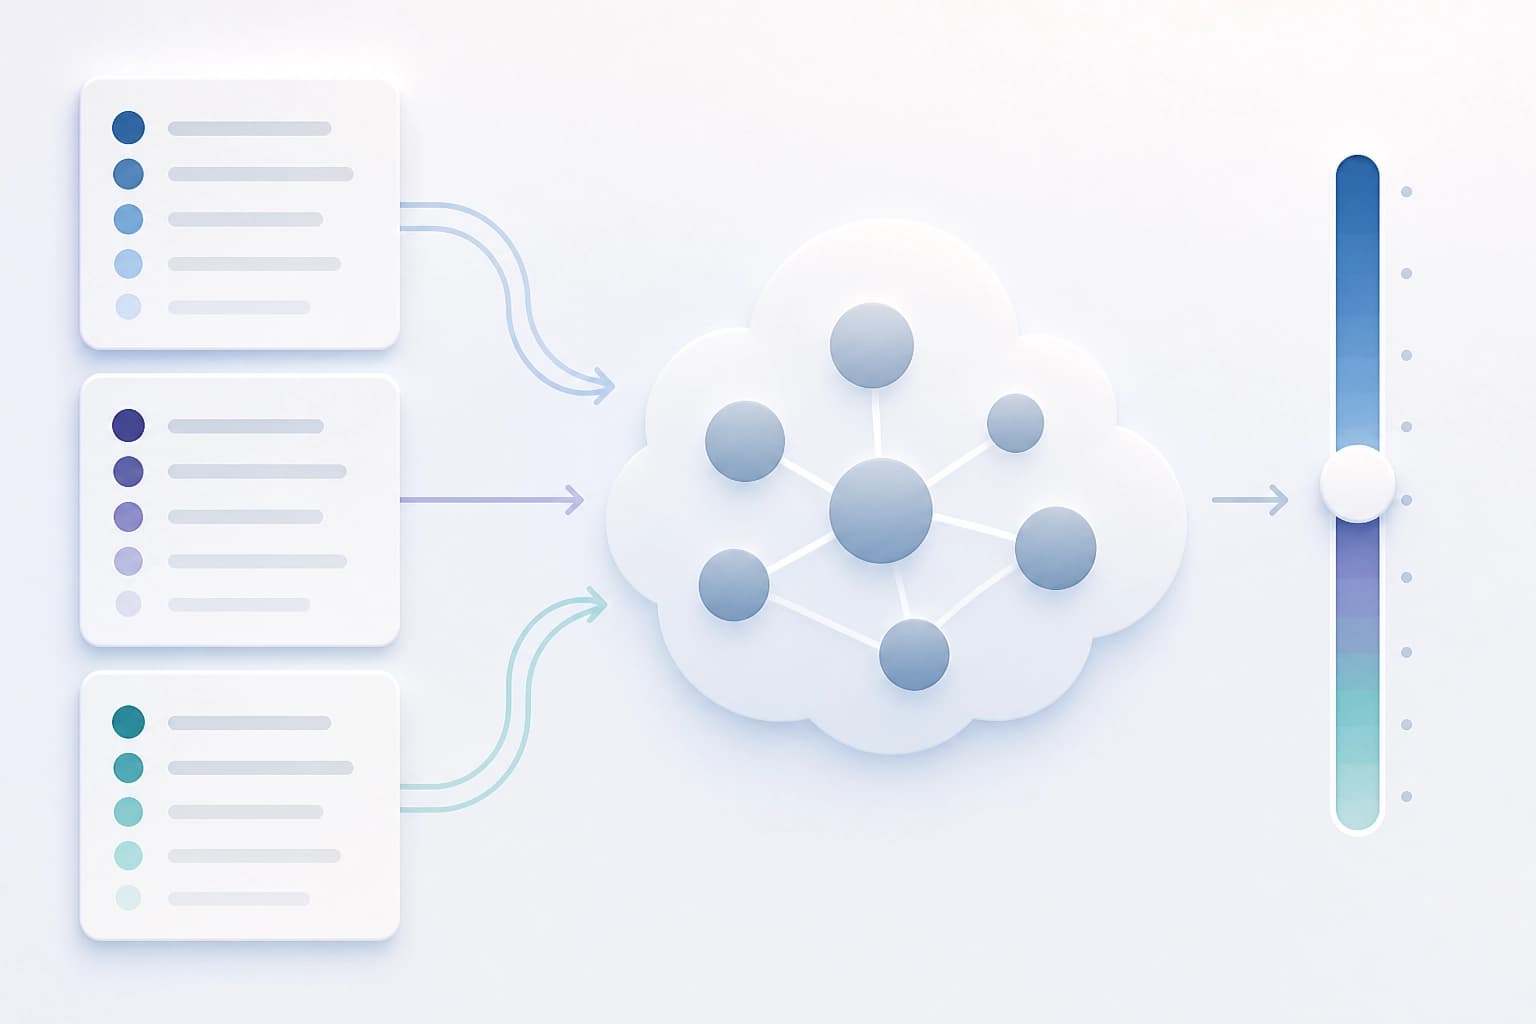
Cada paso añade una dimensión. Las listas aportan el material en bruto, la agrupación lo normaliza para poder compararlo y la medición de la prominencia muestra las diferencias. Sin reducir los elementos a conceptos, la comparación se limita a palabras aisladas.
Criterio práctico: evaluar el método según si conserva las diferencias después de agrupar los elementos en conceptos.
Con qué conjuntos se probó
| Conjunto | Qué es | Qué mostró |
|---|---|---|
| Infinity-Chat 100 | Conjunto externo de prompts de un estudio reciente sobre la homogeneidad de las respuestas abiertas de los modelos | Reproduce un alto nivel de acuerdo superficial: 93/100 prompts superan el nivel aleatorio. Distingue los prompts específicos de los amplios, en los que se revela una profundidad oculta en las respuestas |
| Conjunto de diagnóstico específico | 27 preguntas diseñadas para detectar diferencias a nivel de mecanismos | Sirve para realizar comprobaciones específicas de las discrepancias entre modelos |
Los conjuntos cumplen funciones diferentes. El conjunto externo muestra el panorama general del acuerdo y, al mismo tiempo, distingue los prompts amplios de los específicos. El conjunto específico está diseñado para detectar diferencias a nivel de mecanismos.
Criterio de selección: usar el conjunto externo de prompts para obtener una visión general del acuerdo y el conjunto de diagnóstico para analizar los mecanismos.
Qué señales de diferencias se aprecian
Las observaciones se agrupan en tres categorías.
- La identidad del modelo base sigue siendo la señal más sólida que se puede recuperar. Esto es así tanto en las comprobaciones específicas como en el conjunto externo de prompts.
- Los prompts con personas desplazan los conceptos que se manifiestan dentro de las firmas de los modelos base.
- Un módulo de clasificación que desconoce la fuente identifica candidatos poco frecuentes, pero estables, para estudiarlos posteriormente.
Las personas modifican la manifestación de los conceptos, pero no eclipsan la señal del modelo base. La clasificación sin conocimiento de la fuente funciona como filtro para un análisis posterior.
Criterio práctico: primero fijar el modelo base y después evaluar el desplazamiento provocado por la persona.
Un marco de diagnóstico en lugar de una constatación de acuerdo
Los autores proponen considerar la homogeneidad de las respuestas abiertas como un problema de diagnóstico. La pregunta pasa a ser otra: en qué aspectos coinciden los modelos, por qué coinciden y qué más se puede detectar.
- En qué coinciden: mapa de los conceptos compartidos entre modelos.
- Por qué coinciden: causas subyacentes al acuerdo superficial.
- Qué más se aprecia: candidatos identificados por la clasificación sin conocimiento de la fuente.
El artículo se publicó en Proceedings of the Third Conference on Language Modeling (COLM 2026), 2026. Se presentó en arXiv el 29 de septiembre de 2026. Sus autores son Ben Wigler y Maria Tsfasman.
Criterio: la homogeneidad de las respuestas no es una conclusión definitiva, sino el punto de partida para diagnosticar su profundidad.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026