
Gestión centralizada de la memoria en IA multiagente: personalización con menores costes
Los autores proponen una capa de memoria compartida y sistemática: los agentes guardan información estructurada, mientras que el sistema controla su selección, la protección de datos y su transmisión a los modelos. En las pruebas con AIOS, este enfoque mejoró la personalización frente al almacenamiento externo y RAG, y redujo la latencia entre un 15 % y un 61 % en comparación con la transmisión del contexto completo, con resultados comparables en dos de los tres modelos.
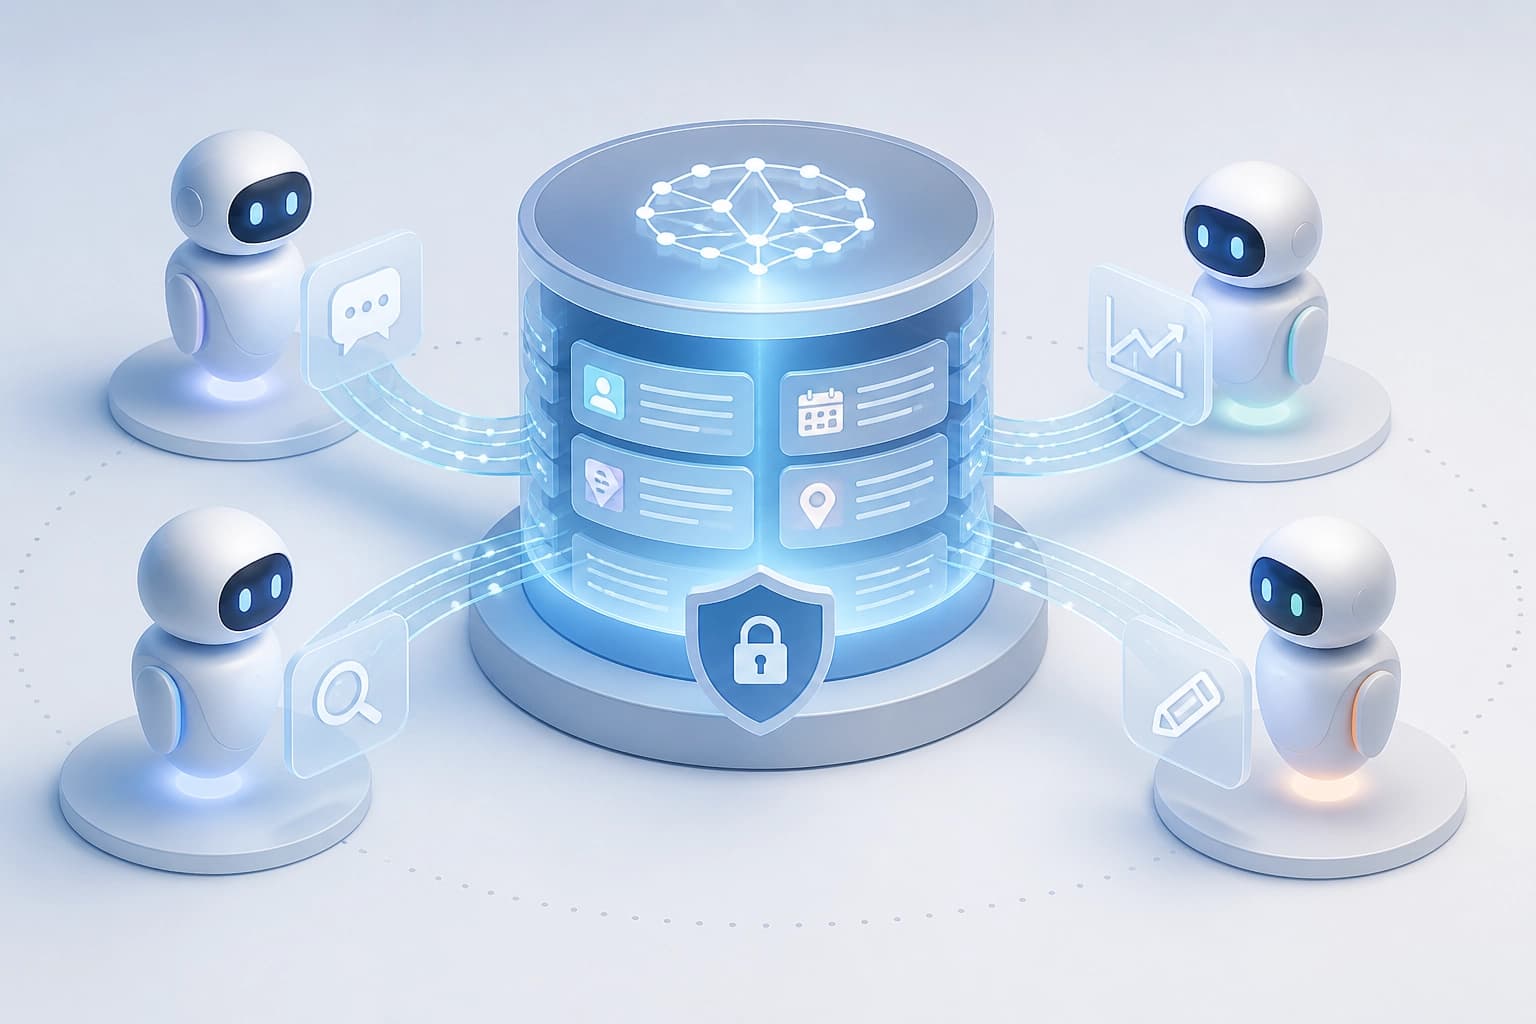
Cómo funciona la memoria central
Los agentes especializados registran recuerdos estructurados con etiquetas. El núcleo del sistema de agentes gestiona su recuperación, confidencialidad e incorporación al prompt.
En este esquema, los agentes crean recuerdos y el núcleo determina cómo los utiliza el sistema:
- Registro: los agentes guardan recuerdos estructurados y etiquetados.
- Recuperación: la gestiona el núcleo, no los agentes por separado.
- Protección e incorporación: el núcleo se encarga de la confidencialidad y de añadir los recuerdos al prompt.
La centralización separa la creación de recuerdos del control sobre su uso. Esto es importante si las reglas de recuperación e incorporación deben aplicarse a todo el sistema de agentes.
Cómo se evaluó el enfoque
El diseño se implementó y evaluó en AIOS. Los autores lo compararon con tres alternativas en tres modelos asistentes.
- GPT-4o
- Llama-3.1:8B
- Qwen-2.5:7B
En total, el estudio incluyó 1 800 pruebas. Esta parte del trabajo describe el alcance de la evaluación, no las condiciones específicas de cada comparación.
Qué mostraron las comparaciones
Los resultados dependen de cómo se gestione la memoria. La tabla recoge las conclusiones de los autores para las tres alternativas.
| Alternativa | Resultado de la gestión centralizada |
|---|---|
| Mem0 con el mismo almacenamiento subyacente | Las puntuaciones de personalización aumentaron entre 2,4 y 4,0 puntos en una escala de cinco puntos. Todas las comparaciones son estadísticamente significativas: p < 10^-18. |
| Incorporación estándar mediante generación aumentada por recuperación | Las mejoras fueron grandes y consistentes en los tres modelos. |
| Concatenación completa y sin filtrar del contexto | En dos modelos, los resultados son estadísticamente comparables; en el tercero, la variante centralizada quedó ligeramente por debajo. Los prompts fueron más cortos y la latencia de extremo a extremo se redujo entre un 15 y un 61 % en todos los modelos. También disminuyeron los tokens por llamada y el coste de inferencia. |
Para GPT-4o, un ejemplo de puntuación de uso del perfil pasó de 1,05 a 4,69. Este indicador ilustra el resultado de la comparación con Mem0.
Cuándo plantearse la centralización
Conviene plantearse la gestión centralizada de la memoria si el sistema necesita reglas comunes para la recuperación, la protección y la incorporación de recuerdos. Este enfoque traslada esas decisiones de los agentes individuales al núcleo del sistema.
Un criterio práctico es sopesar la personalización necesaria frente al volumen de contexto y los costes admisibles. Los autores concluyen que la centralización ofrece la mayor parte de las ventajas de personalización de un contexto ilimitado con unos costes considerablemente menores.
El artículo se basa en Kernel-Managed Shared Memory for System-Wide Personalization de Ryan Lum y Yongfeng Zhang, presentado el 9 de septiembre de 2026.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026