
CEG-Agent: análisis causal de fallos en trazas de agentes LLM mediante grafos de errores
El trabajo presenta CEG-Agent, un framework con herramientas para el diagnóstico causal de trazas de agentes. La clasificación formal distingue entre anomalías, errores y fallos, mientras que los grafos tipados de CEG conectan los eventos de ejecución con nodos de diagnóstico y fallos finales; el benchmark CEG-Bench confirma el liderazgo del enfoque en precisión semántica y estructural.
Dónde falla el diagnóstico de las trazas de agentes
En aplicaciones complejas se utilizan agentes basados en LLM. Las trazas de estos agentes son largas. Esto dificulta el diagnóstico de fallos.
Los métodos de diagnóstico existentes mezclan anomalías, errores y fallos. Por ello, los objetivos del diagnóstico se vuelven ambiguos.
Los métodos no modelan de forma estructurada cómo se propagan y se agravan los errores causalmente relevantes. Los fallos finales de las tareas quedan sin una atribución fiable.
Criterio práctico: un método de diagnóstico debe distinguir entre tipos de desviaciones y rastrear las relaciones causales entre ellas.
Qué es CEG-Agent
CEG-Agent es un marco de agentes que utiliza herramientas. Realiza un diagnóstico causal de las trazas de agentes.
El marco introduce una taxonomía explícita de anomalías, errores y fallos. A partir de ella, construye Causal Error Graphs (CEGs).
| Enfoque | Distinción entre anomalías, errores y fallos | Modelo de propagación de errores |
|---|---|---|
| Métodos de diagnóstico existentes | Mezclan estos conceptos | No modelan de forma estructurada |
| CEG-Agent | Introduce una taxonomía explícita | Construye CEGs con relaciones causales |
Criterio de selección: el marco debe ofrecer objetivos de diagnóstico inequívocos y basarse en un modelo tipado de causas.
Causal Error Graphs: una representación tipada de las causas
Los CEGs son una representación tipada unificada. Vinculan los elementos de la traza mediante relaciones causales.
El grafo incluye tres tipos de elementos:
- eventos de ejecución;
- nodos de diagnóstico;
- resultados en forma de fallos.
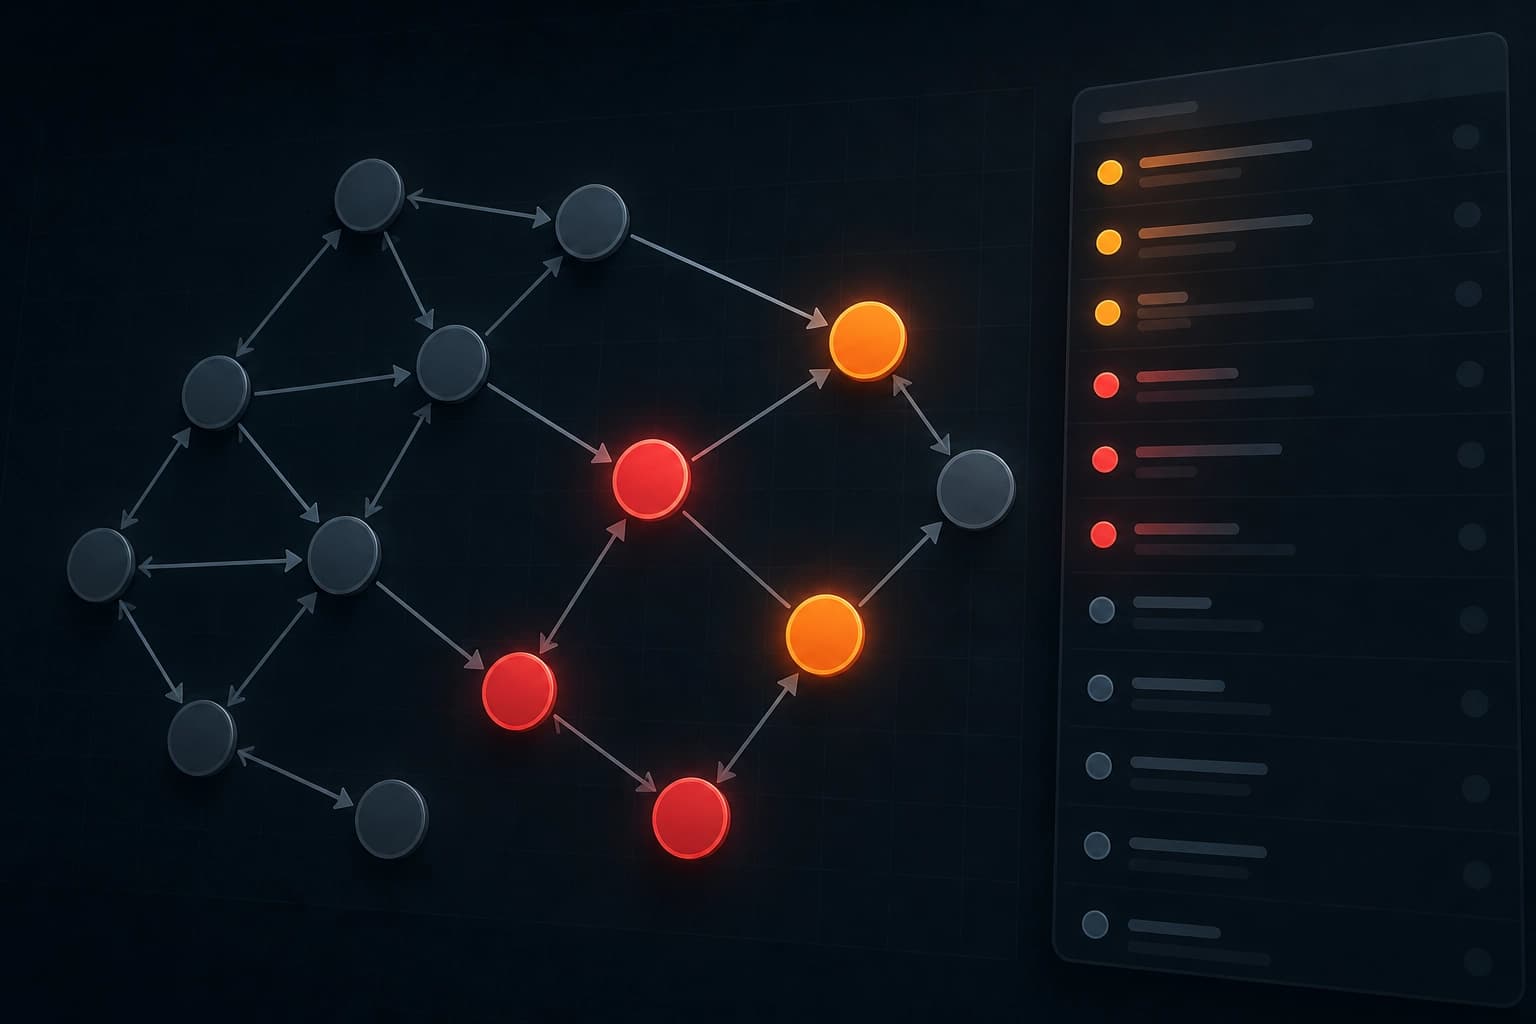
Todos los elementos están vinculados por relaciones causales en un formato unificado. Esto distingue al grafo de un conjunto de señales inconexas.
Criterio: la representación debe vincular la ejecución con el fallo final mediante relaciones causales explícitas.
CEG-Bench y el etiquetado mediante AAAP
Para evaluar el diagnóstico causal de trazas se creó CEG-Bench. Es un benchmark con etiquetado totalmente agéntico.
Las anotaciones CEG del benchmark se obtuvieron mediante el Adversarial Agentic Adjudication Protocol (AAAP). Las anotaciones son altamente fiables y coherentes.
Las anotaciones se validaron con un conjunto de referencia humano elaborado por expertos. Las anotaciones automáticas mostraron una correspondencia estrecha con las de los expertos.
Criterio: un benchmark con anotaciones validadas frente a un conjunto de referencia humano es adecuado para comparar métodos de diagnóstico causal.
Resultados y criterio de selección
En los experimentos con CEG-Bench, CEG-Agent obtiene resultados de vanguardia. La evaluación se realizó según dos criterios.
El primer criterio es la evaluación semántica con tolerancia. El segundo es la evaluación estructural precisa. El marco obtiene resultados de vanguardia en ambos.
Criterio de selección: si la tarea requiere un análisis correcto tanto en términos semánticos como estructurales, conviene tomar como referencia un método con resultados de este nivel.
Preguntas frecuentes
Material similar
Todos los materiales
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026
Modelo del mundo para agentes basados en LLM cerrados: corrección en puntos de riesgo
Se propone PAWM, un predictor externo que no duplica la observación paso a paso, sino que se activa cuando es probable que ocurra un fallo y desvía al agente de una acción equivocada. Tras el ajuste fino supervisado (SFT) con escenarios sintéticos y el coentrenamiento con GRPO, el método logró una mejora del 24,3 % en ScienceWorld y del 7,7 % en WebArena-Lite para Claude Sonnet 4.5.
4 noviembre 2026
Capa de clasificación sobre SpeechLLM: dónde supera a la generación de etiquetas en el reconocimiento de emociones
En IEMOCAP y MELD se compara la predicción generativa de etiquetas emocionales con un clasificador lineal aplicado a las representaciones ocultas de una SpeechLLM compacta. La mejora en la calidad que aporta el clasificador no es universal: depende del corpus y de si se utilizan transcripciones de referencia o resultados de ASR.
4 noviembre 2026