
CARAT: comprueba si los LLM de ciencia de materiales infieren estructuras o reformulan la indicación
El trabajo propone un protocolo que fija la pregunta y la respuesta de referencia con ocho formas de presentar la estructura y marca por separado las relaciones en GraphSpace. Los experimentos con ajuste fino por pares, enmascaramiento de campos objetivo y adición de evidencias muestran que el modelo puede aprender tanto a aplicar una relación como a seguir un enlace; sin embargo, eliminar el enlace reduce la precisión por debajo del nivel de los recorridos heurísticos.
Por qué la precisión no demuestra razonamiento
Un modelo lingüístico para la ciencia de materiales puede dar una respuesta correcta por dos motivos distintos. Puede deducirla a partir de datos estructurales o reproducir un valor que ya está presente en la entrada. La métrica habitual de precisión no distingue entre estos casos. Una descripción estructural puede contener el campo que se usa para evaluar la respuesta, en cuyo caso la puntuación refleja la lectura de una pista.
El benchmark CARAT se basa en esta distinción. Comprueba si los LLM de ciencia de materiales razonan a partir de datos estructurales o se limitan a repetir la pista. Los autores del artículo son Jiajun Wu, Jian Yang, Zixiang Ni, Zhenzhu Li y Bin Chong; el trabajo se presentó el 29 de septiembre de 2026.
Criterio práctico: una alta precisión con datos estructurales, por sí sola, no demuestra nada. Lo que importa son las condiciones en las que se obtuvo la respuesta.
Cómo funciona la comparación emparejada
La pregunta y la respuesta de referencia se mantienen sin cambios en ocho representaciones emparejadas. Las relaciones estructurales se indican por separado, en GraphSpace.
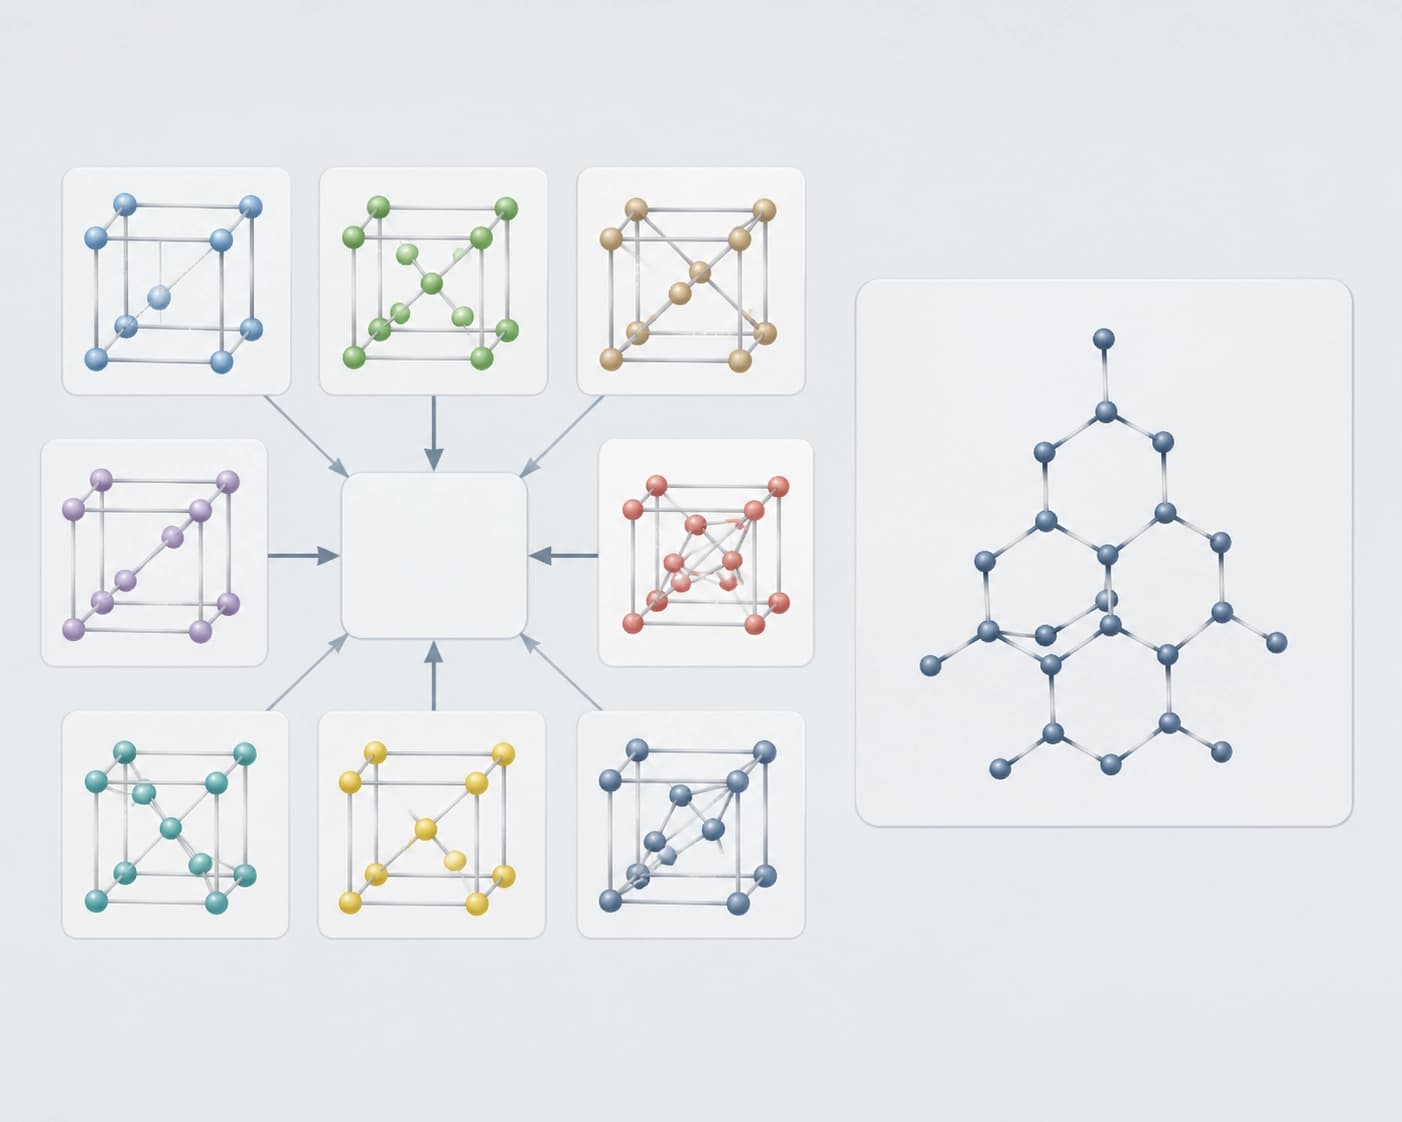
A esto se añaden el ajuste fino emparejado, el enmascaramiento de respuestas, la incorporación de evidencias, la inferencia por pares y una regla que permite abstenerse de afirmar algo.
| Qué se compara | Diferencia |
|---|---|
| Representación con estructura frente a entrada con solo la fórmula en las familias de tareas más difíciles | 17.3 puntos |
Una pregunta fija descarta que la diferencia se deba a la formulación de la tarea. El enmascaramiento de respuestas impide que el modelo introduzca un valor ya preparado.
Conclusión: solo tiene sentido comparar representaciones si la pregunta y la respuesta de referencia no cambian. De lo contrario, la diferencia reflejará la calidad del texto de la tarea, no el uso de la estructura.
Cuál es la diferencia entre GraphSpace y un grafo simple
GraphSpace supera a un grafo periódico simple por 19.3 puntos. Esta diferencia se debe a dos efectos distintos.
| Condición | Diferencia |
|---|---|
| La representación simple contiene todo lo necesario para responder | 1.96 puntos |
| La representación simple no contiene en absoluto esos campos | 46.7 puntos |
Cuando la representación básica basta para responder, la ventaja casi desaparece. Cuando no contiene los campos necesarios, la diferencia aumenta. Los autores señalan que el resultado principal de la comparación refleja la falta de datos en la representación básica, no la forma de representar las evidencias.
Criterio práctico: antes de concluir que una representación es superior, comprueba qué campos contiene. De lo contrario, lo que se mide es la exhaustividad de los datos, no el método.
Atajos y revisión del benchmark
La evaluación reveló un punto débil del conjunto de tareas. Una regla que omite la referencia y lee directamente la lista responde a cuatro de las siete familias de tareas más difíciles. El modelo puede no entender la relación, sino simplemente eludirla.
Se revisó el benchmark. Once de estos atajos pasaron a dar resultados cercanos al azar.
Conclusión: un conjunto de tareas solo sirve para evaluar el razonamiento después de comprobar que no se pueda resolver mediante atajos. Si una regla sencilla resuelve algunas familias, no se está midiendo el razonamiento.
La referencia en la respuesta y el uso de la relación
El modelo congelado cita la referencia, pero da la misma respuesta en el 95.6% de los casos por pares cuando se cambia su destino. El modelo repite la relación sin utilizarla.
| Condición | Porcentaje de casos por pares con la misma respuesta |
|---|---|
| Modelo congelado, se cambia el destino de la referencia | 95.6% |
| Tras el entrenamiento emparejado, se cambia el destino de la referencia | 99.8% |
| Se elimina la referencia | 23.4% |
| Mejor estrategia de atajo | 27.0% |
Tras el entrenamiento emparejado, el porcentaje alcanza el 99.8%. Al eliminar la referencia, baja al 23.4%, por debajo del 27.0% que obtiene la mejor estrategia de atajo. Los autores concluyen que se pueden aprender ambos pasos: usar la relación y basarse en la referencia.
Criterio: citar una referencia no equivale a utilizarla. Hay que comprobar el comportamiento del modelo cuando se cambia el destino de la referencia y cuando se elimina.
Qué implica esto para evaluar herramientas
- Comprueba si la entrada ya contiene la respuesta a la pregunta planteada.
- Examina los resultados al cambiar el destino y al eliminar la referencia, no solo al citarla.
- Exige una descripción de los controles: pregunta y respuesta de referencia invariables, y varias representaciones.
- Averigua si el conjunto de tareas se actualizó después de comprobar los atajos.
- Evalúa la diferencia declarada junto con la composición de los datos, no como una cifra aislada.
Criterio de selección: un resultado merece confianza si no puede explicarse por la presencia del campo necesario en la pista o por la acción de una regla sencilla de atajo.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026