
CaLR: optimización latente con restricciones causales para una inferencia robusta de modelos de difusión
El trabajo presenta CaLR, un enfoque que reduce el razonamiento a una optimización con restricciones en el espacio latente; la estructura proviene de una matriz de topología causal de un modelo experto, y el entrenamiento se basa en la diferenciación implícita. El método mejora la coherencia y permite corregir los resultados intermedios durante la generación paralela, lo que ofrece mejores resultados en conjuntos de datos complejos y en tareas con restricciones estrictas, como el sudoku.
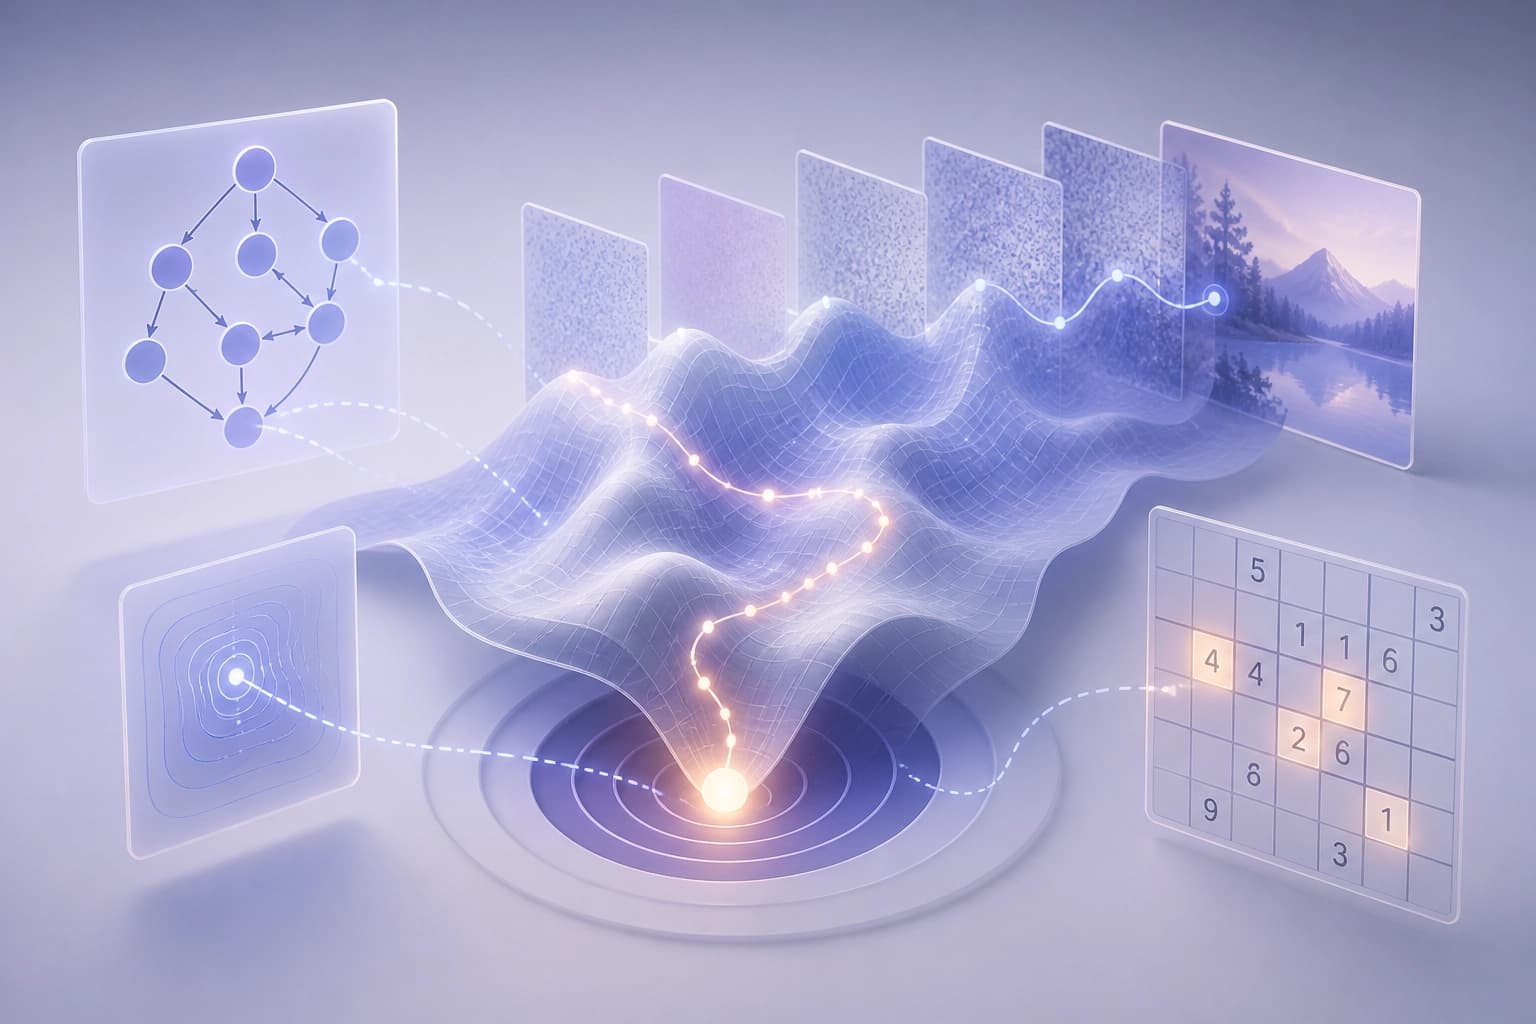
Problema: avidez local de AR y causalidad débil de DLM
Los modelos autorregresivos sufren de avidez local. A los modelos de lenguaje de difusión a menudo les falta una estructura causal estricta para razonar.
| Tipo de modelo | Limitación |
|---|---|
| AR | Avidez local |
| DLM | Falta de una estructura causal estricta para razonar |
Conclusión: para razonar se necesita un mecanismo que conecte la generación con restricciones causales. Criterio práctico: comprobar cómo el modelo mantiene la estructura lógica en los pasos intermedios.
El framework y su objetivo
CaLR es un framework para la inferencia robusta de modelos de difusión. Formula el razonamiento como una optimización latente con restricciones. Nombre completo: «CaLR: Causal Latent Revision for Robust Diffusion Reasoning». Autores: Wei Cai, Jian Zhao, Yuchen Yuan, Xuelong Li. Fecha de envío: 17 sep 2026.
Conclusión: CaLR vincula la inferencia robusta con la optimización de representaciones latentes. Criterio práctico: elegir el método si la tarea requiere una estructura causal en el razonamiento.
Componentes del enfoque
CaLR utiliza tres elementos. El primero es una matriz de topología causal (CTM). La matriz se obtiene de un modelo experto. El segundo es la diferenciación implícita. El tercero es la «revisión del razonamiento» guiada por gradientes.
Matriz de topología causal (CTM)
CTM es una matriz de topología causal. Su fuente es un modelo experto.
Diferenciación implícita
CaLR utiliza la diferenciación implícita.
«Revisión del razonamiento» guiada por gradientes
Esta operación está diseñada para garantizar la coherencia lógica. También está diseñada para corregir dinámicamente por sí misma los pasos intermedios durante la generación paralela.
Conclusión: CTM proporciona la estructura causal, la diferenciación implícita forma parte de la optimización y la revisión del razonamiento corrige los pasos. Criterio práctico: comprobar si hay una fuente de estructura causal y un mecanismo de corrección.
Resultados declarados
CaLR alcanza un rendimiento SOTA de DLM en benchmarks complejos. El framework supera a sólidas líneas de base de AR. Demuestra una mayor robustez en tareas con restricciones, como Sudoku.
| Propiedad | Resultado |
|---|---|
| Rendimiento de DLM | SOTA en benchmarks complejos |
| Comparación con AR | Supera a sólidas líneas de base de AR |
| Robustez | Mayor robustez en tareas con restricciones, como Sudoku |
Conclusión: las ventajas declaradas se refieren a benchmarks complejos y tareas con restricciones. Criterio práctico: comparar los requisitos de la tarea con la robustez en tareas con restricciones. Para otros escenarios, el resumen no aporta datos.
Preguntas frecuentes
Material similar
Todos los materiales
Invariantes polinómicos canónicos en el diagnóstico de fallos de simuladores de RL: dónde son realmente útiles
El estudio analiza si está justificado incorporar leyes físicas a modelos de dinámica entrenables: los invariantes extraídos de las trayectorias y llevados a una forma canónica mediante bases de Gröbner ofrecen una mejora modesta en las predicciones, pero destacan en el diagnóstico: permiten localizar la restricción incumplida e identificar el parámetro concreto que es erróneo.
10 noviembre 2026
AURA-Eval: cómo comprobar que un agente LLM reconoció el riesgo y cambió su siguiente paso
El framework evalúa el comportamiento de los agentes LLM no por su veredicto final, sino por cómo reaccionan ante el riesgo en puntos clave: se interrumpen las trayectorias de llamadas a herramientas y, a continuación, el modelo debe continuar razonando y actuando, mientras que un panel de jueces LLM analiza la detección del riesgo, la naturaleza del paso y su seguridad. En 1249 tareas recopiladas a partir de 157 trayectorias de R-Judge, los actos inseguros aumentan en 20 modelos cuando no hay una vía segura, y retirar la supervisión antes de la ejecución convierte el 52,3 % de los casos inicialmente seguros en inseguros.
10 noviembre 2026
Memoria del reservorio de Chern-Simons: dinámica autónoma de la conectividad y transporte de densidad
El artículo analiza cómo un reservorio conserva el historial de las señales de entrada tanto en la distribución de densidad como en los grados de libertad geométricos. La comparación de cuatro mecanismos muestra que la corriente crea una componente de conectividad independiente que modifica la respuesta posterior de la densidad, y que tener en cuenta todos los rasgos medidos ofrece una pequeña mejora en la decodificación del orden de los impulsos.
10 noviembre 2026