
Pesos activos en lugar de una matriz completa: decodificación INT8 de un modelo de spikes en CPU
El artículo describe una implementación en C++ para un modelo de lenguaje con gating binario por spikes: las proyecciones dispersas se procesan en INT8 y los cálculos solo tienen en cuenta los pesos activos. En una prueba de un solo hilo, la primera versión INT8 alcanzó 23,31 tokens/s frente a los 9,82 de FP32 y redujo la memoria ocupada por los pesos de 3355,2 a 1087,4 MiB; el paso de las proyecciones densas a INT4 redujo el rendimiento de decodificación.
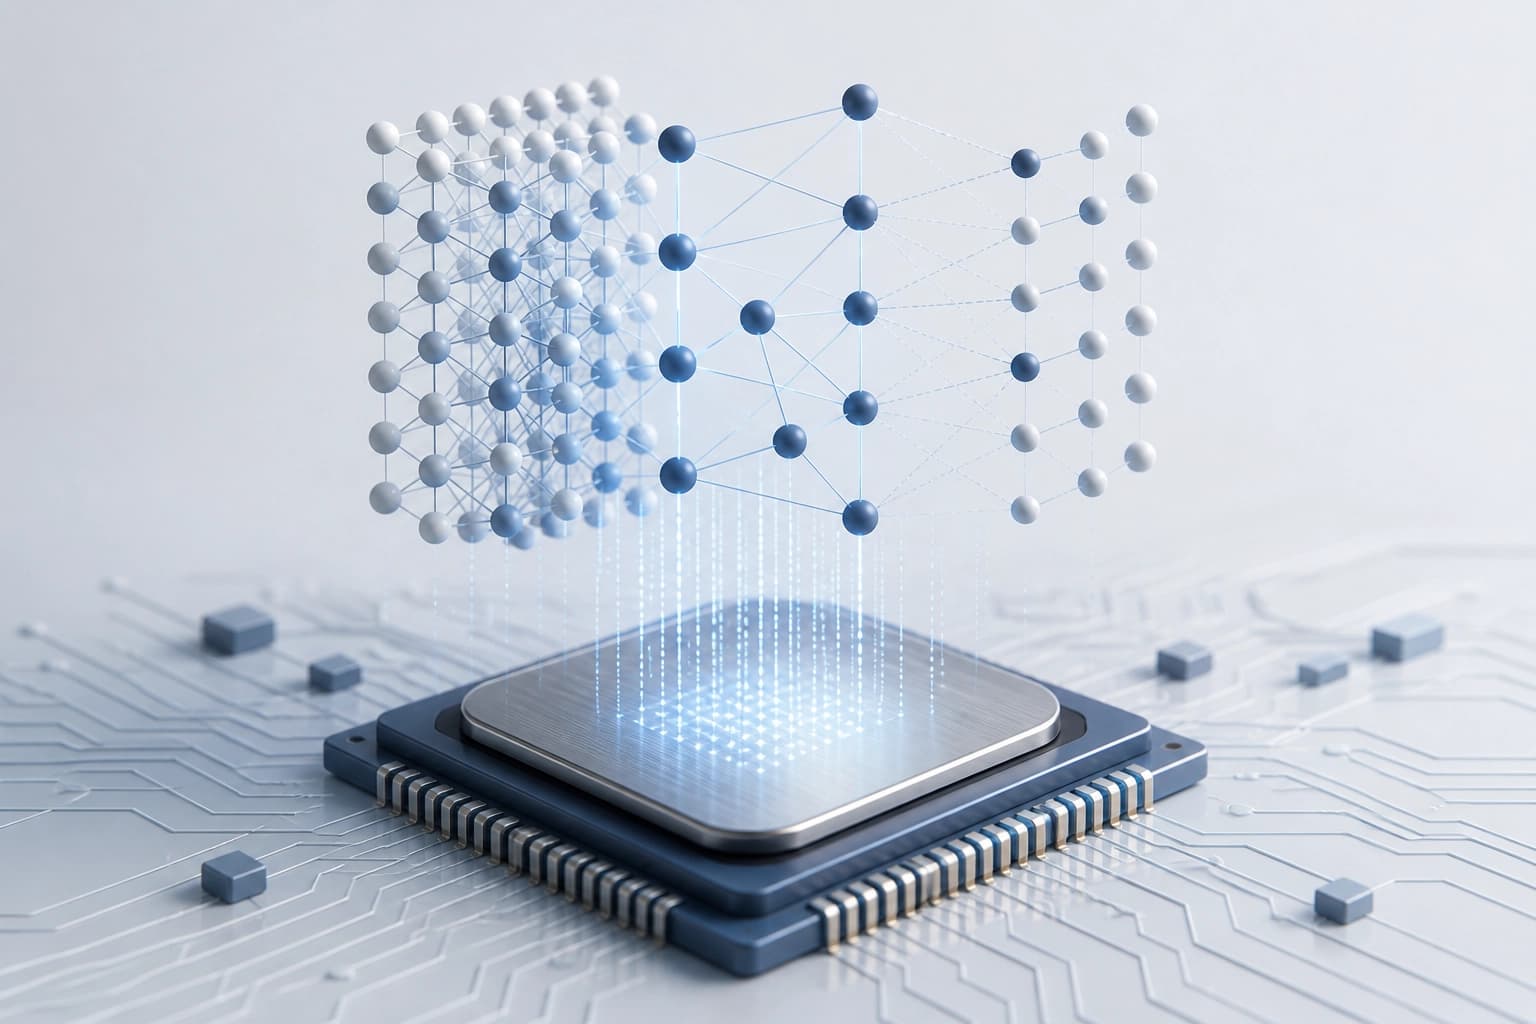
Cómo cambian los impulsos el procesamiento de los pesos
En el artículo «Spike-Aware INT8 Execution for Spiking Language Models on Commodity CPUs» Ting Liu describe la decodificación de un modelo de lenguaje basado en impulsos en una CPU.
- Las activaciones binarias de impulsos permiten leer solo las columnas activas de los pesos.
- Las multiplicaciones se sustituyen por sumas de pesos.
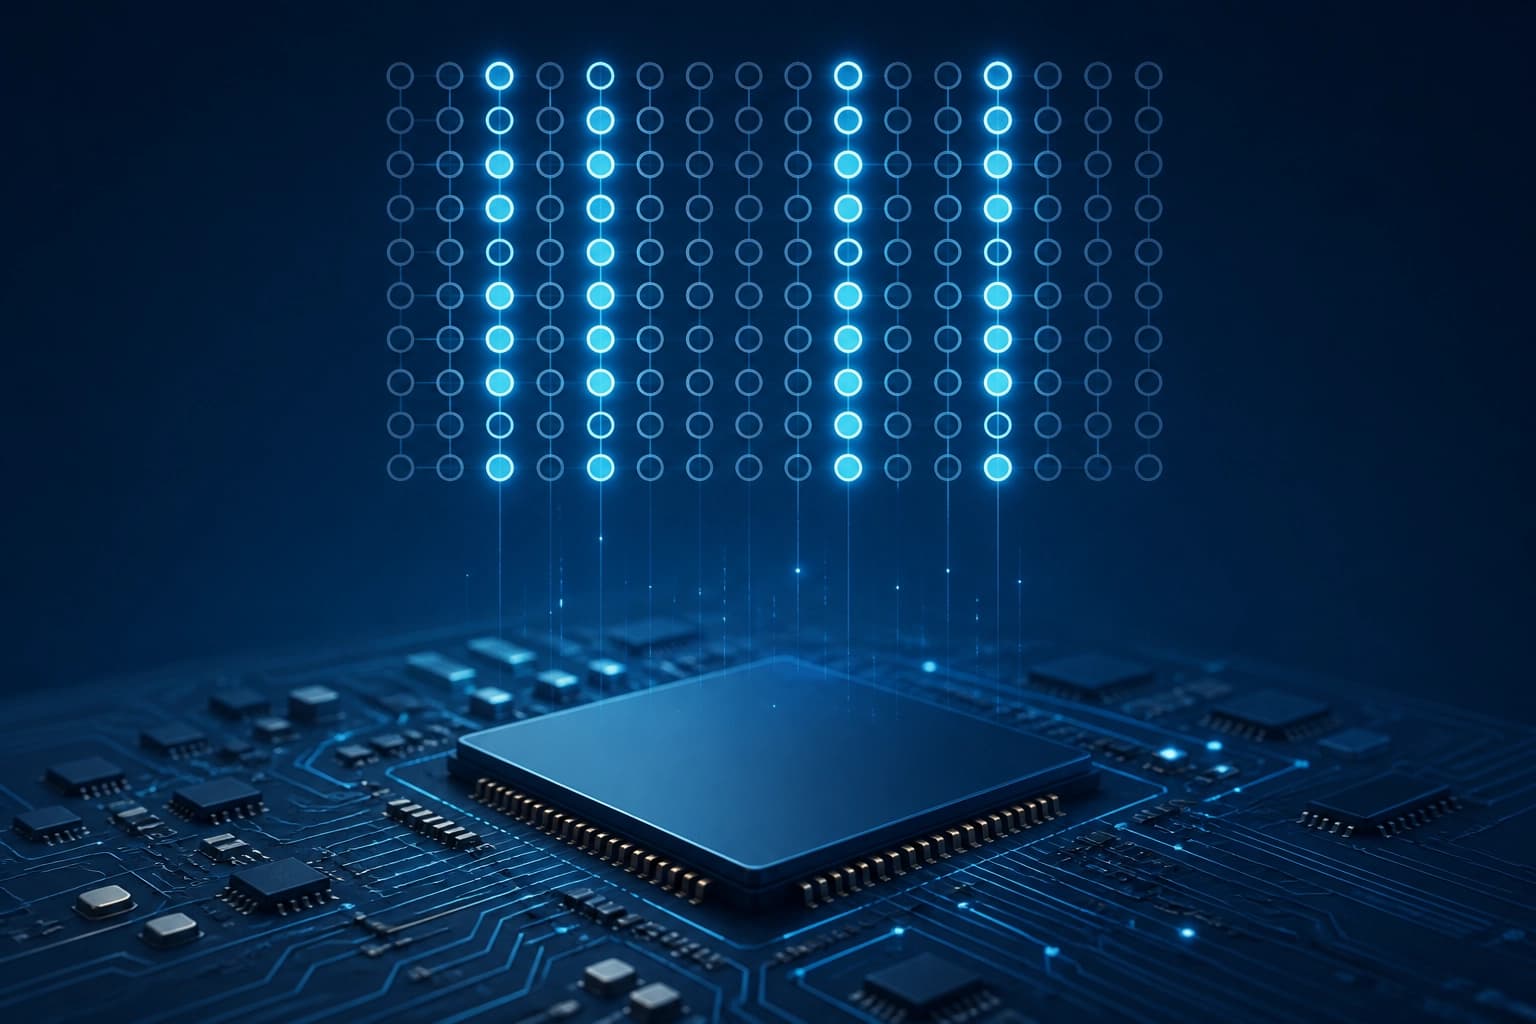
En la práctica, este enfoque permite no procesar las columnas que no se han activado. La ganancia depende de la dispersión de las activaciones, no solo del formato de los pesos.
Cómo funciona la ruta INT8
La implementación en C++ se probó con un modelo de lenguaje con compuertas de impulsos y 874M de parámetros. Utiliza distintos modos para las proyecciones dispersas y densas.
- En las proyecciones dispersas, los pesos INT8 se almacenan en formato por columnas.
- La acumulación se realiza con números enteros y la escala se aplica una sola vez por canal de salida.
- En las proyecciones densas se mantienen el acceso por filas y las activaciones FP32.
Es un esquema mixto, no una conversión de todas las operaciones del modelo a INT8. El criterio de elección es si conviene mantener FP32 en las proyecciones densas para disponer de una ruta INT8 dispersa.
Qué cifras de velocidad y almacenamiento se presentan
Se comparó un checkpoint inicial con un solo hilo. En esta prueba, INT8 mostró una mayor velocidad de decodificación y un menor espacio de almacenamiento de los pesos.
| Checkpoint inicial, un hilo | Velocidad de decodificación | Almacenamiento de los pesos |
|---|---|---|
| FP32 | 9.82 tokens/s | 3355.2 MiB |
| INT8 | 23.31 tokens/s | 1087.4 MiB |
Para el checkpoint final se indican resultados aparte en un AMD Ryzen 7 5800X. Las condiciones difieren de las de la comparación del checkpoint inicial.
| Modo del checkpoint final INT8 | Indicador |
|---|---|
| Decodificación, un hilo | 22.63 tokens/s |
| Decodificación, cuatro hilos | 47.90 tokens/s |
| Prefill de una secuencia de 512 tokens, ocho hilos | 94.68 tokens/s |
Estas cifras no se pueden combinar directamente en una única tabla comparativa: corresponden a checkpoints y modos distintos. Para evaluar el rendimiento, son importantes tanto la versión del checkpoint como el número de hilos.
Qué cambia con la variante INT4
La variante con INT4 para las proyecciones densas reduce el espacio de almacenamiento otro 17.4%. Sin embargo, la velocidad de decodificación disminuye un 46.6%.
En la versión corregida del artículo se retiraron los resultados no válidos para INT4 puro. Por tanto, el compromiso descrito corresponde a INT4 en las proyecciones densas, no a un modelo totalmente INT4.
El criterio de elección es priorizar el almacenamiento frente a la velocidad de decodificación. Los resultados de INT4 puro no se pueden utilizar como prueba de rendimiento.
Qué se sabe sobre el consumo de energía
En un estudio aparte de la cabeza de salida en ARM, se registraron cifras de energía más altas para dos configuraciones de verificación de candidatos en una ventana de decodificación truncada.
La versión corregida del artículo también añade una validación numérica y un estudio del consumo de energía mediante mediciones de wall-power en ARM. Los datos de las pruebas de velocidad en CPU no bastan para concluir que se ahorre energía.
Preguntas frecuentes
Material similar
Todos los materiales
Verificación de alucinaciones de LLM mediante una vista SQL de las fuentes, sin reentrenamiento
El estudio evalúa si un LLM puede aprovechar una habilidad simbólica básica —crear una base de datos SQL a partir de documentos fuente— para fundamentar sus respuestas en las fuentes sin supervisión al detectar alucinaciones. En RAGTruth y DiaHalu, este flujo de trabajo neuro-simbólico resulta más preciso que la predicción directa y comparable a los métodos más avanzados, sin requerir un ajuste fino al dominio.
9 noviembre 2026
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026
AffordanceWAM: las affordances como intermediarias entre la predicción de la escena y el control del manipulador
El trabajo describe un modelo generativo que predice simultáneamente futuras observaciones RGB, campos escalares, mapas de calor de affordances y comandos continuos para el robot, utilizando videos de personas para ampliar la diversidad de interacciones sin anotaciones de acciones ni retargeting. En RoboCasa, CALVIN ABC→D y tareas reales, el enfoque ofrece mejoras consistentes frente a las líneas de base que utilizan solo RGB o solo datos robóticos.
9 noviembre 2026