
Zero2Repo বেঞ্চমার্ক: খালি ডিরেক্টরি থেকে স্বয়ংক্রিয়ভাবে প্রকল্প তৈরির সীমা
গবেষণায় কোডিং এজেন্টদের সম্পূর্ণ রিপোজিটরি বিল্ডে মূল্যায়নের প্রস্তাব করা হয়েছে: ইনপুট হবে একটি স্পেসিফিকেশন, ইন্টারফেস চুক্তি এবং খালি পরিবেশ; যাচাই হবে LLM বিচারক ছাড়া গোপন পরীক্ষার মাধ্যমে। শীর্ষস্থানীয় এজেন্টরাও খুব কম ক্ষেত্রেই সব পরীক্ষায় উত্তীর্ণ হয়, আর ব্যর্থতার বেশিরভাগই প্রয়োজনীয়তার কিছু নির্দিষ্ট বিষয় বাদ পড়ার কারণে ঘটে।
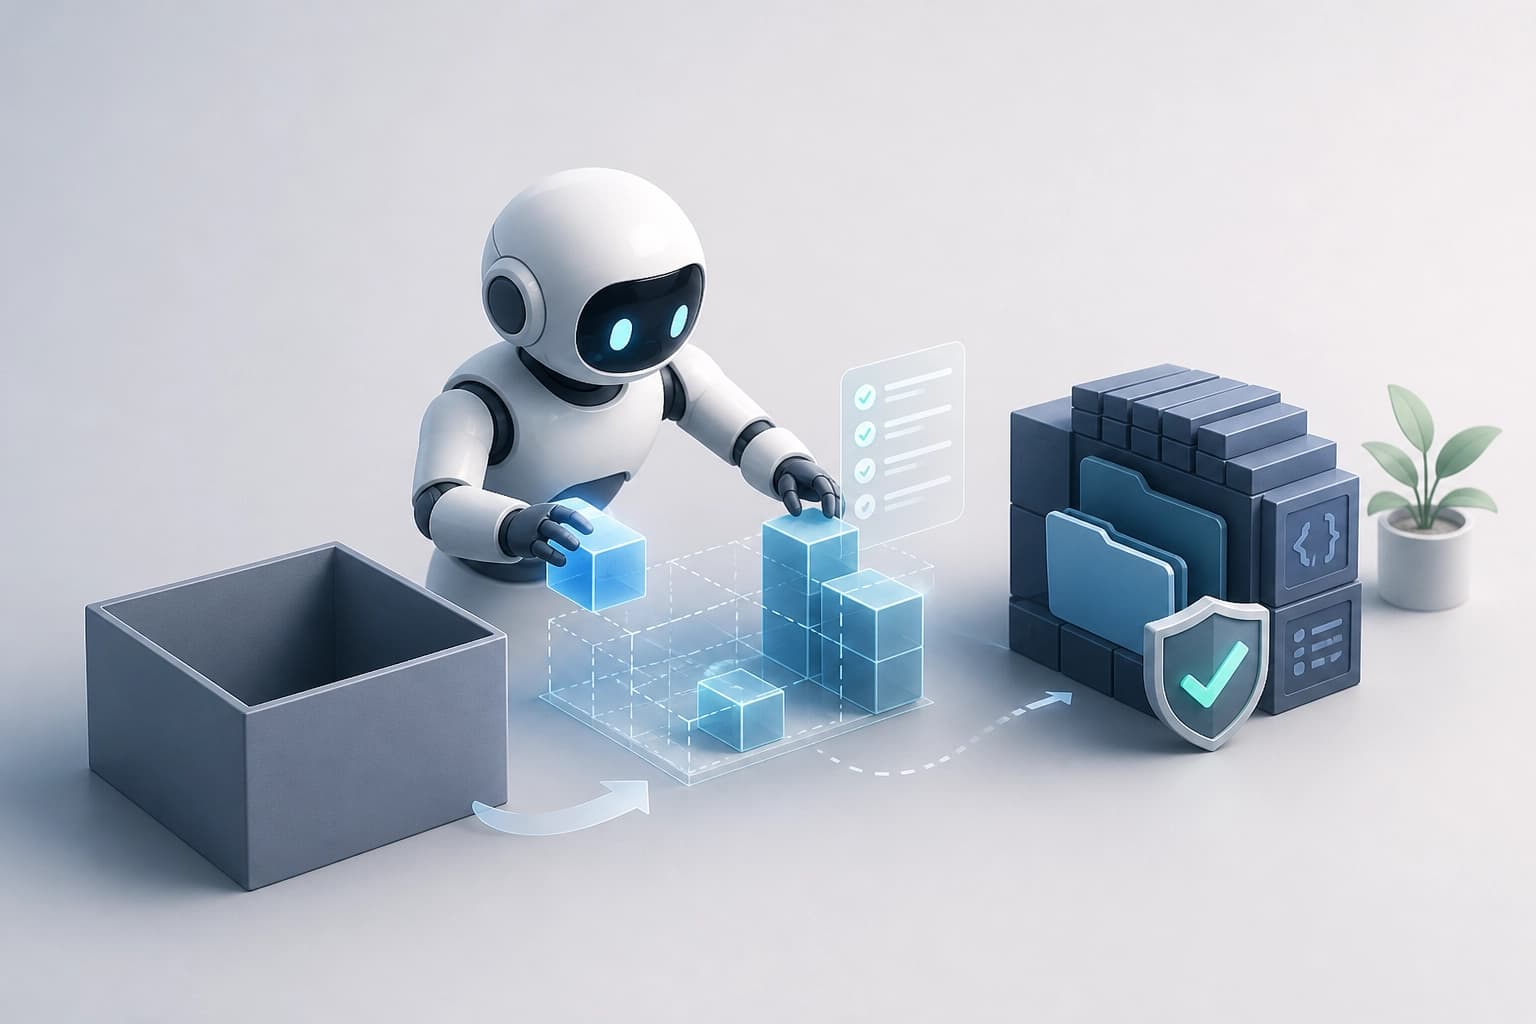
Zero2Repo কী পরীক্ষা করে
বেঞ্চমার্কটি মূল্যায়ন করে, কোনো কোডিং এজেন্ট শূন্য থেকে একটি রিপোজিটরি তৈরি করতে পারে কি না। এজেন্টকে পণ্যের প্রয়োজনীয়তার একটি নথি, একটি ইন্টারফেস কন্ট্রাক্ট এবং একটি খালি কর্মক্ষেত্র দেওয়া হয়। এজেন্টকে প্রকল্পের নিজস্ব ইকোসিস্টেমে একটি সম্পূর্ণ রিপোজিটরি সরবরাহ করতে হয়।
পরীক্ষায় পুরো প্রকল্পের বিল্ড অন্তর্ভুক্ত। মূল্যায়ন করা হয় সম্পূর্ণ রিপোজিটরির ভিত্তিতে।
- ইনপুট: পণ্যের প্রয়োজনীয়তার নথি, একটি ইন্টারফেস কন্ট্রাক্ট, একটি খালি কর্মক্ষেত্র।
- আউটপুট: প্রকল্পের নিজস্ব ইকোসিস্টেমে একটি সম্পূর্ণ রিপোজিটরি।
- মূল্যায়নের বিষয়: শূন্য থেকে একটি রিপোজিটরি তৈরি করার সক্ষমতা।
উপসংহার: বেঞ্চমার্কটি একটি খালি ডিরেক্টরি থেকে স্বয়ংক্রিয়ভাবে বিল্ড করার সক্ষমতা পরীক্ষা করে। ব্যবহারিক মানদণ্ড: পুরো প্রকল্প বিল্ড করার কাজগুলোতে এজেন্ট মূল্যায়নের জন্য এটি ব্যবহার করুন।
কীভাবে কাজগুলো তৈরি করা হয়
পাইপলাইনটি ভাষা-নিরপেক্ষভাবে কাজ তৈরি করে। এটি নির্দিষ্ট সংস্করণসহ বাস্তব ওপেন সোর্স প্রকল্প বেছে নেয়। এরপর পাইপলাইন সেগুলোকে আচরণগত স্পেসিফিকেশন, পুনরুৎপাদনযোগ্য পরিবেশ এবং গোপন গ্রহণযোগ্যতা পরীক্ষায় রূপান্তর করে।
ধাপগুলো:
- নির্দিষ্ট সংস্করণসহ বাস্তব ওপেন সোর্স প্রকল্প বেছে নেওয়া।
- সেগুলোকে আচরণগত স্পেসিফিকেশনে রূপান্তর করা।
- পুনরুৎপাদনযোগ্য পরিবেশ প্রস্তুত করা।
- গোপন গ্রহণযোগ্যতা পরীক্ষা তৈরি করা।
যাচাইকরণ:
- মূল প্রকল্পের রেফারেন্স ইমপ্লিমেন্টেশন পরীক্ষায় উত্তীর্ণ হয়।
- প্রতিদ্বন্দ্বিতামূলক যাচাই নিশ্চিত করে যে পরীক্ষাগুলো ত্রুটিপূর্ণ ইমপ্লিমেন্টেশন প্রত্যাখ্যান করে।
উপসংহার: কাজটি একটি রেফারেন্স ইমপ্লিমেন্টেশন এবং প্রতিদ্বন্দ্বিতামূলক যাচাইয়ে উত্তীর্ণ পরীক্ষার ওপর নির্ভর করে। ব্যবহারিক মানদণ্ড: শুধু কাজের বিবরণ নয়, পরীক্ষাগুলো যাচাই করা হয়েছে কি না তাও পরীক্ষা করুন।
এজেন্টের মূল্যায়ন কীভাবে হয়
বেঞ্চমার্কটি বিচ্ছিন্ন কনটেইনারে প্রোডাকশন কোডিং এজেন্টদের মূল্যায়ন করে। সমাধান জমা না দেওয়া পর্যন্ত গ্রহণযোগ্যতা পরীক্ষাগুলো গোপন থাকে। পুরস্কার দ্বিমাত্রিক: সব পরীক্ষায় উত্তীর্ণ হলেই পুরস্কার দেওয়া হয়। বেঞ্চমার্কে LLM বিচারক ব্যবহার করা হয় না।
মানদণ্ড:
- এজেন্টের জন্য বিচ্ছিন্ন কনটেইনার।
- সমাধান জমা দেওয়ার আগে গোপন পরীক্ষা।
- সব পরীক্ষার জন্য দ্বিমাত্রিক পুরস্কার।
- LLM বিচারকের অনুপস্থিতি।
উপসংহার: আংশিকভাবে উত্তীর্ণ পরীক্ষার জন্য কোনো পুরস্কার নেই। ব্যবহারিক মানদণ্ড: এমন মূল্যায়ন এজেন্ট তুলনা করার জন্য উপযুক্ত, যেখানে সাফল্যের জন্য গোপন সব পরীক্ষায় উত্তীর্ণ হতে হয়।
বর্তমান সংস্করণের ভাষা ও পরিধি
পাইপলাইন ও পরীক্ষা ব্যবস্থা কোনো নির্দিষ্ট প্রোগ্রামিং ভাষার ওপর নির্ভরশীল নয়। বর্তমান সংস্করণে Python, TypeScript, Go এবং C++-এর কাজ রয়েছে।
সংস্করণে রয়েছে:
- Python।
- TypeScript।
- Go।
- C++।
উপসংহার: বেঞ্চমার্কটি একটি ভাষায় সীমাবদ্ধ নয়, তবে বর্তমান কাজের সেট চারটি ভাষায় সীমিত। ব্যবহারিক মানদণ্ড: প্রকল্পের ভাষাকে সংস্করণে থাকা ভাষাগুলোর সঙ্গে মিলিয়ে দেখুন।
ফলাফলে যে সীমাবদ্ধতাগুলো দেখা যায়
১১টি কাজের সেটে সীমাবদ্ধতাগুলো স্পষ্ট। এই কাজগুলো এমন রিপোজিটরি থেকে নেওয়া, যেগুলোর মুখোমুখি হওয়ার সম্ভাবনা প্রশিক্ষণের সময় অত্যাধুনিক মডেলগুলোর হয়েছে।
ফলাফল যা দেখায়:
- সবচেয়ে শক্তিশালী এজেন্ট ১১টির মধ্যে ১০টি কাজ সমাধান করে।
- প্রতিটি ব্যর্থ জমাদানে গোপন পরীক্ষার ৯০-৯৯% উত্তীর্ণ হয়।
- দুই শক্তিশালী এজেন্টের ক্ষেত্রে, ব্যর্থ পরীক্ষার ৬৭-১০০% একটি বাদ পড়া বিষয় বা স্পেসিফিকেশনের বিরল নিয়মের সঙ্গে সম্পর্কিত।
- ব্যর্থতা কোনো সাবসিস্টেমের অনুপস্থিতির কারণে নয়, বরং স্পেসিফিকেশন যথাযথভাবে অনুসরণ না করার কারণে ঘটে।
- লেখকেরা প্রতিটি এ ধরনের ব্যর্থতাকে উন্নতির নির্দিষ্ট লক্ষ্য হিসেবে চিহ্নিত করেন।
উপসংহার: স্বয়ংক্রিয়ভাবে বিল্ড করার সীমাবদ্ধতা প্রকাশ পায় বিরল নিয়ম ও স্পেসিফিকেশনের পূর্ণতা মনে রাখার ক্ষেত্রে। ব্যবহারিক মানদণ্ড: এজেন্ট শুধু সাবসিস্টেম তৈরি করছে কি না নয়, স্পেসিফিকেশনের বিরল নিয়মগুলো মনে রাখছে কি না তাও পরীক্ষা করুন।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
FedSocket: মাল্টিমোডাল বৈচিত্র্যের ক্ষেত্রে প্রাপকের কাছে বাধ্যতামূলকভাবে কার্যকরযোগ্য বিনিময়যোগ্য মডেল
FedSocket প্রস্তাব করা হয়েছে—এমন একটি পদ্ধতি, যেখানে বিনিময় করা মডেলটি প্রাপকের পক্ষেও গণনাযোগ্য হতে হবে এবং বিভিন্ন ধরনের ব্যক্তিগত মডেলকে পূর্বাভাসের একটি অভিন্ন ইন্টারফেস Q সংযুক্ত করে। নিবন্ধে সদস্যপদ-সচেতন অ্যাগ্রিগেশন, কাউন্টারসহ শুধু Q-এর প্যারামিটার ফরওয়ার্ড করা এবং ছয়টি ডেটাসেটে পরীক্ষা-নিরীক্ষার বর্ণনা রয়েছে; এসব পরীক্ষায় অনুপস্থিত মডালিটির ক্ষেত্রে নির্ভুলতা বৃদ্ধি এবং স্বাধীন এনসেম্বলের তুলনায় Joint ইনফারেন্সের শ্রেষ্ঠত্ব দেখানো হয়েছে।
13 নভেম্বর 2026
CyberArena: AI এজেন্টদের মুখোমুখি ম্যাচ স্থির সাইবার বেঞ্চমার্কের সীমাবদ্ধতা উন্মোচন করে
বেঞ্চমার্কটি দুই এজেন্টকে ক্রমাগত পরিবর্তনশীল পরিষেবাসহ স্যান্ডবক্সে রাখে এবং কয়েক দফা শেষে তাদের কার্যকলাপকে আক্রমণাত্মক ও প্রতিরক্ষামূলক দক্ষতার বহুমাত্রিক স্কোরে রূপ দেয়। ১২টি আধুনিক মডেলের সঙ্গে ৪৬৬টি ম্যাচে এটি এমন সক্ষমতার পার্থক্য শনাক্ত করেছে, যেখানে একমুখী পরীক্ষাগুলো সর্বোচ্চ সীমায় পৌঁছে যায়—এর মধ্যে রয়েছে কয়েক ধাপ এগিয়ে পরিকল্পনা করা এবং ব্যাকডোর তৈরি করা।
13 নভেম্বর 2026
পুনর্লিখিত মেশিন-সৃষ্ট পাঠ্যের বিরুদ্ধে ডিটেক্টরগুলোর দৃঢ়তা: পরীক্ষায় কী উঠে এসেছে
এই লেখায় এমন টুলগুলোর পরীক্ষার ফলাফল সংকলিত হয়েছে, যেগুলো জেনারেট করা অংশগুলোকে আরও স্বাভাবিক শৈলীতে পুনর্লিখন করে। এভাবে প্রক্রিয়াকরণের পর শনাক্তযোগ্যতা উল্লেখযোগ্যভাবে কমে যায়, আর যেসব ভুল শনাক্তকরণ থেকে যায়, সেগুলোর কারণে ডিটেক্টরের রায়কে প্রমাণ হিসেবে বিবেচনা করা যায় না।
13 নভেম্বর 2026