
পুনর্লিখিত মেশিন-সৃষ্ট পাঠ্যের বিরুদ্ধে ডিটেক্টরগুলোর দৃঢ়তা: পরীক্ষায় কী উঠে এসেছে
এই লেখায় এমন টুলগুলোর পরীক্ষার ফলাফল সংকলিত হয়েছে, যেগুলো জেনারেট করা অংশগুলোকে আরও স্বাভাবিক শৈলীতে পুনর্লিখন করে। এভাবে প্রক্রিয়াকরণের পর শনাক্তযোগ্যতা উল্লেখযোগ্যভাবে কমে যায়, আর যেসব ভুল শনাক্তকরণ থেকে যায়, সেগুলোর কারণে ডিটেক্টরের রায়কে প্রমাণ হিসেবে বিবেচনা করা যায় না।
পুনর্লিখন কীভাবে লেখা ও শনাক্তকরণ সংকেত বদলে দেয়
মানবিকীকৃত AI-কনটেন্ট হলো যন্ত্রে তৈরি লেখা, যা আরও স্বাভাবিক শোনানোর জন্য পুনর্লিখন করা হয়েছে। টুলগুলো শব্দচয়ন, বাক্যের দৈর্ঘ্য ও সুর বদলে দেয়। কিছু টুল লেখায় ছন্দের অনিয়ম যোগ করে বা বারবার পুনর্লিখন করে। এসব পরিবর্তনে শনাক্তকারী যে সংকেতের ওপর নির্ভর করে, সেগুলো বদলে যায়: শব্দের পূর্বানুমানযোগ্যতা এবং বাক্যের দৈর্ঘ্যের বৈচিত্র্য।
- শব্দচয়ন;
- বাক্যের দৈর্ঘ্য;
- সুর;
- ছন্দের অনিয়ম;
- বারবার পুনর্লিখন।
উপসংহার: পুনর্লিখনে শনাক্তকারীরা যে বৈশিষ্ট্যের ভিত্তিতে যন্ত্রে তৈরি লেখা শনাক্ত করে, সেগুলোই বদলে যায়।
পুনর্লিখিত লেখা নিয়ে পরীক্ষায় যা দেখা গেছে
পুনর্লিখনের পর শনাক্তকারীরা নির্ভরযোগ্য থাকে কি না, তা পরীক্ষায় যাচাই করা হয়েছে। 2025 সালের একটি গবেষণায় মানবিকীকরণ ও পুনর্লিখনের 19টি টুল পরীক্ষা করা হয়।
| পরীক্ষা | ফলাফল |
|---|---|
| 2025 সালের গবেষণা, 19টি টুল | অনেক শনাক্তকারী মানবিকীকৃত লেখা শনাক্ত করতে পারে না। |
| Google Research | পুনর্লিখনের মডেলটি অর্থ বজায় রাখে এবং শনাক্তকরণ অনেকাংশে এড়িয়ে যায়। |
| QuillBot ব্যবহার করে ChatGPT-এর লেখা পুনর্লিখন | ChatGPT-এর লেখায় শনাক্তকারীর নির্ভুলতা কমে 49%-এ নেমে আসে। |
| আরেকটি পরীক্ষা | ChatGPT-এর লেখা পুনর্লিখন অন্তত অর্ধেক ক্ষেত্রে প্রতিটি শনাক্তকারীকে ফাঁকি দিয়েছে। |
| Stanford, সাহিত্যিক ভাষা | ChatGPT-কে আরও সাহিত্যিক ভাষা ব্যবহার করতে বললে AI লেখা শনাক্ত করার হার 100% থেকে কমে 13%-এ নেমে আসে। |
উপসংহার: পুনর্লিখিত যন্ত্রে তৈরি লেখা শনাক্ত করার ক্ষেত্রে শনাক্তকারীদের নির্ভরযোগ্যতা কম।
শনাক্তকারীরা লেখায় কী শনাক্ত করে
শনাক্তকারীরা এমন বৈশিষ্ট্যের ওপর নির্ভর করে, যেগুলোর সঙ্গে লেখাটি যন্ত্রে তৈরি কি না, তার সম্পর্ক সব সময় থাকে না। Carnegie Mellon-এর গবেষকেরা দেখেছেন: মৌলিক মডেলের লেখা GPTZero এবং Pangram-এর কাছে প্রায়ই মানুষের লেখা বলে মনে হয়েছে। নির্দেশনা অনুসরণে অতিরিক্ত প্রশিক্ষণ দেওয়া মডেলগুলোর লেখা তেমন মনে হয়নি। গবেষক দলের ধারণা, শনাক্তকারীরা যন্ত্রে লেখা হওয়ার নির্ভরযোগ্য লক্ষণের চেয়ে মডেলের প্রশিক্ষণের চিহ্ন বেশি শনাক্ত করে।
- মৌলিক মডেল: GPTZero এবং Pangram-এর কাছে লেখা প্রায়ই মানুষের লেখা বলে মনে হয়;
- নির্দেশনা অনুসরণে অতিরিক্ত প্রশিক্ষণ দেওয়া মডেল: লেখা তেমন মনে হয় না;
- গবেষক দলের উপসংহার: শনাক্তকারীরা প্রশিক্ষণের চিহ্ন শনাক্ত করে।
Stanford ইংরেজি যাঁদের মাতৃভাষা নয়, এমন লেখকদের 91টি প্রবন্ধে সাতটি শনাক্তকারী পরীক্ষা করেছে। মিথ্যা শনাক্তকরণের গড় হার ছিল 61,3%। অন্তত একটি টুল 91%-এর বেশি প্রবন্ধ চিহ্নিত করেছে। ইংরেজি যাঁদের মাতৃভাষা, তাঁদের প্রবন্ধে এই হার প্রায় শূন্য ছিল। গবেষকেরা এই পার্থক্যের কারণ হিসেবে সরল ও পূর্বানুমানযোগ্য শব্দচয়নকে দেখেছেন, যেটিকে শনাক্তকারীরা যন্ত্রে তৈরি লেখা বলে মনে করে।
উপসংহার: শনাক্তকারীর সংকেত মানেই লেখা যন্ত্রে তৈরি—এমন নয়, তাই মূল্যায়নের জন্য প্রেক্ষাপট বিবেচনা করা জরুরি।
দাবিকৃত নির্ভুলতা ও বাস্তব সীমাবদ্ধতা
স্বাধীন ও নির্মাতাদের নিজস্ব পরীক্ষায় নির্ভুলতার ভিন্ন ভিন্ন হিসাব পাওয়া যায়। পরীক্ষার শর্ত ফলাফল বদলে দেয়।
- স্বাধীন পরীক্ষার পর্যালোচনা: Turnitin, GPTZero এবং Originality.ai-এর নির্ভুলতা 70%–85%। এসব টুলে মিথ্যা শনাক্তকরণের সমস্যা রয়ে গেছে।
- Turnitin 98% নির্ভুলতা এবং 1%-এর কম মিথ্যা শনাক্তকরণের হার দাবি করে। এই দাবি কেবল সেসব নথির ক্ষেত্রে প্রযোজ্য, যেখানে 20%-এর বেশি লেখা AI তৈরি করেছে।
- OpenAI 2023 সালের জুলাইয়ে তাদের নিজস্ব শ্রেণিবিন্যাসকারীটি বন্ধ করে দেয়। শ্রেণিবিন্যাসকারীটি AI-তৈরি লেখার মাত্র 26% শনাক্ত করতে পারত।
- 2025 সালের গবেষণার লেখকেরা মানবিকীকৃত নমুনা দিয়ে একটি মডেলকে প্রশিক্ষণ দিয়েছিলেন। মডেলটি কম মিথ্যা শনাক্তকরণের হার বজায় রেখে মানবিকীকৃত লেখা শনাক্ত করেছিল। এটিকে ফাঁকি দেওয়ার চেষ্টা হলেও মডেলটি কার্যকর ছিল। মডেলটির নির্মাতারাই ফলাফল পেয়েছেন; স্বাধীন পরীক্ষার প্রয়োজন।
উপসংহার: দাবিকৃত নির্ভুলতা পরীক্ষার শর্তের ওপর নির্ভর করে, আর স্বাধীন পরীক্ষায় শনাক্তকরণের সীমাবদ্ধতা দেখা যায়।
শনাক্তকারীর ব্যবহারিক মূল্যায়ন
বিশেষজ্ঞরা শনাক্তকারীর মূল্যায়নকে প্রমাণ নয়, বরং একটি ইঙ্গিত হিসেবে বিবেচনা করার পরামর্শ দেন। যাচাইয়ের জন্য খসড়ার ইতিহাস বিবেচনা করা, সংক্ষিপ্ত মৌখিক প্রশ্ন করা এবং ক্লাসে করা কাজের সঙ্গে তুলনা করা যেতে পারে। লেখক ও প্রকাশকদের জন্য বিশেষজ্ঞদের পরামর্শ হলো, সূত্র, সাক্ষাৎকার ও মৌলিক তথ্য চেয়ে নেওয়া।
- খসড়ার ইতিহাস;
- সংক্ষিপ্ত মৌখিক প্রশ্ন;
- ক্লাসে করা কাজের সঙ্গে তুলনা;
- লেখক ও প্রকাশকদের জন্য সূত্র, সাক্ষাৎকার ও মৌলিক তথ্য।
ব্যবহারিক মানদণ্ড: শনাক্তকারীকে অতিরিক্ত যাচাইয়ের সংকেত হিসেবে ব্যবহার করুন, সিদ্ধান্তের একমাত্র ভিত্তি হিসেবে নয়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
CyberArena: AI এজেন্টদের মুখোমুখি ম্যাচ স্থির সাইবার বেঞ্চমার্কের সীমাবদ্ধতা উন্মোচন করে
বেঞ্চমার্কটি দুই এজেন্টকে ক্রমাগত পরিবর্তনশীল পরিষেবাসহ স্যান্ডবক্সে রাখে এবং কয়েক দফা শেষে তাদের কার্যকলাপকে আক্রমণাত্মক ও প্রতিরক্ষামূলক দক্ষতার বহুমাত্রিক স্কোরে রূপ দেয়। ১২টি আধুনিক মডেলের সঙ্গে ৪৬৬টি ম্যাচে এটি এমন সক্ষমতার পার্থক্য শনাক্ত করেছে, যেখানে একমুখী পরীক্ষাগুলো সর্বোচ্চ সীমায় পৌঁছে যায়—এর মধ্যে রয়েছে কয়েক ধাপ এগিয়ে পরিকল্পনা করা এবং ব্যাকডোর তৈরি করা।
13 নভেম্বর 2026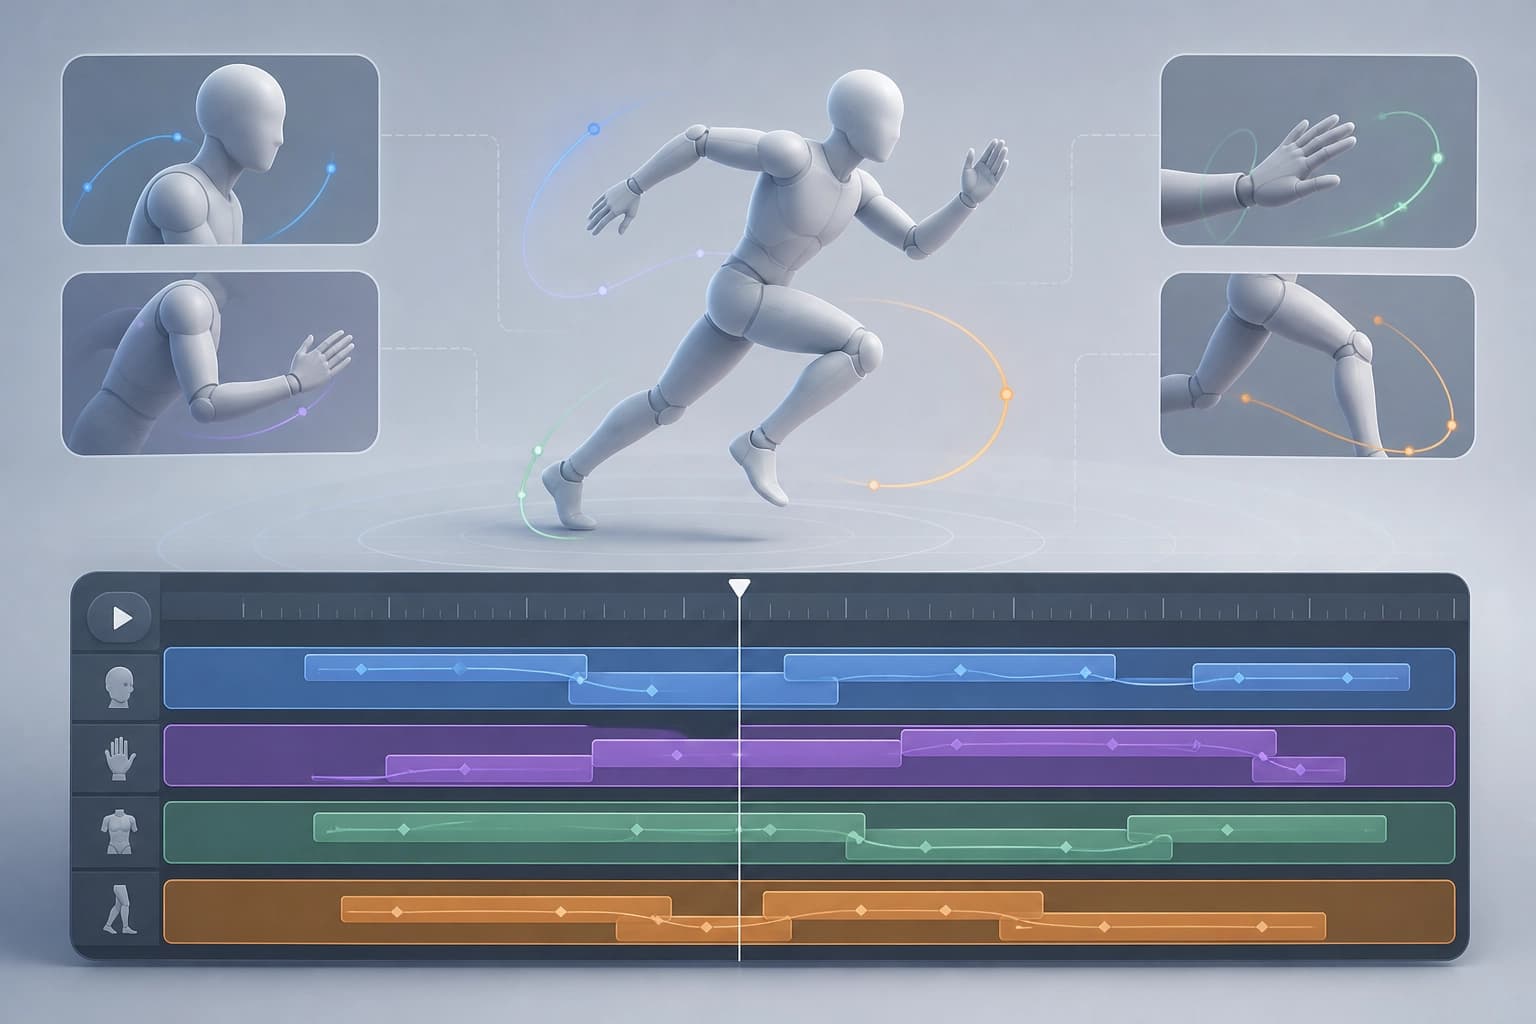
সিন্থেসিস চলাকালীন নতুন কমান্ড: 3D মানব গতির জন্য মাল্টি-ট্র্যাক টাইমলাইন
একটি পদ্ধতি প্রস্তাব করা হয়েছে, যা সংশ্লেষণের সময়ও নতুন টেক্সট নির্দেশনা গ্রহণ করে এবং পরস্পর-অতিব্যাপী ক্রিয়ার সময়সীমা স্বাধীনভাবে নির্ধারণ করতে দেয়। শরীরের বিভিন্ন অংশের একযোগে নড়াচড়ার সমন্বয় নিশ্চিত করা হয় সময়সীমাভিত্তিক কন্ডিশনিং এবং শরীরের অংশ বিবেচনায় নেওয়া ডিনয়েজিং প্রক্রিয়ার মাধ্যমে; TimelineMotion ও MTT-তে লেখকেরা জানান, স্ট্রিমিংভিত্তিক বেসলাইন পদ্ধতির তুলনায় এটি অর্থগত এবং সময়গত সীমাবদ্ধতার সঙ্গে আরও ভালোভাবে মেলে।
12 নভেম্বর 2026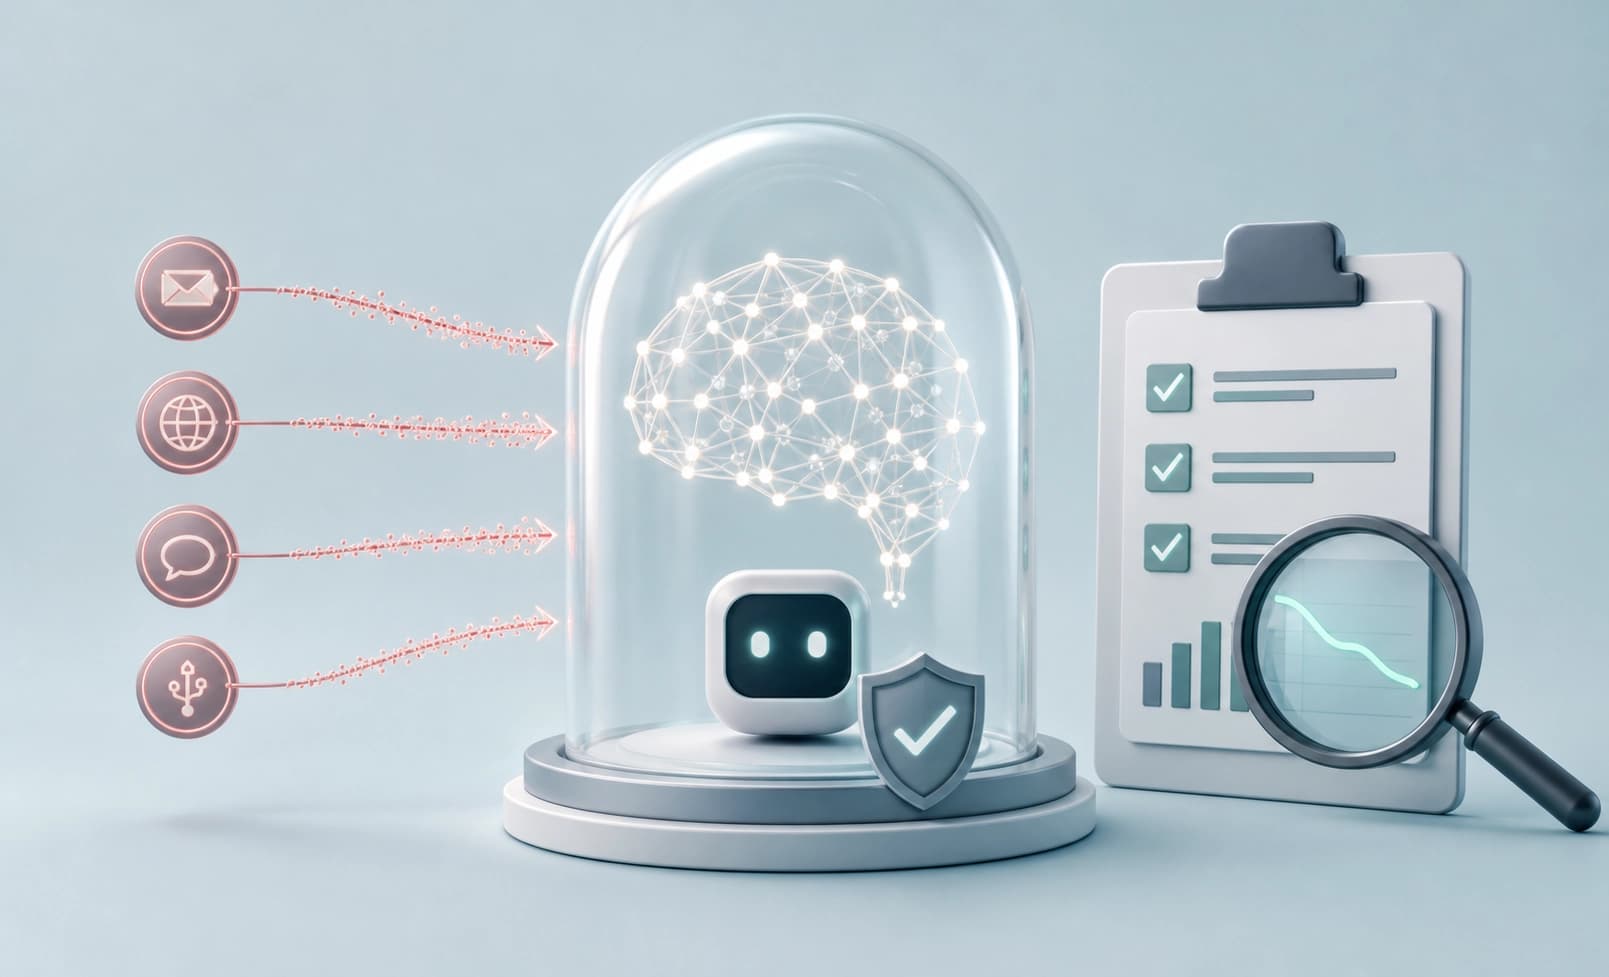
COPEX মডেলের দুর্বলতাকে MCP অবকাঠামোর দুর্বল দিকগুলো থেকে আলাদা করতে সাহায্য করে
নিয়ন্ত্রিত বেঞ্চমার্কে এজেন্টের কাঠামো স্থির রেখে চারটি MCP চ্যানেলের মাধ্যমে ১২৫টি আক্রমণ পরিস্থিতিতে ভাষা মডেলের শুধু টুল নির্বাচনের মূল্যায়ন করা হয়েছে। নয়টি মডেলে ৩,৩৭৫টি পরীক্ষায় সফল আক্রমণের গড় হার ছিল ৬৪.৪%, আর ইনপুট ও প্রসঙ্গ একসঙ্গে যাচাই করায় তা প্রায় অর্ধেকে নেমে এসেছে।
12 নভেম্বর 2026