
মানুষ বোধগম্য, LLM নয়: বিশেষজ্ঞরা মডেলগুলির যুক্তি ব্যাখ্যা করতে পারেননি
গবেষকরা মানুষের উত্তর এবং ছয়টি ভাষা মডেলের উত্তরগুলির পেছনে থাকা লুকানো কারণগুলির তুলনা করেছেন, যা পরিমাণগত যুক্তি এবং রসায়নের কাজগুলিতে দেওয়া হয়েছিল। মানুষের উত্তর থেকে নিষ্কাশিত কারণগুলি বিশেষজ্ঞরা সফলভাবে ব্যাখ্যা করেছিলেন, কিন্তু বেশিরভাগ মডেল-নির্মিত ধারণা তাদের কাছে অস্বচ্ছ বলে প্রমাণিত হয়েছিল।
মানুষ বোধগম্য, LLM নয়: বিশেষজ্ঞরা মডেলগুলির যুক্তি ব্যাখ্যা করতে পারেননি
যখন আমরা পরীক্ষার ফলাফল দেখি, তখন স্বাভাবিকভাবেই ধরে নেওয়া মনে হয় যে কৃত্রিম বুদ্ধিমত্তা "মানুষের মতো" কাজগুলো সমাধান করে: একই ধারণা, নিয়ম এবং যুক্তি ব্যবহার করে। তবে একটি নতুন গবেষণা এই ধারণাকে প্রশ্নবিদ্ধ করেছে। বিজ্ঞানীরা খুঁজে পেয়েছেন যে LLM-এর উত্তর নির্ধারণকারী লুকানো কাঠামোগুলো বেশিরভাগ ক্ষেত্রে মানুষের ব্যাখ্যার অযোগ্য — এমনকি বিষয়ভিত্তিক বিশেষজ্ঞদের কাছেও।
ঠিক কী পরীক্ষা করা হয়েছিল
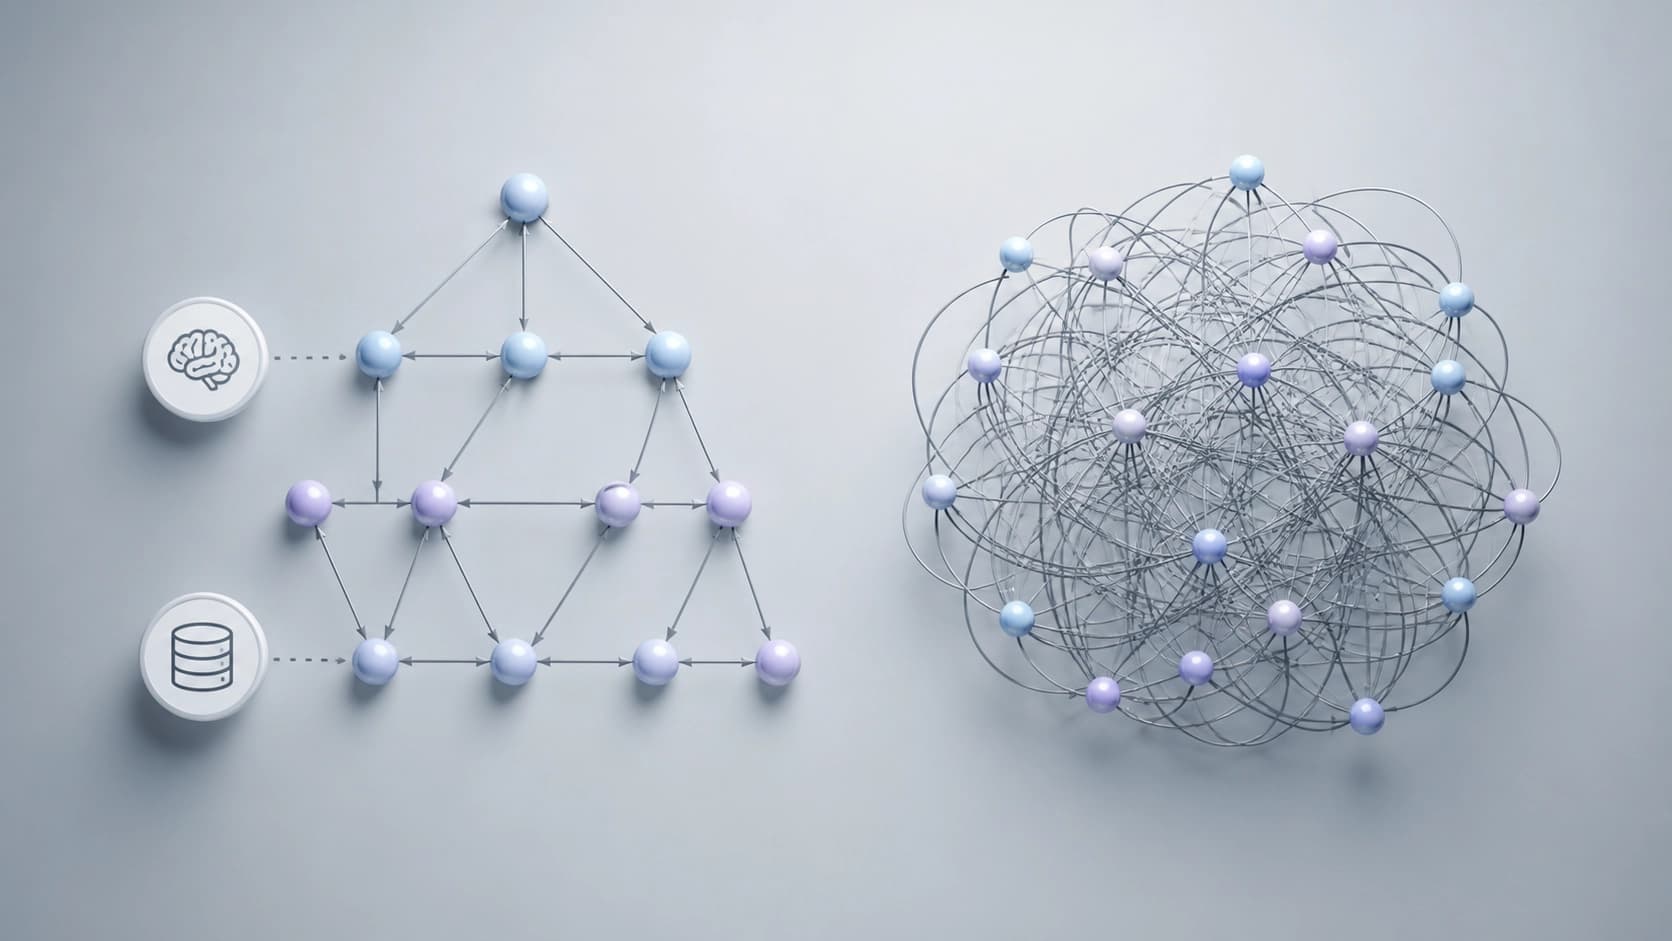
গবেষণাপত্রের লেখকরা (arXiv:2608.17810) — অ্যালোনা স্ট্রুগাটস্কি, লিকোল জেইনফেল্ড, জেসন কুপার এবং তাদের সহকর্মীরা — পরিমাণগত যুক্তি এবং রসায়ন সংক্রান্ত কাজগুলিতে মানুষ এবং ছয়টি ভিন্ন LLM-এর উত্তর নিয়েছিলেন। অনুসন্ধানমূলক ফ্যাক্টর বিশ্লেষণের মাধ্যমে তারা প্রতিটি গ্রুপের জন্য লুকানো ল্যাটেন্ট ফ্যাক্টর চিহ্নিত করেছিলেন, যা অনুমান করা হয় এই কাজগুলো সফলভাবে সম্পন্ন করার পেছনে রয়েছে।
এরপর বিষয়ভিত্তিক বিশেষজ্ঞরা অন্ধভাবে প্রাপ্ত কাঠামোগুলো অধ্যয়ন করেন এবং ফ্যাক্টরগুলোর সাথে শিক্ষাগত অর্থ যুক্ত করার চেষ্টা করেন: যেমন, "সূত্র নিয়ে কাজ করার দক্ষতা" বা "স্টোইকিওমেট্রি বোঝা"। অন্ধ ফরম্যাটটি কোনো ইঙ্গিত বাদ দিয়েছিল — বিশেষজ্ঞরা জানতেন না যে গ্রাফগুলো মানুষ বা মডেলের কিনা।
ফলাফল: ব্যাখ্যাযোগ্যতার ব্যবধান
বিশেষজ্ঞরা মানুষের উত্তর থেকে প্রাপ্ত ফ্যাক্টরগুলো প্রায় কোনো সমস্যা ছাড়াই বুঝতে পেরেছিলেন। বেশিরভাগ কাঠামো একটি অর্থপূর্ণ ব্যাখ্যা পেয়েছিল, যা সহজেই শিক্ষা বা রোগ নির্ণয়ের জন্য সুপারিশে রূপান্তরিত করা যায়।
LLM-এর ক্ষেত্রে চিত্রটি ভিন্ন ছিল:
- পরিমাণগত যুক্তিতে, বিশেষজ্ঞরা মডেলগুলির জন্য চিহ্নিত কোনো একটি ফ্যাক্টরও অর্থপূর্ণভাবে ব্যাখ্যা করতে সক্ষম হননি।
- রসায়নে পরিস্থিতি কিছুটা ভালো ছিল, তবে আদর্শ থেকে এখনও অনেক দূরে: কাঠামোর মাত্র অর্ধেকের মতো ব্যাখ্যা করা সম্ভব হয়েছিল।
এর অর্থ কী
লেখকরা একটি গুরুত্বপূর্ণ সিদ্ধান্তে পৌঁছেছেন: যখন LLM পরীক্ষায় উচ্চ ফলাফল দেখায়, এর অর্থ এই নয় যে তারা আমাদের পরিচিত উপায়ে যুক্তি করে। মডেলগুলো পরিসংখ্যানগতভাবে কার্যকর, কিন্তু মানুষের জন্য সম্পূর্ণ "অপরিচিত" উপায়ে সমস্যা সমাধান করতে পারে। তাদের অভ্যন্তরীণ প্রক্রিয়াগুলো এমন প্যাটার্নের স্তরে কাজ করে যা কোনো বোধগম্য শিক্ষাগত বা জ্ঞানীয় অর্থ বহন করে না।
এই পর্যবেক্ষণটি প্রচলিত অনুশীলনকে চ্যালেঞ্জ করে, যেখানে AI-এর ফলাফলের ভিত্তিতে জ্ঞান বা দক্ষতার স্তর সম্পর্কে সিদ্ধান্ত নেওয়ার চেষ্টা করা হয়। যদি আমরা ব্যাখ্যা করতে না পারি যে উত্তরের পেছনে ঠিক কোন কাঠামো রয়েছে, তাহলে আমরা মডেলগুলিকে অস্তিত্বহীন ক্ষমতা আরোপ করার ঝুঁকি নিই — বা বিপরীতভাবে, প্রকৃত সীমাবদ্ধতাগুলো উপেক্ষা করার ঝুঁকি নিই।
সামনে এগোনোর পথ
গবেষণাটি দাবি করে না যে LLM ব্যাখ্যা করা নীতিগতভাবে অসম্ভব। এটি কেবল দেখায় যে মানুষের জ্ঞান অধ্যয়নের জন্য তৈরি শাস্ত্রীয় পদ্ধতিটি সরাসরি মডেলগুলিতে প্রযোজ্য নয়। সম্ভবত, মৌলিকভাবে নতুন বিশ্লেষণ পদ্ধতি তৈরি করার প্রয়োজন হবে — এমন পদ্ধতি যা ল্যাটেন্ট কাঠামোর "অ-মানবিক" প্রকৃতিকে বিবেচনা করে।
এখন পর্যন্ত প্রশ্নটি উন্মুক্ত রয়েছে: যদি বিশেষজ্ঞরা মডেলগুলির যুক্তি ব্যাখ্যা করতে না পারেন, তাহলে আমরা কি শিক্ষা এবং জ্ঞান মূল্যায়নে তাদের ব্যবহারের উপর নির্ভর করতে পারি? উত্তরটি সম্ভবত AI পরীক্ষার পদ্ধতিগুলির পুনর্বিবেচনা এবং মেশিনের "বুদ্ধিমত্তা" সম্পর্কে আমাদের প্রত্যাশার পুনর্বিবেচনা উভয়েরই প্রয়োজন করবে।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
প্রার্থী যাচাই করতে সেগুলো তৈরি করার চেয়ে বেশি খরচ হয়: LLM-এর দুর্বলতা অনুসন্ধানের বিরুদ্ধে ডিকয়গুলি
এই কাজে এজেন্টভিত্তিক ত্রুটি অনুসন্ধানের ব্যয়ের অসমতা বিশ্লেষণ করা হয়েছে: সংস্করণ তৈরি করা সস্তা, কিন্তু পৌঁছনযোগ্যতা বিশ্লেষণ, কার্যকরকরণ এবং PoC-এর মাধ্যমে সেগুলো নিশ্চিত করতে মূল বাজেটের প্রয়োজন হয়। তাই যাচাইকরণকে প্রতিরক্ষার স্বতন্ত্র লক্ষ্য করা যেতে পারে। প্রস্তাবিত RedHerring—রিপোজিটরি অনুযায়ী মানিয়ে নেওয়া, সিল করা সার্টিফিকেটসহ প্রলোভন—সমান ব্যয়ে OSS-Fuzz-এর ৩৩টি প্রকল্পে শনাক্ত হওয়া প্রকৃত দুর্বলতার সংখ্যা ৩৮.৭–৬০.৪% কমিয়েছে; এজেন্টকে সতর্ক করার পরও এই হ্রাস ৩৭.২% ছিল।
9 নভেম্বর 2026
ফাইন-টিউনিং ছাড়াই উৎসের SQL উপস্থাপনার মাধ্যমে LLM-এর হ্যালুসিনেশন যাচাই করা
এই গবেষণায় যাচাই করা হয়েছে, হ্যালুসিনেশন শনাক্তকরণে তত্ত্বাবধান ছাড়াই উৎসের সঙ্গে সংযোগ স্থাপনের জন্য LLM কি একটি মৌলিক প্রতীকী দক্ষতা—উৎস নথি থেকে SQL ডেটাবেস তৈরি—ব্যবহার করতে পারে। RAGTruth ও DiaHalu-তে এই নিউরো-সিম্বলিক পাইপলাইনটি সরাসরি পূর্বাভাসের চেয়ে বেশি নির্ভুল এবং অত্যাধুনিক পদ্ধতিগুলোর সঙ্গে তুলনীয়, অথচ বিষয়ভিত্তিক সূক্ষ্ম-টিউনিংয়ের প্রয়োজন হয় না।
9 নভেম্বর 2026
MathAdv: মেশিন-উৎপন্ন প্রমাণের চূড়ান্ত নির্ভুলতার আড়ালে কী লুকিয়ে আছে
গণিতের ১৩টি বিশ্ববিদ্যালয় ও স্নাতকোত্তর শাখার কাজ নিয়ে তৈরি এই ডায়াগনস্টিক সেটটি Lean 4-এ মেশিন প্রুফ সিস্টেমকে শুধু চূড়ান্ত ফলাফলের ভিত্তিতে নয়, বিষয়জ্ঞান, অনানুষ্ঠানিক যুক্তির গুণমান এবং শর্তাবলি নতুনভাবে উপস্থাপন করা হলে তা সামাল দেওয়ার সক্ষমতার ভিত্তিতেও মূল্যায়ন করে। উপাদানভিত্তিক বিশ্লেষণে দেখা যায়, কোনো সমস্যাকে আনুষ্ঠানিক রূপে রূপান্তর করা এখনও প্রধান বাধা; আর সাফল্য গণিতের শাখা ও সমস্যা উপস্থাপনের পদ্ধতির ওপর অনেকটাই নির্ভর করে।
9 নভেম্বর 2026