
SpeechLLM-এর ওপর শ্রেণিবিন্যাসের অতিরিক্ত স্তর: আবেগ শনাক্তকরণে কোথায় এটি লেবেল তৈরির পদ্ধতিকে ছাড়িয়ে যায়
IEMOCAP ও MELD ডেটাসেটে কমপ্যাক্ট SpeechLLM-এর লুকানো উপস্থাপনার ওপর জেনারেটিভ আবেগ-লেবেল পূর্বাভাস এবং লিনিয়ার ক্লাসিফায়ারের তুলনা করা হয়েছে। ক্লাসিফায়ার থেকে প্রাপ্ত মানের উন্নতি সর্বজনীন নয়: এটি কর্পাসের ওপর এবং রেফারেন্স ট্রান্সক্রিপ্ট নাকি ASR-এর ফলাফল ব্যবহার করা হচ্ছে, তার ওপর নির্ভর করে।
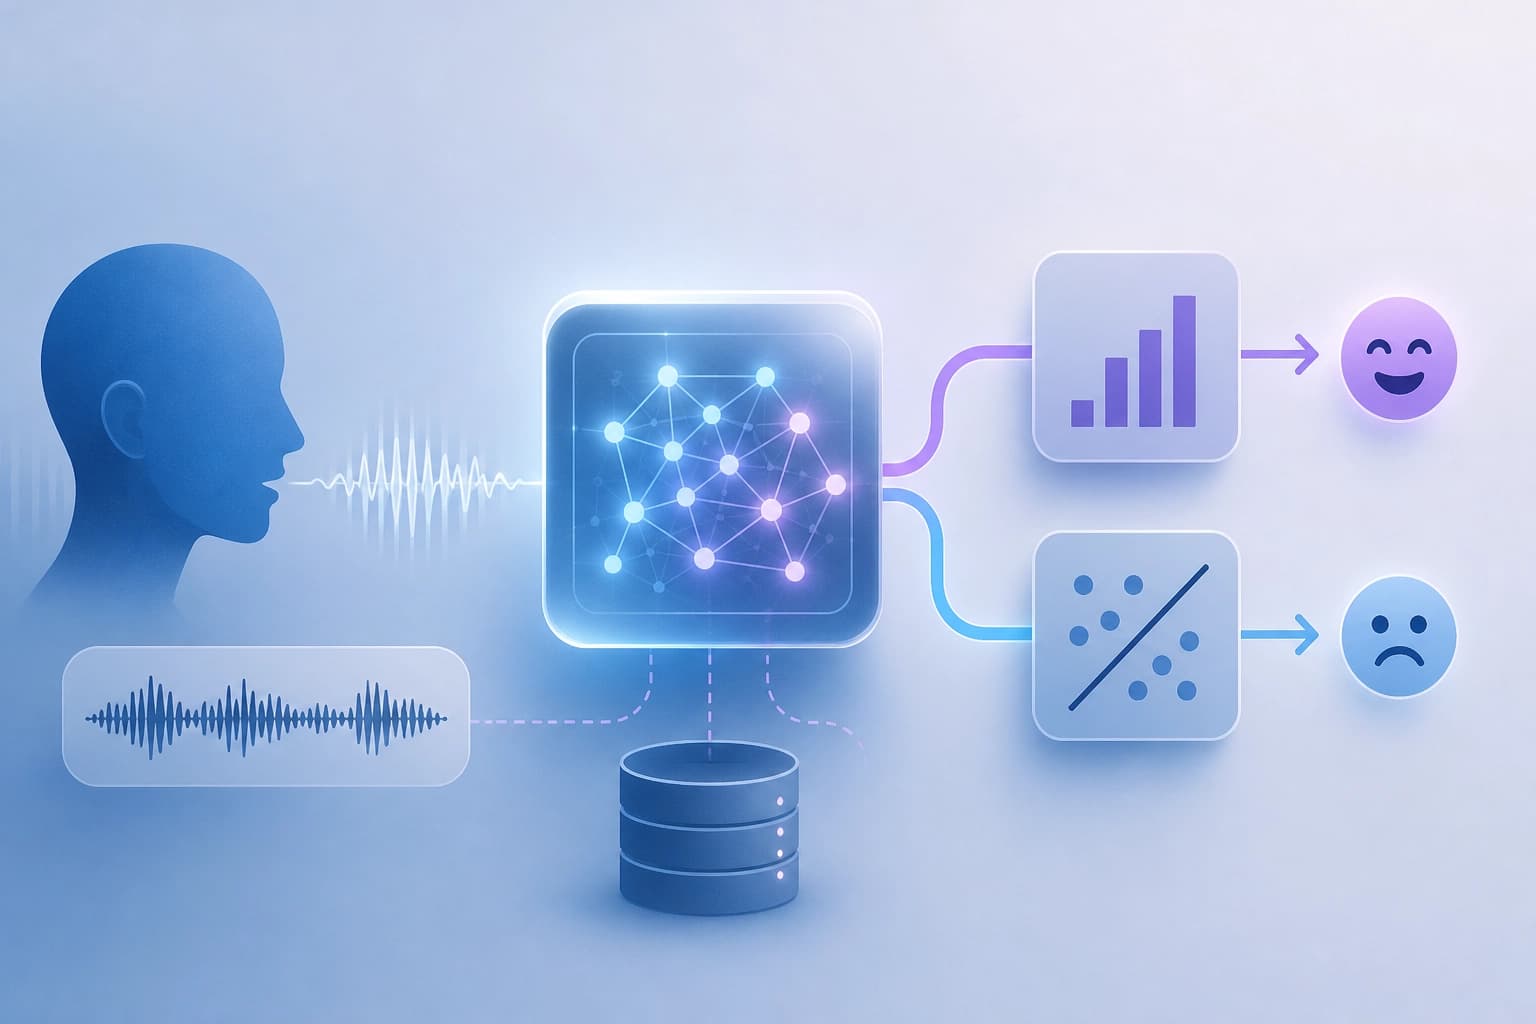
আবেগ শনাক্তকরণের দুটি পদ্ধতি
নিবন্ধটিতে LLM-এর লেবেল-টোকেন তৈরি এবং LLM-এর হিডেন স্টেটের ওপর লিনিয়ার হেড ব্যবহার করে ডিসক্রিমিনেটিভ শ্রেণিবিন্যাসের তুলনা করা হয়েছে। জেনারেটিভ পদ্ধতিটি LLM-এর আগে থেকেই থাকা আউটপুট রিপ্রেজেন্টেশনের ওপর নির্ভর করে। ডিসক্রিমিনেটিভ পদ্ধতিটি মডেলে আলাদা একটি শ্রেণিবিন্যাস হেড যোগ করে।
| মানদণ্ড | লেবেল-টোকেন তৈরি | ডিসক্রিমিনেটিভ শ্রেণিবিন্যাস |
|---|---|---|
| LLM-এর ভূমিকা | লেবেলের জন্য আউটপুট রিপ্রেজেন্টেশন দেয় | হেডের জন্য হিডেন স্টেট দেয় |
| সিদ্ধান্ত নেওয়ার প্রক্রিয়া | LLM একটি লেবেল-টোকেন তৈরি করে | লিনিয়ার হেড হিডেন স্টেটকে শ্রেণিবদ্ধ করে |
| কী ব্যবহার করা হয় | মডেলের প্রস্তুত আউটপুট | LLM-এর হিডেন স্টেট |
ব্যবহারিক পার্থক্য হলো, জেনারেশন মডেলের প্রস্তুত আউটপুট ব্যবহার করে, আর হেড হিডেন স্টেট থেকে তথ্য নেয়।
তুলনার শর্ত
IEMOCAP এবং MELD-এ তুলনা করা হয়েছে। একটি কমপ্যাক্ট SpeechLLM ব্যবহার করা হয়েছে: ফ্রোজেন Whisper-medium এনকোডার এবং 3B LLM। প্রতিটি তুলনায় রেফারেন্স ট্রান্সক্রিপ্ট এবং ASR ট্রান্সক্রিপ্ট নেওয়া হয়েছে। তুলনায় টেক্সটের দুটি উৎস অন্তর্ভুক্ত, তাই প্রতিটির জন্য আলাদাভাবে হেডের প্রভাব যাচাই করা হয়েছে। মূল্যায়নের মানদণ্ড: শুধু একই ডেটাসেট এবং একই ট্রান্সক্রিপ্ট উৎসের মধ্যেই ফলাফল তুলনা করা।
যেখানে শ্রেণিবিন্যাস হেড লেবেল জেনারেশনকে ছাড়িয়ে যায়
শ্রেণিবিন্যাস হেড ১৪টি কনফিগারেশনের মধ্যে ১০টিতে Macro F1 উন্নত করেছে। IEMOCAP-এ এটি ASR ট্রান্সক্রিপ্টসহ সব কনফিগারেশনে উন্নতি করেছে এবং 76.97% Macro F1 অর্জন করেছে। একই ডেটাসেটে শুধু-স্পিচ মোডেও উল্লেখযোগ্য উন্নতি দেখা গেছে। MELD-এ শুধু স্পিচ ব্যবহার করলে হেডটি সাহায্য করেছে, কিন্তু ASR ট্রান্সক্রিপ্টের ক্ষেত্রে নয়। উপসংহার: উন্নতির পরিমাণ ডেটাসেট এবং ট্রান্সক্রিপ্টের উৎসের ওপর নির্ভর করে। লেবেল জেনারেশনকে সব ক্ষেত্রে ছাড়িয়ে যাওয়ার কোনো পদ্ধতি নেই।
রেফারেন্স ট্রান্সক্রিপ্ট থেকে পাওয়া সিদ্ধান্ত কেন অন্য ক্ষেত্রে প্রয়োগ করা যায় না
MELD-এ ASR ট্রান্সক্রিপ্টের WER 32.38%। টেক্সটসহ ৬টি কনফিগারেশনের মধ্যে ৪টিতে রেফারেন্স ট্রান্সক্রিপ্ট ও ASR-এর মধ্যে হেডের প্রভাবের দিক বদলে যায়। তাই রেফারেন্স ট্রান্সক্রিপ্টের ভিত্তিতে নেওয়া সিদ্ধান্ত ASR-এর ক্ষেত্রেও প্রযোজ্য হবে, এমন নিশ্চয়তা নেই। ব্যবহারিক মানদণ্ড: যে টেক্সটের উৎস ব্যবহার করা হবে, সেই উৎসে হেডটি যাচাই করা।
অভিধানের নিকটতম টোকেনগুলো কী দেখায়
IEMOCAP এবং MELD-এ শেখা ক্লাস ভেক্টরের নিকটতম LLM অভিধান-টোকেনগুলো বেশিরভাগই আবেগের সঙ্গে সম্পর্কিত শব্দ ছিল। সেগুলো আবেগের সরাসরি নাম ছিল না। এতে বোঝা যায়, আবেগের স্পষ্ট নামটি নিকটতম অভিধান-টোকেনের সঙ্গে সব সময় মেলে না। যাচাইয়ের মানদণ্ড: শুধু লেবেলের নাম না দেখে, ক্লাস ভেক্টরের কাছাকাছি কোন টোকেনগুলো রয়েছে তা দেখা।
নির্বাচনের মানদণ্ড
পদ্ধতি বেছে নেওয়া দুটি বিষয়ের ওপর নির্ভর করে: ডেটাসেট এবং ট্রান্সক্রিপ্টের উৎস।
- ASR ট্রান্সক্রিপ্টের ক্ষেত্রে রেফারেন্স টেক্সটে নয়, ASR-এ হেডটি যাচাই করুন।
- শুধু-স্পিচ মোডের ক্ষেত্রে IEMOCAP এবং MELD-এ হওয়া উন্নতি বিবেচনা করুন।
- রেফারেন্স ট্রান্সক্রিপ্টের ফলাফল ASR-এর ক্ষেত্রে প্রয়োগ করবেন না।
- ক্লাসগুলো ব্যাখ্যা করতে LLM অভিধানের নিকটতম টোকেনগুলো দেখুন।
চূড়ান্ত মানদণ্ড: লক্ষ্য ডেটাসেট ও ট্রান্সক্রিপ্টের উৎসে যাচাই করে যেখানে উন্নতি দেখা যায়, সেখানেই হেড লেবেল জেনারেশনকে ছাড়িয়ে যায়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
চিকিৎসাবিষয়ক LLM-গুলো নির্দেশিকা সংশোধনের কথা জানে, কিন্তু প্রায়ই পুরোনো নিয়ম অনুযায়ী উত্তর দেয়
1709টি ক্লিনিক্যাল নির্দেশিকার পরিবর্তন নিয়ে ChronoEvo-এর গবেষণায় দেখা গেছে: মূল মডেলে 90,8% উত্তর নতুনত্বটি শনাক্ত করেছিল, তবে মাত্র 58,5% তা সম্পূর্ণভাবে প্রয়োগ করেছিল; 32,3 শতাংশ পয়েন্টের এই ব্যবধান 14টি মডেলেই বজায় ছিল। আপডেটগুলোর দৃশ্যমানতা বাড়িয়েও নতুন নিয়মগুলো ক্লিনিক্যাল নির্দেশিকায় সম্পূর্ণভাবে অন্তর্ভুক্ত করার ক্ষেত্রে উল্লেখযোগ্য উন্নতি হয়নি।
4 নভেম্বর 2026
সীমাবদ্ধ LLM-এ এজেন্টদের জন্য বিশ্ব মডেল: ঝুঁকির মুহূর্তে সংশোধন
PAWM প্রস্তাব করা হয়েছে—একটি বাহ্যিক পূর্বাভাসদাতা, যা ধাপে ধাপে পর্যবেক্ষণের পুনরাবৃত্তি না করে সম্ভাব্য ব্যর্থতার সময় সক্রিয় হয় এবং এজেন্টকে ভুল পদক্ষেপ থেকে সরিয়ে দেয়। সিন্থেটিক পরিস্থিতিতে SFT এবং GRPO-সহ-প্রশিক্ষণের পর, Claude Sonnet 4.5-এর জন্য পদ্ধতিটি ScienceWorld-এ 24,3% এবং WebArena-Lite-এ 7,7% উন্নতি এনেছে।
4 নভেম্বর 2026
ব্যক্তিগত স্কোর থেকে অনুমোদিত সেটে: DDI সীমাবদ্ধতার অধীনে গ্লোবাল ডিকোডিং
নিবন্ধটি MIMIC-III-তে FLAME-এর নির্দিষ্ট স্কোর ব্যবহার করে mixed-integer linear programming-এর মাধ্যমে বাস্তবায়িত সামঞ্জস্যপূর্ণ ওষুধের সেটের নির্ভুল বৈশ্বিক নির্বাচনকে DDI সংঘাত স্থানীয়ভাবে দূর করার কয়েকটি পদ্ধতির সঙ্গে তুলনা করেছে। পরীক্ষামূলক নমুনায় বৈশ্বিক পদ্ধতিটি Jaccard স্কোরে সামান্য হলেও ধারাবাহিক উন্নতি দেখায়, যা সীমাবদ্ধতা আরও কঠোর হলে বাড়ে এবং সবচেয়ে শক্তিশালী স্থানীয় বেসলাইন পদ্ধতির তুলনায় +0.0064-এ পৌঁছায়।
4 নভেম্বর 2026