
ব্যক্তিগত স্কোর থেকে অনুমোদিত সেটে: DDI সীমাবদ্ধতার অধীনে গ্লোবাল ডিকোডিং
নিবন্ধটি MIMIC-III-তে FLAME-এর নির্দিষ্ট স্কোর ব্যবহার করে mixed-integer linear programming-এর মাধ্যমে বাস্তবায়িত সামঞ্জস্যপূর্ণ ওষুধের সেটের নির্ভুল বৈশ্বিক নির্বাচনকে DDI সংঘাত স্থানীয়ভাবে দূর করার কয়েকটি পদ্ধতির সঙ্গে তুলনা করেছে। পরীক্ষামূলক নমুনায় বৈশ্বিক পদ্ধতিটি Jaccard স্কোরে সামান্য হলেও ধারাবাহিক উন্নতি দেখায়, যা সীমাবদ্ধতা আরও কঠোর হলে বাড়ে এবং সবচেয়ে শক্তিশালী স্থানীয় বেসলাইন পদ্ধতির তুলনায় +0.0064-এ পৌঁছায়।
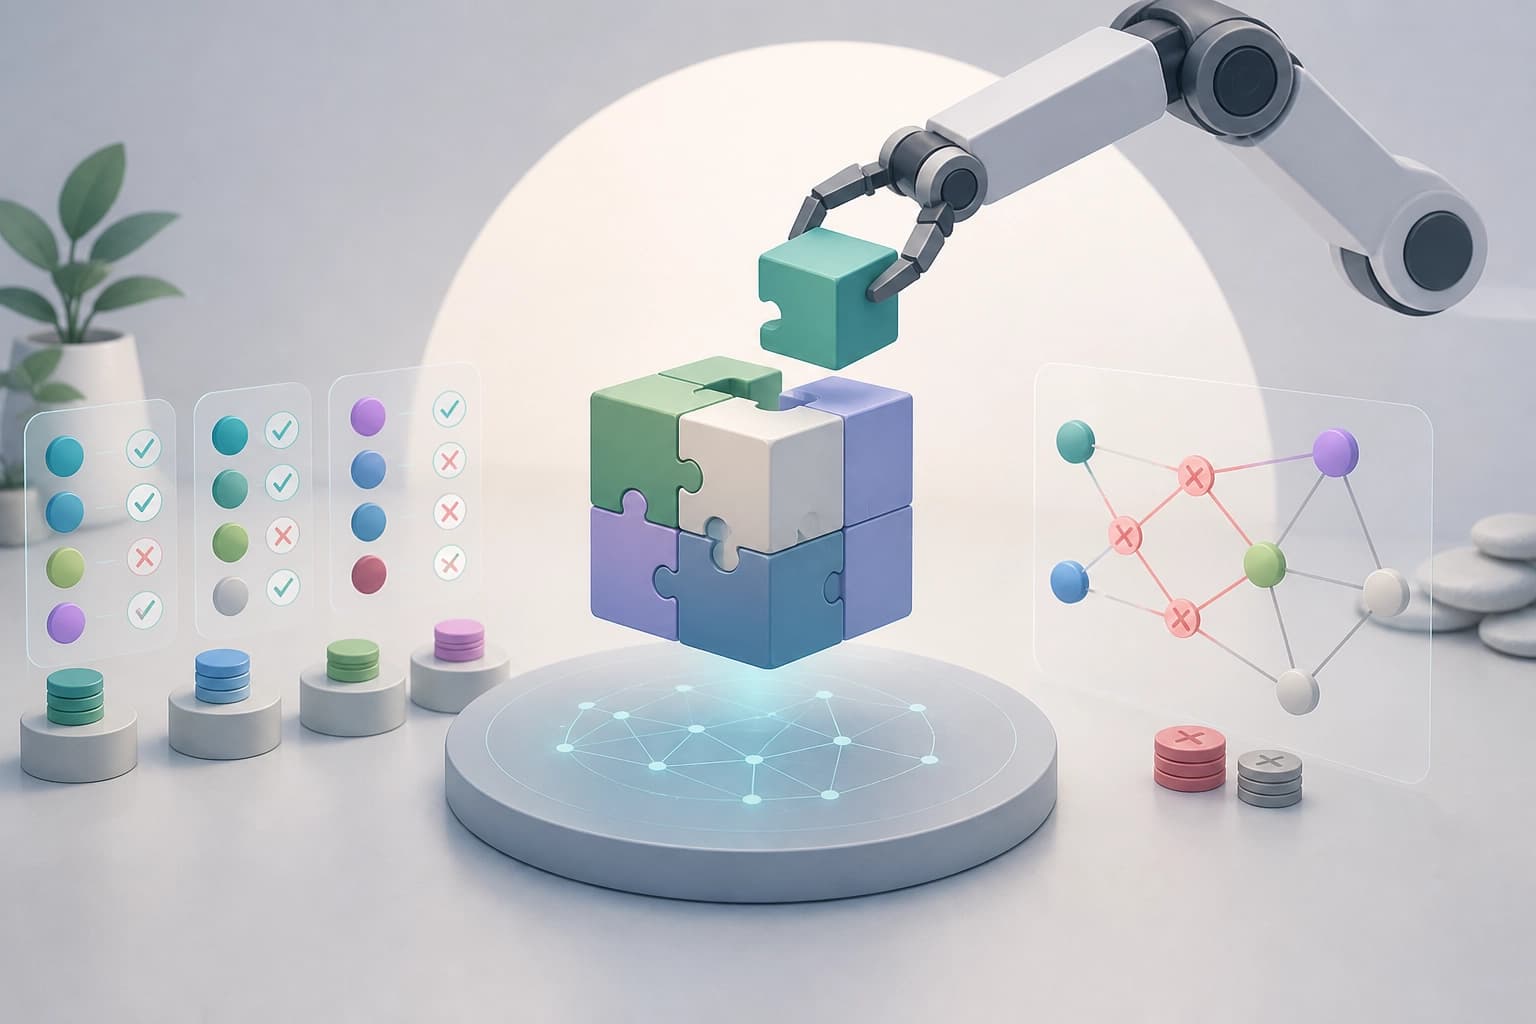
সমস্যার বিন্যাস: স্কোর থেকে গ্রহণযোগ্য সেটে
ওষুধের সুপারিশের জন্য শুধু ওষুধের উচ্চ স্কোরই যথেষ্ট নয়। DDI মিথস্ক্রিয়ার দিক থেকে সেটটি গ্রহণযোগ্য হতে হবে। arXiv:2610.29228 গবেষণাপত্রটি ২১ অক্টোবর ২০২৬-এ প্রকাশিত হয়েছে। এতে স্থানীয় সংশোধনের সঙ্গে নির্ভুল গ্লোবাল ডিকোডিংয়ের তুলনা করা হয়েছে। সব তুলনায় ওষুধের স্কোর, আউটপুট সেটের আকার এবং DDI সীমাবদ্ধতা অপরিবর্তিত রাখা হয়েছে।
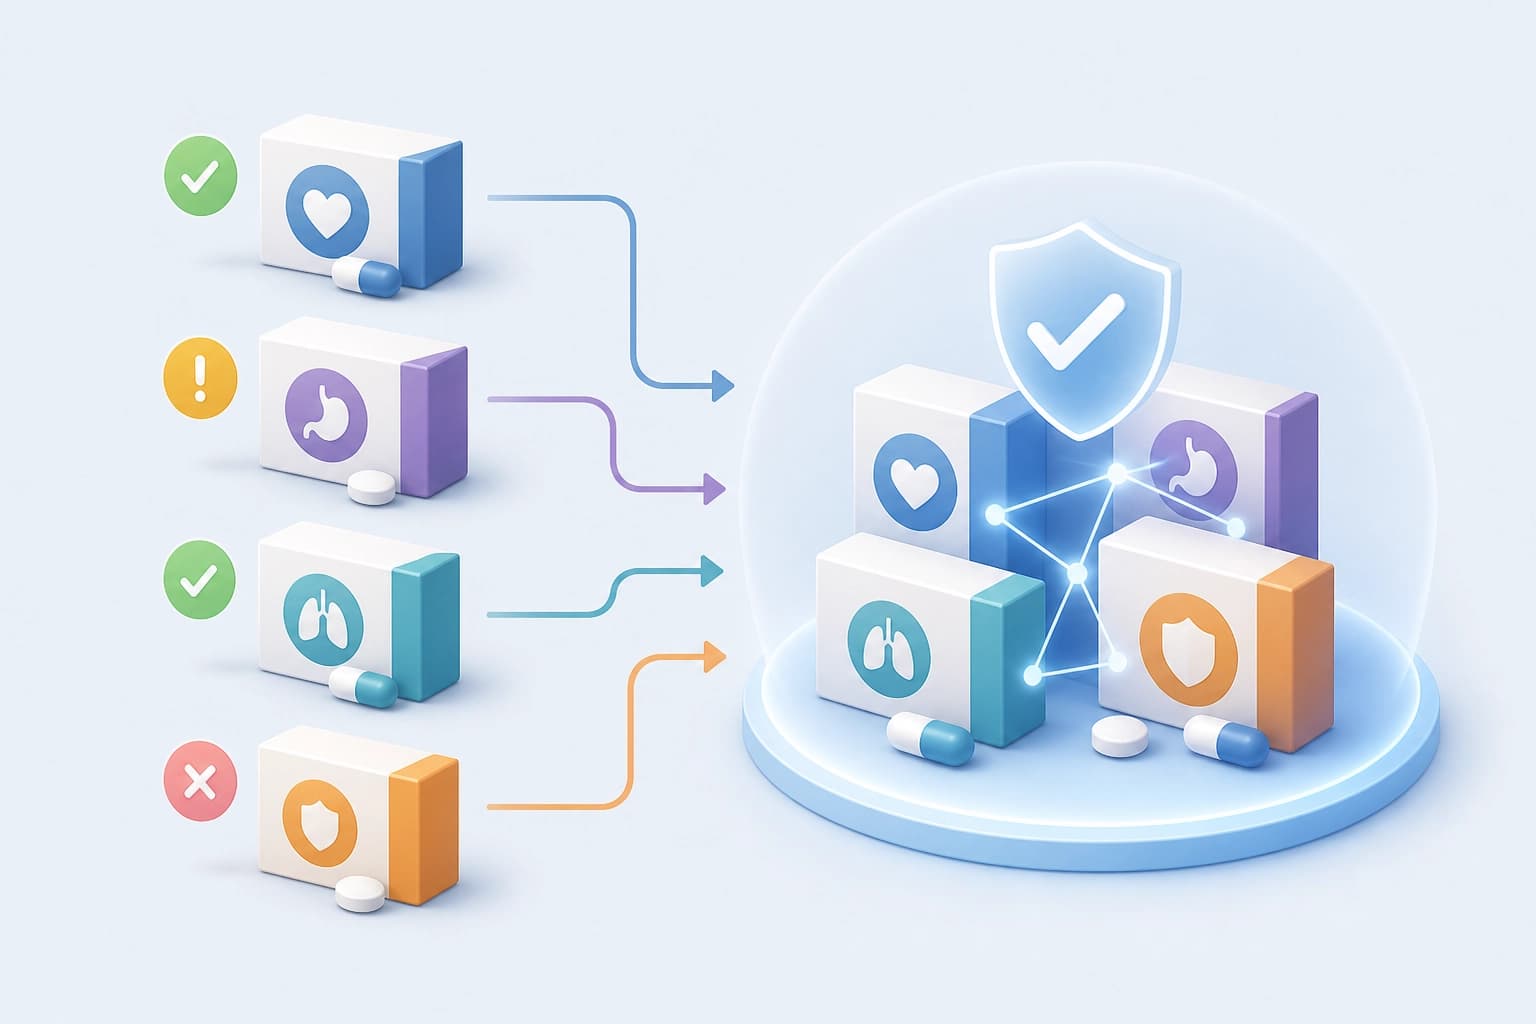
গবেষণায় MIMIC-III-এ ফ্রোজেন FLAME ক্লাসিফায়ারের স্কোর ব্যবহার করা হয়েছে। তুলনার মূল শর্তগুলো হলো:
- ওষুধের স্কোর অপরিবর্তিত রাখা হয়েছে;
- আউটপুট সেটের আকার অপরিবর্তিত রাখা হয়েছে;
- DDI সীমাবদ্ধতা অপরিবর্তিত রাখা হয়েছে।
উপসংহার: স্কোর, সেটের আকার এবং DDI সীমাবদ্ধতা একই থাকলেই পদ্ধতিগুলোর তুলনা অর্থবহ হয়। তা না হলে Jaccard-এর পার্থক্য থেকে পদ্ধতির অবদান বোঝা যায় না।
MILP-এর মাধ্যমে গ্লোবাল ডিকোডিং
গ্লোবাল ডিকোডার যৌথভাবে গ্রহণযোগ্য ওষুধের সেট নির্বাচন করে। DDI সীমাবদ্ধতার অধীনে এটি সর্বোচ্চ স্কোরযুক্ত গ্রহণযোগ্য সেটটি বেছে নেয়। এর জন্য mixed-integer linear programming ব্যবহার করা হয়। নিবন্ধে এই পদ্ধতিকে নির্ভুল গ্লোবাল ডিকোডিং বলা হয়েছে।
ধাপগুলো:
- ওষুধের স্কোর সংগ্রহ করা;
- আউটপুট সেটের আকার নির্ধারণ করা;
- DDI সীমাবদ্ধতা নির্ধারণ করা;
- MILP-এর মাধ্যমে সর্বোচ্চ স্কোরযুক্ত গ্রহণযোগ্য সেট খুঁজে বের করা।
উপসংহার: গ্লোবাল ডিকোডিং পুরো সেট নির্বাচনের সমস্যাটি সমাধান করে। ব্যবহারিক মানদণ্ড—DDI সীমাবদ্ধতা কঠোরভাবে নির্ধারিত থাকলে এবং গ্রহণযোগ্যতা নির্ভুলভাবে বজায় রাখতে হলে এটি প্রয়োগ করুন।
সংশোধনের স্থানীয় কৌশল
স্থানীয় পদ্ধতিগুলো সেটে থাকা DDI লঙ্ঘন সংশোধন করে। গবেষণায় তিনটি কৌশলের তুলনা করা হয়েছে। Greedy repair লোভী পদ্ধতিতে সংশোধন করে। Degree-aware repair নোডের ডিগ্রি বিবেচনায় নেয়। উন্নত সংস্করণে exhaustive 1-swap local search যোগ করা হয়।
কৌশলগুলো:
- greedy repair;
- degree-aware repair;
- exhaustive 1-swap local search দিয়ে শক্তিশালী করা degree-aware repair।
উপসংহার: স্থানীয় পদ্ধতিগুলো কাঠামো বিবেচনা এবং স্থানীয় অনুসন্ধানের পরিধির দিক থেকে ভিন্ন। নির্বাচনের মানদণ্ড—কৌশলটি কীভাবে DDI লঙ্ঘন সংশোধন করে এবং ওষুধের স্কোর অক্ষুণ্ণ রাখে, তা যাচাই করুন।
validation ও test split-এ তুলনা
validation ও test split-এ গ্লোবাল ডিকোডিং ধারাবাহিকভাবে স্থানীয় পদ্ধতিগুলোর চেয়ে বেশি Jaccard similarity দেয়।
| পদ্ধতি | শ্রেণি | নিবন্ধে ফলাফল |
|---|---|---|
| গ্লোবাল ডিকোডিং | নির্ভুল গ্লোবাল | validation ও test-এ বেশি Jaccard |
| Greedy repair | স্থানীয় সংশোধন | তুলনা করা হয়েছে; Jaccard-এ গ্লোবাল ডিকোডিংয়ের চেয়ে পিছিয়ে |
| Degree-aware repair | স্থানীয় সংশোধন | তুলনা করা হয়েছে; Jaccard-এ গ্লোবাল ডিকোডিংয়ের চেয়ে পিছিয়ে |
| Degree-aware repair + exhaustive 1-swap | স্থানীয় সংশোধন | তুলনা করা হয়েছে; Jaccard-এ গ্লোবাল ডিকোডিংয়ের চেয়ে পিছিয়ে |
উপসংহার: Jaccard similarity-এর বিচারে validation ও test-এ গ্লোবাল ডিকোডিং স্থানীয় পদ্ধতিগুলোকে ছাড়িয়ে যায়। মানদণ্ড—পদ্ধতি বেছে নেওয়ার সময় Jaccard similarity-কে গুরুত্ব দিন।
DDI সীমাবদ্ধতার কঠোরতা ও ত্রুটির ধরন
loose DDI constraints-এর ক্ষেত্রে গ্লোবাল ডিকোডিংয়ের সুবিধা সামান্য। সীমাবদ্ধতা কঠোর করার সঙ্গে সঙ্গে এই সুবিধা বাড়ে। test split-এ strict DDI operating point-এ strongest local baseline-এর তুলনায় সুবিধা +0.0064 Jaccard।
ফলাফলটি বজায় থাকে:
- fine accuracy–DDI sweep-এ matched realized DDI exposure সহ;
- স্কোরের তিনটি উপস্থাপনার ক্ষেত্রেই।
strict setting-এ গ্লোবাল ডিকোডিং আরও বেশি true-positive medications অক্ষুণ্ণ রাখে। একই সঙ্গে এটি আরও বেশি false positives বাদ দেয়।
উপসংহার: DDI সীমাবদ্ধতা যত কঠোর হয়, সেটের গ্লোবাল নির্বাচন তত গুরুত্বপূর্ণ হয়ে ওঠে। ব্যবহারিক মানদণ্ড—strict মোডে Jaccard, true-positive medications ধরে রাখা এবং false positives বাদ দেওয়ার ভিত্তিতে পদ্ধতির মূল্যায়ন করুন।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
চিকিৎসাবিষয়ক LLM-গুলো নির্দেশিকা সংশোধনের কথা জানে, কিন্তু প্রায়ই পুরোনো নিয়ম অনুযায়ী উত্তর দেয়
1709টি ক্লিনিক্যাল নির্দেশিকার পরিবর্তন নিয়ে ChronoEvo-এর গবেষণায় দেখা গেছে: মূল মডেলে 90,8% উত্তর নতুনত্বটি শনাক্ত করেছিল, তবে মাত্র 58,5% তা সম্পূর্ণভাবে প্রয়োগ করেছিল; 32,3 শতাংশ পয়েন্টের এই ব্যবধান 14টি মডেলেই বজায় ছিল। আপডেটগুলোর দৃশ্যমানতা বাড়িয়েও নতুন নিয়মগুলো ক্লিনিক্যাল নির্দেশিকায় সম্পূর্ণভাবে অন্তর্ভুক্ত করার ক্ষেত্রে উল্লেখযোগ্য উন্নতি হয়নি।
4 নভেম্বর 2026
সীমাবদ্ধ LLM-এ এজেন্টদের জন্য বিশ্ব মডেল: ঝুঁকির মুহূর্তে সংশোধন
PAWM প্রস্তাব করা হয়েছে—একটি বাহ্যিক পূর্বাভাসদাতা, যা ধাপে ধাপে পর্যবেক্ষণের পুনরাবৃত্তি না করে সম্ভাব্য ব্যর্থতার সময় সক্রিয় হয় এবং এজেন্টকে ভুল পদক্ষেপ থেকে সরিয়ে দেয়। সিন্থেটিক পরিস্থিতিতে SFT এবং GRPO-সহ-প্রশিক্ষণের পর, Claude Sonnet 4.5-এর জন্য পদ্ধতিটি ScienceWorld-এ 24,3% এবং WebArena-Lite-এ 7,7% উন্নতি এনেছে।
4 নভেম্বর 2026
SpeechLLM-এর ওপর শ্রেণিবিন্যাসের অতিরিক্ত স্তর: আবেগ শনাক্তকরণে কোথায় এটি লেবেল তৈরির পদ্ধতিকে ছাড়িয়ে যায়
IEMOCAP ও MELD ডেটাসেটে কমপ্যাক্ট SpeechLLM-এর লুকানো উপস্থাপনার ওপর জেনারেটিভ আবেগ-লেবেল পূর্বাভাস এবং লিনিয়ার ক্লাসিফায়ারের তুলনা করা হয়েছে। ক্লাসিফায়ার থেকে প্রাপ্ত মানের উন্নতি সর্বজনীন নয়: এটি কর্পাসের ওপর এবং রেফারেন্স ট্রান্সক্রিপ্ট নাকি ASR-এর ফলাফল ব্যবহার করা হচ্ছে, তার ওপর নির্ভর করে।
4 নভেম্বর 2026