
Linkup-এর SPARSEUP: ১৪৯ মিলিয়ন প্যারামিটারের একটি স্পার্স এনকোডার
এই নিবন্ধে SPARSEUP-এর আর্কিটেকচার ও এর ফলাফল পর্যালোচনা করা হয়েছে: BEIR-13-এ 56,4 nDCG@10, এবং Seismic ইনডেক্সের সঙ্গে মিলিয়ে প্রতি কোয়েরিতে প্রায় 380 মাইক্রোসেকেন্ডে 97%-এর বেশি রিকল। এতে ভেক্টরের স্পার্সিটি বজায় রাখার কৌশল, অন্যান্য মডেলের সঙ্গে তুলনা এবং Apache 2.0-এর অধীনে বিতরণের শর্তাবলি আলোচনা করা হয়েছে।
মডেলটি কী এবং কীভাবে অ্যাক্সেস পাবেন
SPARSEUP হলো Linkup Research-এর 149 মিলিয়ন প্যারামিটারের একটি ওপেন স্পার্স এনকোডার। এর ব্যাকবোন ModernBERT, আর লাইসেন্স Apache 2.0।
ওয়েটগুলো পাওয়া যাবে Hugging Face-এ। trust_remote_code=True উল্লেখ করে Transformers অথবা Sentence Transformers-এর মাধ্যমে মডেলটি লোড করা যায়।
Linkup-এর মতে, 150 মিলিয়নের কম প্যারামিটারের মডেলগুলোর মধ্যে এটিই কোম্পানির জানা সবচেয়ে শক্তিশালী পাবলিক ভোকাবুলারি-ভিত্তিক স্পার্স এনকোডার।
স্পার্স উপস্থাপনা কীভাবে কাজ করে
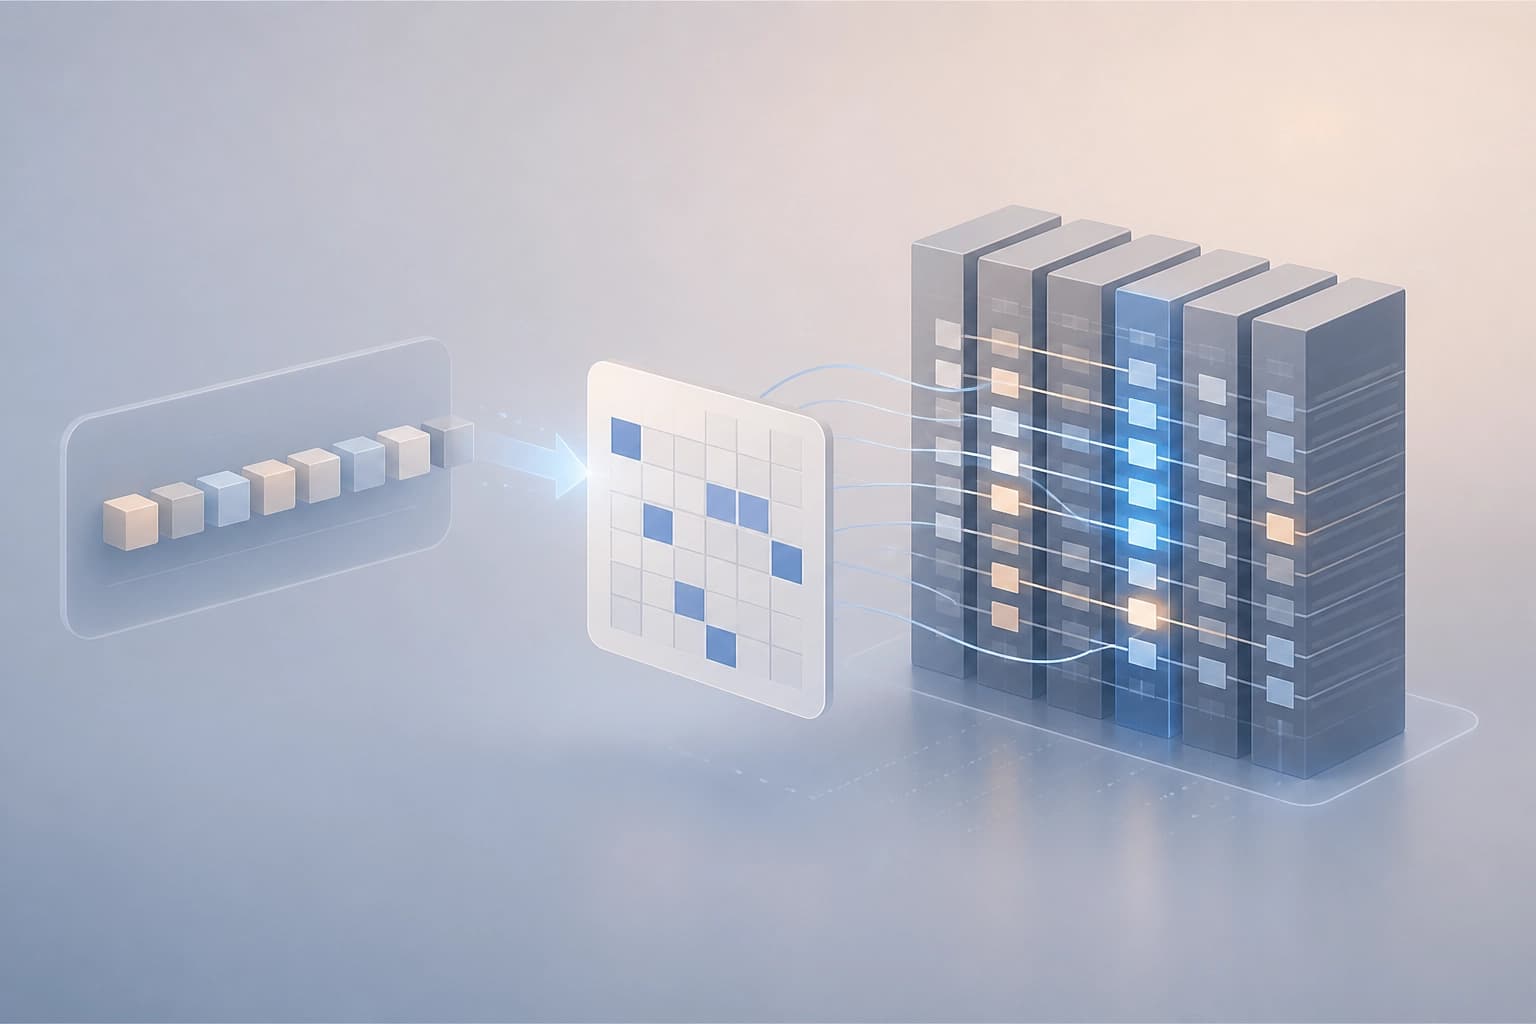
SPARSEUP-এ ভেক্টরের প্রতিটি ডাইমেনশন ভোকাবুলারির একটি টোকেনের সঙ্গে মেলে। এ ধরনের ভেক্টর ইনভার্টেড ইনডেক্সের জন্য উপযোগী এবং বিরল শব্দ আরও ভালোভাবে মেলায়।
মডেলটি log(1 + ReLU(x - 15)) সূত্র ব্যবহার করে অ্যাক্টিভেশন গণনা করে। এরপর max pooling-এর আগে প্রতিটি ইনপুট টোকেনের জন্য সবচেয়ে শক্তিশালী 12টি ডাইমেনশন রাখে।
এতে ভেক্টরের সামগ্রিক আকার নয়, বরং প্রতি টোকেনে সক্রিয় ডাইমেনশনের সংখ্যা সীমিত হয়। Case folding Byte-level BPE-এর বিভিন্ন রূপকে একত্র করে—যেমন heat, Heat, Ġheat এবং ĠHeat—এবং সর্বোচ্চ ওজনটি ধরে রাখে।
একত্র করার পর আউটপুট ডাইমেনশনের সংখ্যা প্রায় 50 হাজার থেকে কমে 34 হাজার হয়। কোয়েরি ও ডকুমেন্টে [Q] এবং [D] প্রিফিক্স যোগ করা হয়; স্কোর গণনা করা হয় ডট প্রোডাক্ট দিয়ে।
স্কোরিংয়ের সময় সর্বোচ্চ দৈর্ঘ্য কোয়েরির জন্য 128 টোকেন এবং ডকুমেন্টের জন্য 512 টোকেন। ইনপুট প্রক্রিয়াকরণ কনফিগার করার সময় এই সীমাগুলো গুরুত্বপূর্ণ।
মডেলটি কীভাবে প্রশিক্ষণ দেওয়া হয়েছে
SPARSEUP-এর প্রশিক্ষণ শুরু হয়েছিল LateOn-unsupervised চেকপয়েন্ট থেকে। দলটি ModernBERT-এর মূল MLM হেড ফিরিয়ে এনেছিল।
ফাইন-টিউনিংয়ের জন্য LightOn ডেটার মিশ্রণ ব্যবহার করা হয়েছিল এবং শুধু কনট্রাস্টিভ লার্নিং প্রয়োগ করা হয়েছিল। প্রতিটি কোয়েরির জন্য 50টির পুল থেকে সাতটি হার্ড নেগেটিভ বেছে নেওয়া হয়েছিল, পাশাপাশি ইন-ব্যাচ নেগেটিভও ব্যবহার করা হয়েছিল।
দলটি cross-encoder ডিস্টিলেশন প্রয়োগ করেনি। প্রশিক্ষণ একটি H100-এই সম্পন্ন হয়েছিল।
তুলনাগুলো কী দেখায়
MS MARCO বাদে BEIR-13-এ SPARSEUP-এর গড় ফল 56,4 nDCG@10। Model card-এ স্পার্স এনকোডারগুলোর ফল এভাবে দেওয়া হয়েছে:
| মডেল | BEIR-13, nDCG@10 |
|---|---|
| SPARSEUP | 56,4 |
| opensearch-neural-sparse-encoding-doc-v3-gte | 54,6 |
| opensearch-neural-sparse-encoding-v1 | 52,44 |
| ModernBERT-VT | 52,4 |
| splade-v3 | 51,7 |
| granite-embedding-30m-sparse | 50,6 |
LACONIC-1B-এর স্কোর 58,7, তবে এটি ভিন্ন আকারের শ্রেণির মডেল: এতে 1 বিলিয়ন প্যারামিটার রয়েছে।
একই ব্যাকবোন ও ডেটা ব্যবহার করে নিয়ন্ত্রিত তুলনায় LateOn-এর স্কোর ছিল 58,9, DenseOn-এর 57,9 এবং SPARSEUP-এর 56,4। নিবন্ধের সারাংশে DenseOn-এর চেয়ে 1,52 পয়েন্ট এবং LateOn-এর চেয়ে 2,5 পয়েন্ট পিছিয়ে থাকার কথা বলা হয়েছে।
SPARSEUP ArguAna এবং HotpotQA-তে DenseOn-কে ছাড়িয়ে গেছে, আর Touché-তে আরও ভালো ফল করেছে। বেশি সেম্যান্টিক কোয়েরিযুক্ত ডেটাসেটে মডেলটি পিছিয়ে থাকে; FiQA-তে এই পার্থক্য বিশেষভাবে লক্ষণীয়। DBPedia-কেও একটি দুর্বল দিক হিসেবে উল্লেখ করা হয়েছে।
Decontaminated BEIR-এ DenseOn-এর সঙ্গে ব্যবধান কমে 0,17 পয়েন্টে দাঁড়ায়। Decontaminated NQ এবং MS MARCO-এর জন্য যথাক্রমে মাত্র 21 এবং 46টি কোয়েরি ব্যবহার করা হয়েছিল, তাই Linkup সতর্ক করেছে যে ফলগুলোতে অনিশ্চয়তা থাকতে পারে।
স্পার্সনেস এবং বাছাইয়ের মানদণ্ড
MS MARCO-তে SPARSEUP প্রতি কোয়েরিতে গড়ে 47টি এবং প্রতি ডকুমেন্টে 190টি নন-জিরো টার্ম ব্যবহার করে। SPLADE-v3-এর জন্য কোয়েরিপ্রতি 25টি এবং ডকুমেন্টপ্রতি 170টি টার্ম উল্লেখ করা হয়েছে।
Seismic ইনভার্টেড ইনডেক্সের সঙ্গে মডেলটি একক থ্রেডে প্রতি কোয়েরিতে প্রায় 380 মাইক্রোসেকেন্ডে exact search-এর তুলনায় 97%-এর বেশি recall অর্জন করে।
স্পার্স উপস্থাপনা এবং ইনভার্টেড ইনডেক্সের মাধ্যমে সার্চ গুরুত্বপূর্ণ হলে SPARSEUP বিবেচনা করা যেতে পারে। মূল্যায়নের সময় প্রাসঙ্গিক ডেটাসেটগুলোর ফলও বিবেচনায় রাখা উচিত: সেম্যান্টিক কোয়েরি, FiQA এবং DBPedia-তে মডেলটি তুলনামূলকভাবে দুর্বল।
Linkup মনে করে, ভেক্টরের আকার বাড়ালে BEIR-এ 1–2 পয়েন্ট যোগ হতে পারত। তবে দলটি মডেলটির স্পার্সনেস বজায় রাখার সিদ্ধান্ত নিয়েছে।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ইন্টারঅ্যাকটিভ XR ডেভেলপমেন্টে কোডিং এজেন্টদের মূল্যায়ন: GenXR-Bench-এর ফলাফল
প্রকাশিত হয়েছে GenXR-Bench—ইন্টারেক্টিভ XR ডেভেলপমেন্টে কোডিং এজেন্টগুলোর এন্ড-টু-এন্ড মূল্যায়নের জন্য ১১২টি বিশেষজ্ঞ-নির্ধারিত কাজের একটি সেট: ফিচার উন্নত করা ও ত্রুটি ঠিক করা থেকে শুরু করে ভোক্তা-পর্যায়ের ডিভাইসে আচরণ যাচাইসহ অ্যাপ্লিকেশন তৈরি পর্যন্ত। পরীক্ষিত দশটি মডেলের মধ্যে সেরা ফল ছিল ৫০.৯% Pass@1; বারবার দেখা ব্যর্থতার মধ্যে রয়েছে সেন্সরের অ্যাসিঙ্ক্রোনাস ইভেন্ট সামলানো, বাস্তব স্থানের সঙ্গে অবজেক্ট যুক্ত করা এবং ভৌত প্রেক্ষাপটে মিথস্ক্রিয়া বোঝা।
5 নভেম্বর 2026
স্কেলার পুরস্কার থেকে প্যারেটো ফ্রন্টিয়ার: বহু-উদ্দেশ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের মাধ্যমে LLM-ভিত্তিক RTL সংশ্লেষণ
একটি ভাষা মডেলকে একটি মাত্র নকশা নয়, বরং ক্ষেত্রফল, বিলম্ব ও বিদ্যুৎ খরচের মধ্যে বিভিন্ন সমঝোতাসহ একগুচ্ছ RTL প্রার্থী তৈরি করতে প্রশিক্ষণ দেওয়ার একটি পদ্ধতি প্রস্তাব করা হয়েছে; পুরস্কার নির্ধারিত হয় প্যারেটো ফ্রন্টের হাইপারভলিউমে প্রতিটি বিকল্পের অবদানের ভিত্তিতে। RTLLM v2-তে আপেক্ষিক হাইপারভলিউম PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণের তুলনায় ১৩.৩ শতাংশ পয়েন্ট এবং একক-লক্ষ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের তুলনায় ১৪.৪ শতাংশ পয়েন্ট বেড়েছে।
5 নভেম্বর 2026
চিকিৎসাবিষয়ক LLM-গুলো নির্দেশিকা সংশোধনের কথা জানে, কিন্তু প্রায়ই পুরোনো নিয়ম অনুযায়ী উত্তর দেয়
1709টি ক্লিনিক্যাল নির্দেশিকার পরিবর্তন নিয়ে ChronoEvo-এর গবেষণায় দেখা গেছে: মূল মডেলে 90,8% উত্তর নতুনত্বটি শনাক্ত করেছিল, তবে মাত্র 58,5% তা সম্পূর্ণভাবে প্রয়োগ করেছিল; 32,3 শতাংশ পয়েন্টের এই ব্যবধান 14টি মডেলেই বজায় ছিল। আপডেটগুলোর দৃশ্যমানতা বাড়িয়েও নতুন নিয়মগুলো ক্লিনিক্যাল নির্দেশিকায় সম্পূর্ণভাবে অন্তর্ভুক্ত করার ক্ষেত্রে উল্লেখযোগ্য উন্নতি হয়নি।
4 নভেম্বর 2026