
সমস্যা: যে কোড চলে, কিন্তু ভুল কাজ করে
বড় ভাষা মডেল-ভিত্তিক এজেন্টরা এখন ইতিমধ্যেই একটি বৈজ্ঞানিক নিবন্ধ নিয়ে সেটির উপর ভিত্তি করে একটি কার্যকর রিপোজিটরি তৈরি করতে পারে। সমস্যা হলো, "কার্যকর" আর "পুনরুৎপাদনকারী" সমার্থক নয়। একটি স্ক্রিপ্ট সফলভাবে সব টেস্ট পাস করতে পারে, মডেল ট্রেন করতে পারে এবং একটি সুন্দর মেট্রিক ছাপতে পারে, অথচ ভেতরে ধাপগুলোর ক্রম অলক্ষ্যে বদলে দেওয়া হতে পারে, লস ফাংশনে একটি গুণক হারিয়ে যেতে পারে, বা জটিল কোনো ধাপের জায়গায় একটি স্টাব বসিয়ে দেওয়া হতে পারে।
এই ব্যর্থতার ধরনটিকেই নতুন গবেষণাপত্রের লেখকেরা সেমান্টিক ড্রিফট (semantic drift) নাম দিয়েছেন: জেনারেট করা কোড চুপচাপ নিবন্ধের স্পেসিফিকেশনে যা বর্ণিত আছে তার থেকে বিচ্যুত হয়ে যায়। ভুলটি চোখে পড়ে না — এটি এমন সব সূক্ষ্ম বিষয়ের ভেতরে বাস করে, যা কেউ স্বয়ংক্রিয়ভাবে যাচাই করে না। ফলাফল — এমন একটি পুনরুৎপাদন, যা আনুষ্ঠানিকভাবে সম্পন্ন হয়েছে, কিন্তু বৈজ্ঞানিকভাবে কিছুই প্রমাণ করে না।
SA-Bench কী
ড্রিফট পরিমাপ করতে হলে প্রথমে এটিকে পর্যবেক্ষণযোগ্য করে তুলতে হবে। এই কাজটিই করে SemanticAlign-Bench, সংক্ষেপে SA-Bench — একটি ডায়াগনস্টিক বেঞ্চমার্ক, যা arXiv:2608.24252 নিবন্ধে বর্ণিত (Findings of EMNLP 2026-এ গৃহীত, লেখকেরা — Xue Hu, Zewei Pan, Zeli Su, Zhou Liu এবং Wentao Zhang)।
এই উপাদানটি ICLR, ICML এবং NeurIPS 2025 সম্মেলনের ৩০টি গবেষণাপত্র জুড়ে বিস্তৃত এবং মেশিন লার্নিংয়ের পাঁচটি ক্ষেত্রে বিভক্ত। এখানে কোড নিয়ে "অনুভূতি" নয়, বরং যাচাইযোগ্য দাবির একটি সেট মূল্যায়ন করা হয়। বেঞ্চমার্কটিতে মোট এমন ১,৪৯১টি দাবি সংগৃহীত হয়েছে।
Semantic Alignment Units: স্পেসিফিকেশনের পরমাণু
মূল পদ্ধতিগত ধারণাটি হলো নিবন্ধের বর্ণনাকে ক্ষুদ্রতম উপাদানে ভেঙে ফেলা, যা রিপোজিটরি দেখে হাতে যাচাই করা যায়। এই উপাদানগুলোকে Semantic Alignment Units (SAU) বলা হয়। প্রতিটি একক হলো বাস্তবায়ন সম্পর্কে একটি আলাদা দাবি: একটি নির্দিষ্ট হাইপারপ্যারামিটার, সূত্র, অপারেশনের ক্রম, থামার শর্ত, ডেটা বিভাজনের স্কিম।
এই সূক্ষ্ম-দানাদার পদ্ধতিটি গুরুত্বপূর্ণ, কারণ এটি মূল্যায়নকে "হয়েছে / হয়নি" এই দ্বিমুখী অবস্থা থেকে মুক্ত করে। প্রতি নিবন্ধে একটি টিকচিহ্নের বদলে শতাধিক ছোট প্রশ্ন উঠে আসে, এবং দেখা যায় ঠিক কোথায় বাস্তবায়ন দুর্বল হয়েছে।
ড্রিফটের চারটি মাত্রা
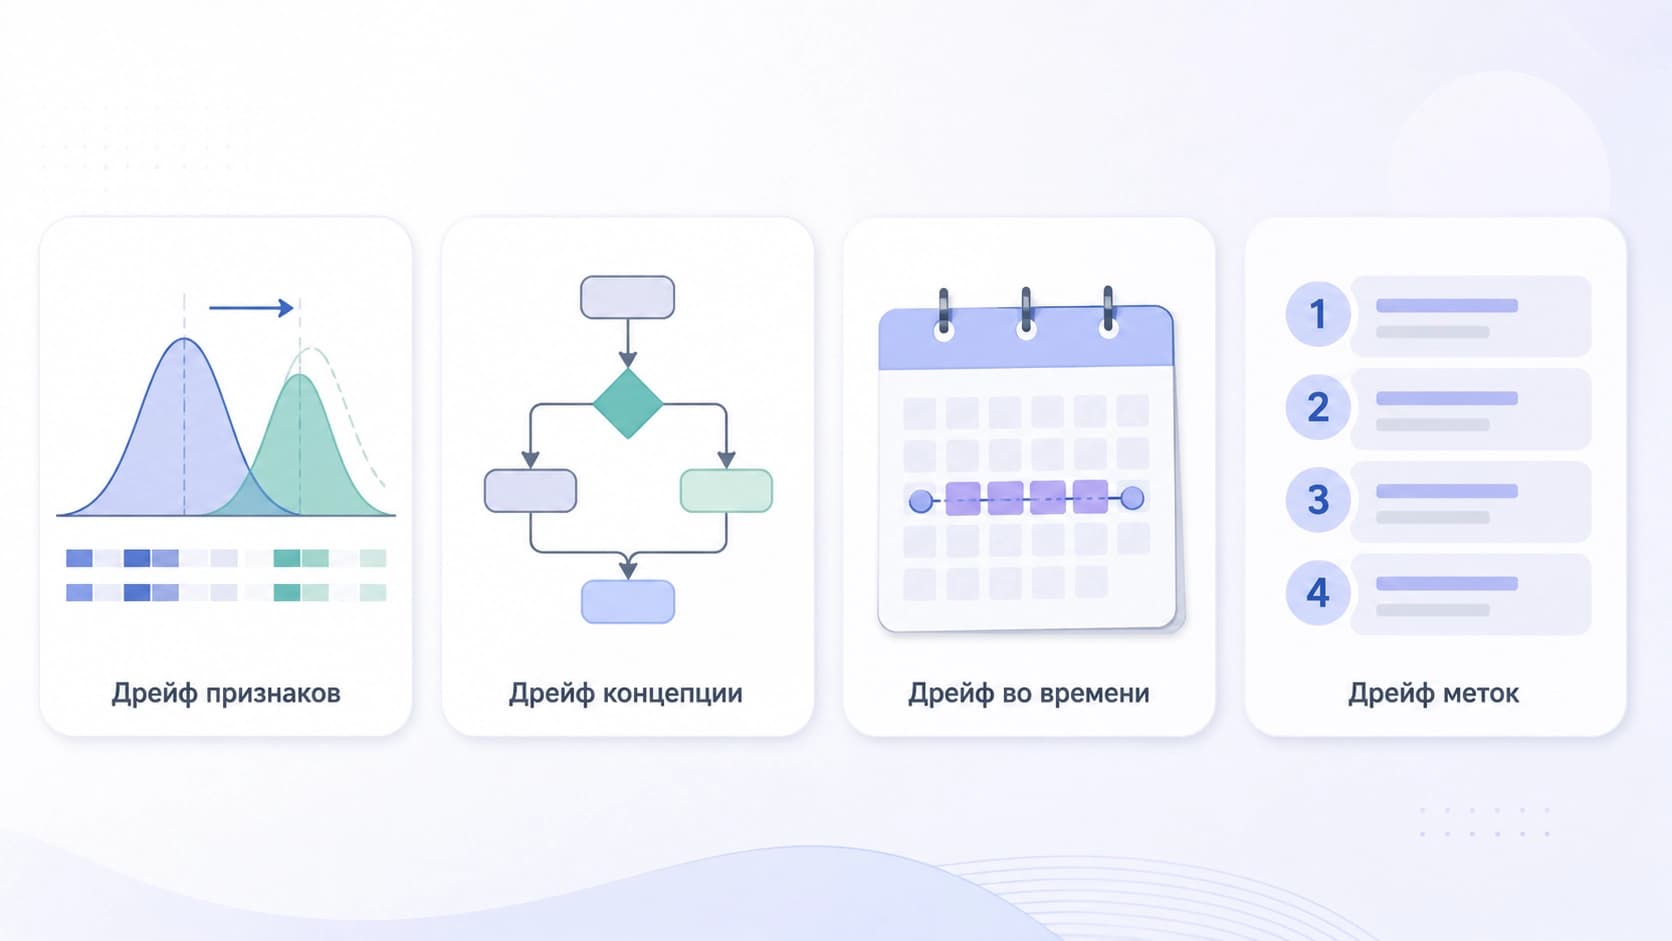
প্রতিটি রিপোজিটরি চারটি ডায়াগনস্টিক অক্ষে মূল্যায়ন করা হয়:
- সাংখ্যিক ড্রিফট — সহগ, মাত্রা, থ্রেশহোল্ড এবং অন্যান্য রাশির মান স্পেসিফিকেশনের সাথে মেলে না;
- পদ্ধতিগত ড্রিফট — প্রশিক্ষণ বা গণনার প্রক্রিয়াটি নিজেই গবেষণাপত্রে পরিকল্পিত থেকে ভিন্নভাবে গঠিত;
- প্রোটোকল ড্রিফট — পরীক্ষার স্কিম লঙ্ঘিত: নমুনা বিভাজন, তুলনার শর্ত, মূল্যায়নের নিয়ম;
- ক্রম ড্রিফট — ধাপগুলো ভুল ক্রমে সম্পাদিত, এবং এটি ফলাফল বদলে দেয়।
অক্ষগুলোর এই বিভাজন ব্যবহারিক সুবিধা দেয়: ডেভেলপার বিমূর্ত "গুণমান নিম্ন" নয়, বরং নির্দিষ্ট ধরনের ত্রুটি দেখতে পান।
ফলাফল: ০.৩০১ সর্বোচ্চ সীমা
লেখকেরা ১২টি জেনারেটর কনফিগারেশন চালিয়েছেন — চারটি মডেল তিনটি স্ক্যাফোল্ডের সাথে মিলিয়ে। প্রতিটি মূল্যায়ন এককের ভগ্নাংশে পরিমাপ করা হয়েছে।
সংখ্যাগুলো বাস্তববোধ ফিরিয়ে আনে। সেরা ফলাফল দেখিয়েছে Claude ও PaperCoder-এর সমন্বয় — গড়ে ১.০ সম্ভাব্যতার মধ্যে ০.৩০১ SAU-স্কোর। সব মিলিয়ে ৩৬০টি মূল্যায়নের সামগ্রিক গড় স্কোর — ০.২২১।
অন্য কথায়, এমনকি সবচেয়ে শক্তিশালী কনফিগারেশনও স্পেসিফিকেশনের যা দাবি করে তার এক-তৃতীয়াংশেরও কম সঠিকভাবে সম্পাদন করে। তবুও মডেলগুলো দাবিগুলো উপেক্ষা করে না: ব্যর্থতার শ্রেণিবিন্যাস দেখায় যে এজেন্টরা সাধারণত বেশিরভাগ পয়েন্ট পূরণের চেষ্টা করে, কিন্তু সেগুলো ভুলভাবে বাস্তবায়ন করে। শূন্য হয়ে যাওয়া দাবিগুলোর মূল ভর আসে দুটি পরিস্থিতি থেকে — বাস্তবায়ন ও পরিকল্পনার অসঙ্গতি (implementation mismatch) এবং স্টাব (stubs), অর্থাৎ যেখানে প্রকৃত লজিকের বদলে একটি ফাঁকা আনুষ্ঠানিকতা রেখে দেওয়া হয়েছে।
এই ধরনের ত্রুটির প্রোফাইল একটি গুরুত্বপূর্ণ বিষয় বলে: ব্যাপারটা এজেন্টের অলসতা নয়, বা নিবন্ধটি "শেষ পর্যন্ত পড়েনি" সেটাও নয়। ব্যাপারটা হলো, সে আত্মবিশ্বাসের সাথে একটি বিশ্বাসযোগ্য, কিন্তু ভুল সংস্করণ পুনরুৎপাদন করে।
চলনযোগ্যতা বৈজ্ঞানিক বিশ্বস্ততার সমান নয়
গবেষণাপত্রের একটি আলাদা সিদ্ধান্ত আধুনিক স্ক্যাফোল্ডগুলো কীভাবে গঠিত তা নিয়ে। যেগুলো চলনযোগ্যতার জন্য অপ্টিমাইজ করা — যাতে কোড শুধু চলে এবং ক্র্যাশ না করে — সেগুলো বৈজ্ঞানিক পুনরুৎপাদনের জন্য সীমিত লাভ দেয়। এটি যুক্তিসঙ্গত: সফলভাবে চালানো সিনট্যাক্স এবং নির্ভরশীলতার উপস্থিতি যাচাই করে, কিন্তু লজিক লেখকদের পরিকল্পনার সাথে মেলে কি না সে সম্পর্কে কিছুই বলে না।
এই ব্যবধান কমাতে ভিন্ন শ্রেণির স্ক্যাফোল্ড দরকার — যেগুলো সেমান্টিক স্পেসিফিকেশনের ভেরিফিকেশনকে সর্বোচ্চ গুরুত্ব দেয়। সহজ কথায়, এজেন্টের কেবল কোড লিখে চালানো নয়, বরং তার প্রতিটি ধাপ নিবন্ধের দাবির সাথে মিলিয়ে দেখা এবং মিলটি প্রমাণ করতে পারা দরকার।
বাস্তবে এটি কী বদলায়
SA-Bench মডেলদের প্রতিযোগিতা নয়, বরং একটি ডায়াগনস্টিক সরঞ্জাম। এর মূল্য হলো, এটি পুনরুৎপাদনযোগ্যতার আলোচনাকে "চলে / চলে না" এই সমতল থেকে "কতটা নির্ভুলভাবে মেলে" এই সমতলে নিয়ে আসে। বেঞ্চমার্ক, অ্যানোটেশন এবং মূল্যায়ন পাইপলাইন উন্মুক্তভাবে প্রকাশ করা হয়েছে, তাই এই পদ্ধতি নিজের কাজেও প্রয়োগ করা যায় — উদাহরণস্বরূপ, কেবল বৈজ্ঞানিক নিবন্ধ নয়, বরং কারিগরি স্পেসিফিকেশন অনুযায়ী কোড জেনারেশনের অভ্যন্তরীণ পাইপলাইন যাচাই করতে।
যারা এজেন্ট তৈরি করেন, তাদের জন্য সিদ্ধান্তটি হলো: ভেরিফিকেশনের আলাদা স্তর ছাড়া জেনারেটরের "বুদ্ধিমত্তা" বাড়ানো একটি সীমায় গিয়ে ঠেকে। সেমান্টিক ড্রিফট কোনো নির্দিষ্ট মডেলের বাগ নয়, বরং এমন একটি পদ্ধতির বৈশিষ্ট্য, যেখানে কেউ অর্থগত মিল যাচাই করে না। এবং যতক্ষণ এমন একটি স্তর না আসবে, ততক্ষণ research-কোড পুনরুৎপাদন এমন একটি কাজ থাকবে, যেখানে মানুষকে এখনও প্রতিটি লাইন পড়তে হয়।


