
স্থাপত্য কীভাবে কাজ করে
SymbolicLight V1 হলো দুটি পথবিশিষ্ট একটি ভাষা মডেল: বাইনারি Leaky Integrate-and-Fire (LIF) ডায়নামিক্স এবং অবিচ্ছিন্ন রেসিডুয়াল স্ট্রিম।
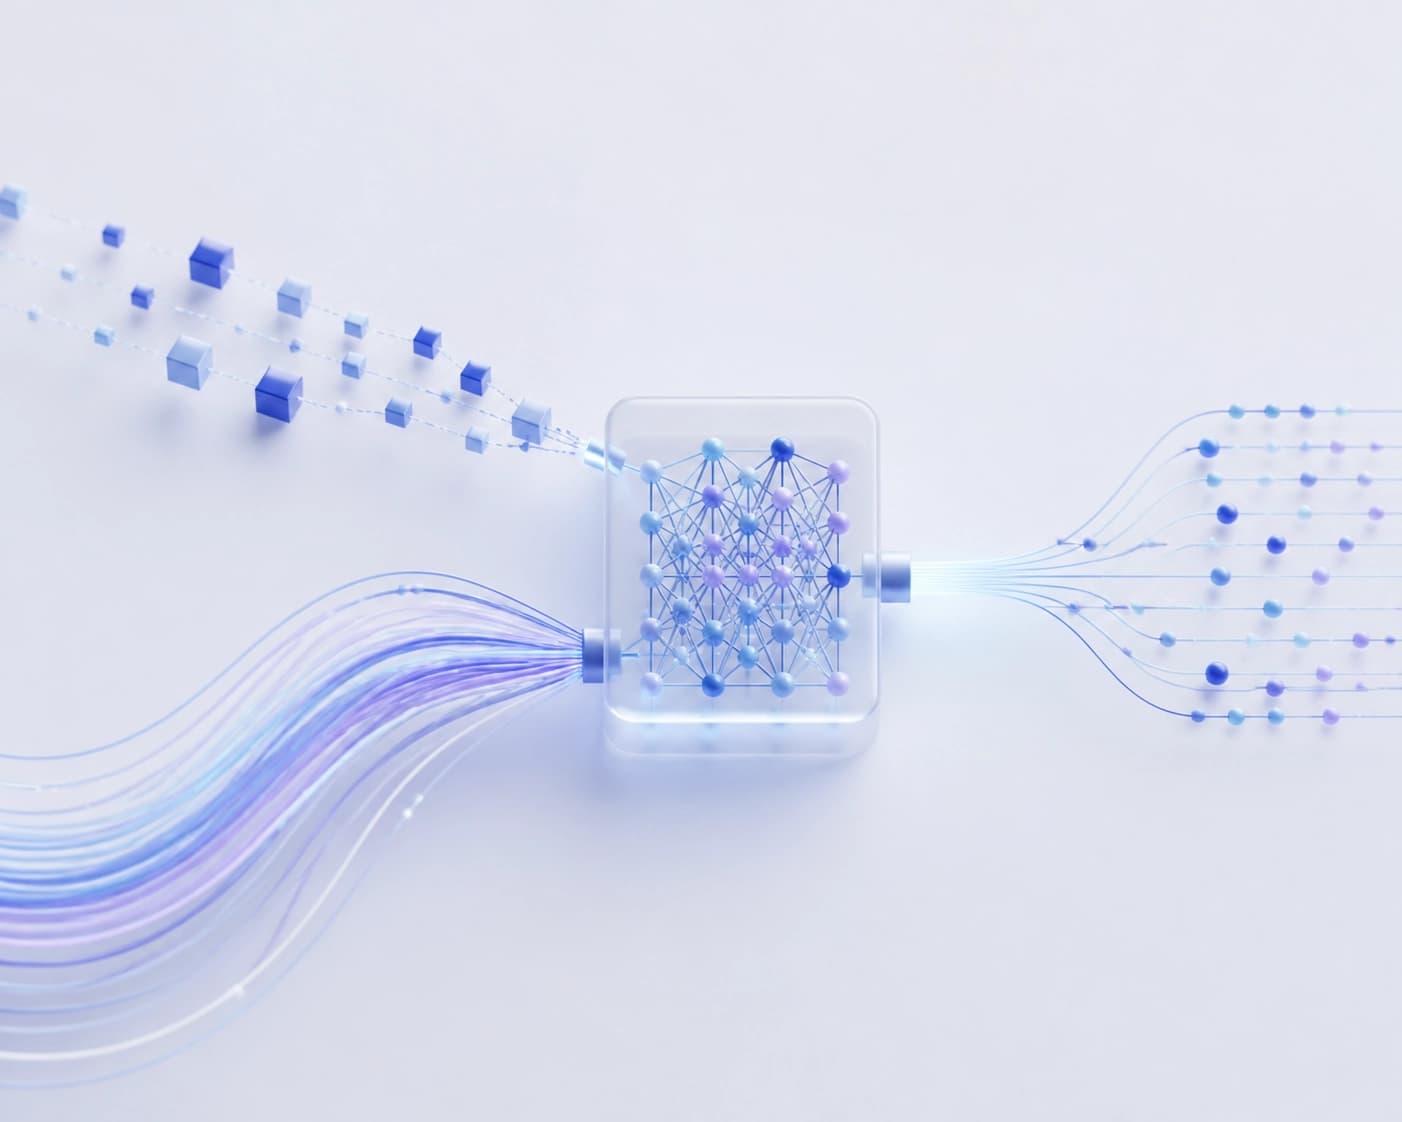
- Dual-Path SparseTCAM মিক্সার প্রথম-ক্রমের সূচকীয় ক্ষয়সহ অবস্থা এবং স্থানীয় উইন্ডো অ্যাটেনশনকে একত্র করে।
- উভয় উপাদানই অবিচ্ছিন্ন রেসিডুয়াল স্ট্রিমে কাজ করে।
- মিক্সারের পরে, মডেলটি প্রসঙ্গ-নির্ভর ডিকোডিং হেড ব্যবহার করে।
ব্যবহারিক মানদণ্ড: স্পার্স স্পাইক ডায়নামিক্স ও অবিচ্ছিন্ন স্ট্রিমের সমন্বয় নিয়ে অধ্যয়নের জন্য এই স্থাপত্যটি আকর্ষণীয়। তবে শুধু এটিই গতি বা নির্ভুলতায় শ্রেষ্ঠত্ব প্রমাণ করে না।
মডেলটিকে কোন ডেটায় প্রশিক্ষণ ও মূল্যায়ন করা হয়েছিল
SymbolicLight V1-এর চারটি মডেল একেবারে শুরু থেকে প্রশিক্ষণ দেওয়া হয়েছিল। প্রতিটিতে 194M প্যারামিটার রয়েছে।
- প্রশিক্ষণ করপাসে চীনা ও ইংরেজি ভাষার 3B টোকেন রয়েছে।
- করপাসটি 10টি ডোমেইন জুড়ে বিস্তৃত।
- একটি নির্দিষ্ট টোকেন-ওয়েটেড মূল্যায়ন সেটে PPL ছিল 8.88–8.93। গড় ছিল 8.904, নমুনার মানক বিচ্যুতি 0.019।
- মূল্যায়ন সেট ও প্রশিক্ষণ স্ট্রিমের মধ্যে বিভাজন যাচাই করা হয়নি।
মূল্যায়ন সেটের 43.7% হলো কোড টোকেন। দশটি ডোমেইনে PPL-এর অবিভাজিত গড় 29.38। এনকোডারের প্রশিক্ষণ পরীক্ষায় শূন্য স্পাইকের গড় অনুপাত ছিল 89.96%; এটি পুরো মডেলের স্পার্সনেসের পরিমাপ নয়।
ব্যবহারিক মানদণ্ড: PPL-এর ফলাফল মূল্যায়ন সেটের গঠন এবং যাচাই না-করা ডেটা বিভাজনের সঙ্গে মিলিয়ে দেখা উচিত। শূন্য স্পাইকের অনুপাত পুরো মডেলের ক্ষেত্রে প্রয়োগ করা যায় না।
GPT-2-এর সঙ্গে মডেলটির তুলনা কীভাবে করা হয়েছিল
একই করপাস, টোকেনাইজার, টোকেন বাজেট ও হার্ডওয়্যার ব্যবহার করে দেখা গেছে, SymbolicLight V1-এর টোকেন-ওয়েটেড গড় PPL GPT-2 201M-এর চেয়ে 7.7% বেশি ছিল।
| মানদণ্ড | ফলাফল |
|---|---|
| PPL | SymbolicLight: গড়ে 8.904; GPT-2 201M: 8.27 |
| Zero-shot | পাঁচটি বেঞ্চমার্কে 200M-স্কেলের দুটি মডেলের নির্ভুলতায় স্পষ্ট কোনো পার্থক্য দেখা যায়নি |
| 4-গ্রাম পুনরাবৃত্তি | temperature 0.7 এবং top-k 50-এ SymbolicLight কম পুনরাবৃত্তি তৈরি করে |
| এনট্রপি মড্যুলেশন | নিয়মটি পুনরাবৃত্তির ক্ষেত্রে মডেলগুলোর ক্রমকে উল্টে দেয় |
ব্যবহারিক মানদণ্ড: কোন সূচক মূল্যায়ন করা হচ্ছে, তার ওপর নির্বাচন নির্ভর করে। PPL-এ GPT-2 এগিয়ে ছিল, আর পুনরাবৃত্তির ফলাফল জেনারেশন নিয়মের ওপর নির্ভরশীল ছিল।
গতি ও বিদ্যুৎ খরচের পরিমাপে কী দেখা গেছে
RTX 2080 Ti-তে SymbolicLight V1 এবং GPT-2-এর জেনারেশনের গতি পরিমাপ করা হয়েছিল। জেনারেশনের পরে পাওয়ার রিডিং থেকে বিদ্যুৎ খরচের অনুমান করা হয়; জেনারেশনের সময় পাওয়ার ইন্টিগ্রেট করা হয়নি।
| মডেল | জেনারেশনের গতি | বিদ্যুৎ খরচের অনুমান |
|---|---|---|
| SymbolicLight V1 | 22.8 টোকেন/সে | আনুমানিক 2,848 মি.জুল/টোকেন |
| GPT-2 | 91.5 টোকেন/সে | আনুমানিক 905 মি.জুল/টোকেন |
এই পরিমাপে GPT-2 দ্রুততর জেনারেশন করেছে এবং এর বিদ্যুৎ খরচের অনুমানও কম ছিল। বিদ্যুৎ খরচের অনুমানগুলো জেনারেশনের সময় পাওয়ার ইন্টিগ্রেশনের ওপর ভিত্তি করে করা হয়নি।
ব্যবহারিক মানদণ্ড: গতি ও বিদ্যুৎ খরচের তুলনার জন্য কেবল RTX 2080 Ti-তে করা এই পরিমাপের ফলাফলই উপলভ্য।


