
জেনারেটিভ ইমেজ মডেলের ফাইন-টিউনিং: পছন্দ ও মূল্যায়ন-মানদণ্ডের যৌথ বিবেচনা
নিবন্ধে উন্মুক্ত ডোমেইনে text-to-image মডেলগুলোর পোস্ট-ট্রেনিংয়ের একটি পদ্ধতি বর্ণনা করা হয়েছে, যেখানে মানুষের পছন্দের সংকেতের পাশাপাশি প্রম্পটের সঙ্গে সামঞ্জস্য এবং কাঙ্ক্ষিত বৈশিষ্ট্য যাচাইয়ের জন্য রুব্রিকভিত্তিক পরীক্ষা যোগ করা হয়। ফলাফল থেকে বোঝা যায়, পুরস্কারের ওজনযুক্ত গড় প্রস্তাবিত পদ্ধতির তুলনায় খারাপ ফল দেয়, আর Arena-র স্ন্যাপশটে ফাইন-টিউন করা Flux2dev এবং Ideogram-4-এর Elo-তে উল্লেখযোগ্য বৃদ্ধি দেখা যায়।
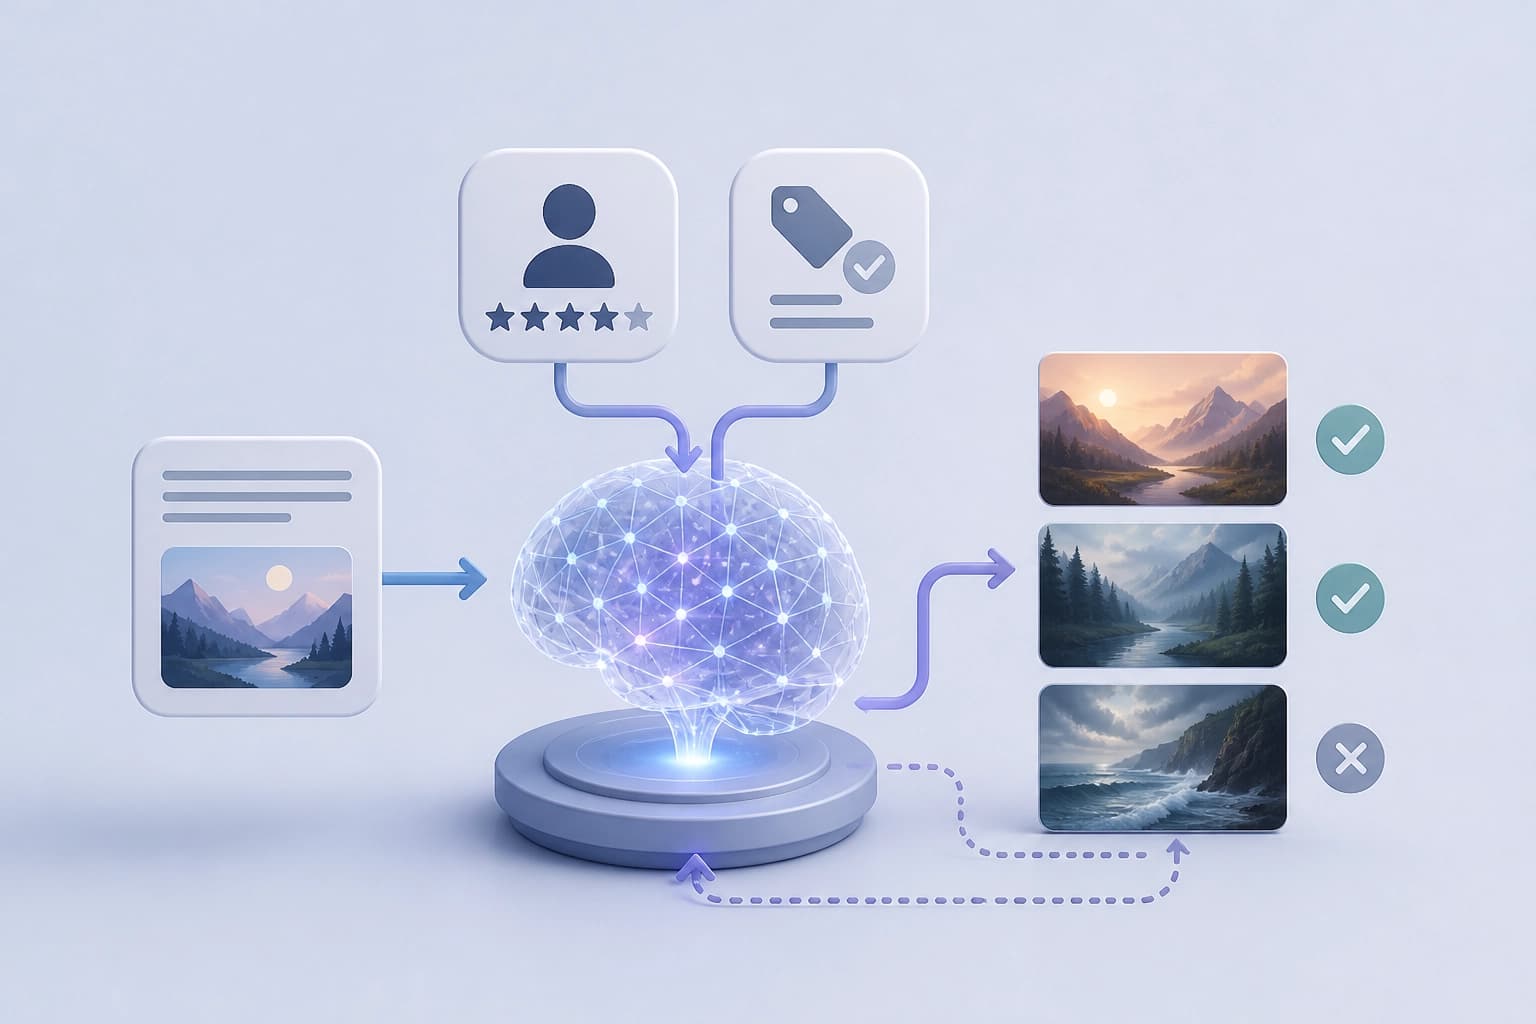
কাজ: ওপেন ডোমেইন এবং দুটি সংকেত
ওপেন ডোমেইনে টেক্সট থেকে ছবি তৈরি করতে হলে বিভিন্ন প্রয়োজন বিবেচনায় নিতে হয়। এর মধ্যে রয়েছে প্রম্পটের সঙ্গে সামঞ্জস্য এবং মানুষের পছন্দ। একটি পুরস্কার সংকেত দিয়ে এই দুই ধরনের প্রয়োজন পূরণ হয় না। «Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards» কাজটিতে পরিপূরক সংকেতের সমন্বয়ে পোস্ট-ট্রেনিংয়ের প্রস্তাব করা হয়েছে।
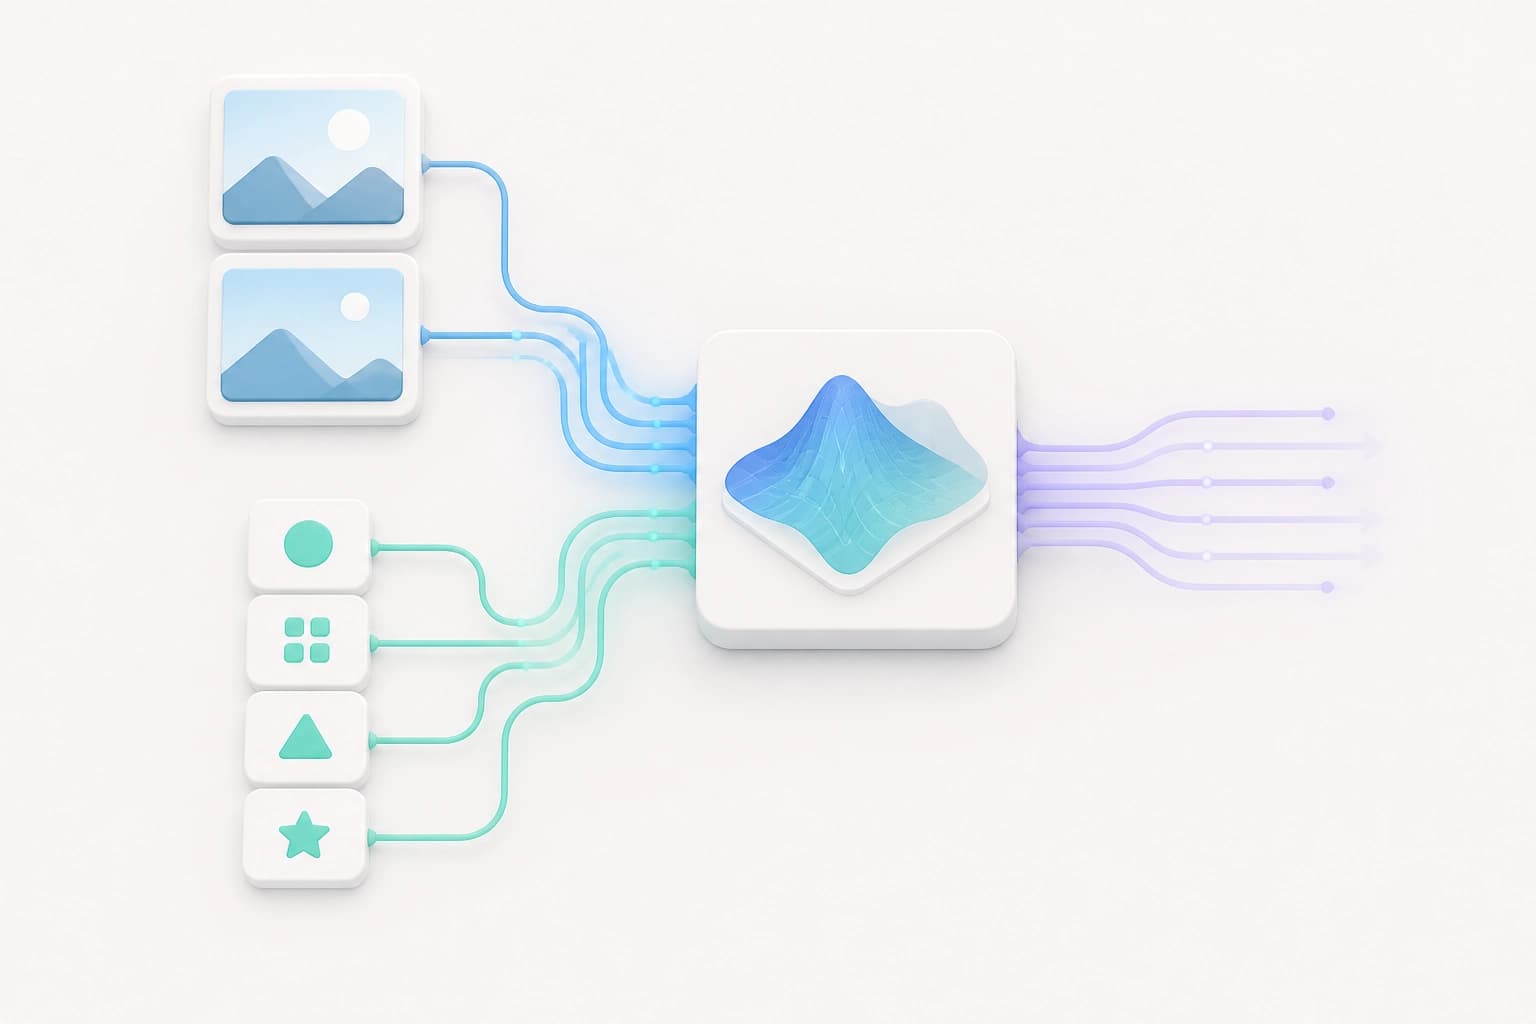
এই পদ্ধতিতে পছন্দভিত্তিক পুরস্কার এবং রুব্রিক-ভিত্তিক পুরস্কার একত্র করা হয়। প্রথম সংকেতটি মানুষের পছন্দ প্রতিফলিত করে। দ্বিতীয়টি প্রম্পটের সঙ্গে সামঞ্জস্য এবং অন্যান্য কাম্য বৈশিষ্ট্য যাচাই করে। এই সমন্বয় অনুরোধের বিভিন্ন দিক পূরণ করে। উপসংহার: ওপেন ডোমেইনের ক্ষেত্রে বাছাইয়ের মানদণ্ড হলো একটি নয়, বরং পরস্পরের পরিপূরক সংকেতের উপস্থিতি। এগুলোর বিষয়গত পছন্দ এবং কাজ সম্পাদন—দুটিই যাচাই করা উচিত।
পুরস্কার ব্যবস্থার গঠন
এই ব্যবস্থায় দুটি প্রধান উপাদান রয়েছে। পছন্দভিত্তিক পুরস্কারকে মানুষের পছন্দের বৃহৎ পরিসরের ডেটার ওপর প্রশিক্ষণ দেওয়া হয়। প্রশিক্ষণে Bradley-Terry objective ব্যবহার করা হয়। এই সংকেতটি মানুষের পছন্দ প্রতিফলিত করে।
রুব্রিকগুলো প্রম্পটের সঙ্গে সামঞ্জস্য এবং অন্যান্য কাম্য বৈশিষ্ট্য মূল্যায়ন করে। এগুলো reward hacking-এর বিরুদ্ধেও সুরক্ষা দেয়। উপাদানগুলো ভিন্ন ভিন্ন কাজ করে এবং পরস্পরের পরিপূরক।
| উপাদান | কোন কিছুর ওপর নির্ভর করে | কী যাচাই করে | ভূমিকা |
|---|---|---|---|
| পছন্দভিত্তিক পুরস্কার | মানুষের পছন্দের বৃহৎ পরিসরের ডেটা, Bradley-Terry objective | ফলাফলের তুলনা করার সময় মানুষের পছন্দ | পছন্দের অপ্টিমাইজেশন |
| রুব্রিক-ভিত্তিক পুরস্কার | মানদণ্ডসহ রুব্রিক | প্রম্পটের সঙ্গে সামঞ্জস্য এবং অন্যান্য কাম্য বৈশিষ্ট্য | reward hacking-এর বিরুদ্ধে সুরক্ষা |
লেখকেরা কার্যকর পুরস্কারের জন্য একটি শর্ত উল্লেখ করেছেন। এগুলোকে ব্যবহারকারীদের অভিপ্রায় ব্যাপকভাবে অন্তর্ভুক্ত করতে হবে। অপ্টিমাইজেশনের সময় এগুলোকে কাজে লাগিয়ে ফেলা যাবে না।
উপসংহার: বাছাইয়ের মানদণ্ড হলো, রুব্রিকগুলো যেন পছন্দের পরিপূরক হয়, পছন্দের বিকল্প না হয়। রুব্রিক ছাড়া ব্যবস্থা reward hacking-এর বিরুদ্ধে সুরক্ষা হারায়। পছন্দ ছাড়া ব্যবস্থা মানুষের পছন্দের ওপর নির্ভর করে না।
সাধারণ গড়ের বদলে সমন্বয়
লেখকেরা সরল weighted average-এর একটি সমস্যা তুলে ধরেছেন। অপ্টিমাইজেশনের সময় এই গড় ব্যবহার করলে আচরণ অনুকূল থাকে না। কাজটিতে পুরস্কার সমন্বয়ের একটি কৌশল প্রস্তাব করা হয়েছে। এটি পছন্দের অপ্টিমাইজেশন এবং রুব্রিক পূরণের মধ্যে আরও কার্যকরভাবে ভারসাম্য আনে।
| পদ্ধতি | অপ্টিমাইজেশনের সময় কী ঘটে |
|---|---|
| সরল weighted average | আচরণ অনুকূল থাকে না |
| সমন্বয় কৌশল | পছন্দের অপ্টিমাইজেশন এবং রুব্রিক পূরণের মধ্যে আরও কার্যকরভাবে ভারসাম্য আনা হয় |
সমন্বয় কৌশলটি পদ্ধতির একটি স্বতন্ত্র অংশ হয়ে ওঠে। উপসংহার: বাছাইয়ের মানদণ্ড হলো সমন্বয় কৌশলের উপস্থিতি, শুধু পুরস্কারের একটি সেট নয়। কৌশল ছাড়া সংকেতের ওজন নির্ধারণ করলেই কাঙ্ক্ষিত আচরণের নিশ্চয়তা মেলে না।
Arena text-to-image র্যাঙ্কিংয়ে ফলাফল
Arena text-to-image র্যাঙ্কিংয়ে Flux2dev মডেলটি বেস মডেলের চেয়ে 69 পয়েন্ট বেশি Elo পেয়েছে। মডেলটি RL-প্রশিক্ষণের মধ্য দিয়ে গেছে। পোস্ট-ট্রেনিংয়ের পর Ideogram-4 মডেলটি সব ওপেন-সোর্স মডেলকে ছাড়িয়ে গেছে। এর Elo ছিল 1223.5।
এই তথ্য র্যাঙ্কিংয়ের প্রেক্ষাপটে পোস্ট-ট্রেনিংয়ের প্রভাব দেখায়। এগুলো অন্য ব্যবহারের পরিস্থিতি বর্ণনা করে না।
| মডেল | ফলাফল | কিসের সঙ্গে তুলনা করা হয়েছে |
|---|---|---|
| RL-trained Flux2dev | Elo 69 পয়েন্ট বেশি | বেস মডেল |
| Post-trained Ideogram-4 | Elo 1223.5 | সব ওপেন-সোর্স মডেল |
উপসংহার: মূল্যায়নের মানদণ্ড হলো বেস মডেল এবং প্রশিক্ষণের শর্ত বিবেচনা করা। Flux2dev-এর ক্ষেত্রে লেখকেরা বেস মডেলের তুলনায় উন্নতির কথা জানিয়েছেন। Ideogram-4-এর ক্ষেত্রে তাঁরা ওপেন মডেলগুলোর মধ্যে এর অবস্থান উল্লেখ করেছেন।
র্যাঙ্কিংয়ের স্ন্যাপশট ও ডেটার সীমাবদ্ধতা
সর্বাধুনিক ফলাফলের দাবিগুলো 4 সেপ্টেম্বর 2026 তারিখের Arena স্ন্যাপশটের সঙ্গে সম্পর্কিত। স্ন্যাপশটটি ওই তারিখে র্যাঙ্কিংয়ের অবস্থা তুলে ধরে। লেখকেরা Arena-T2I-Training প্রকাশ করেছেন। এটি 1K আকারের প্রশিক্ষণ ডেটার একটি উপসেট।
এটি পূর্ণ প্রশিক্ষণের কিছু উন্নতি পুনরুৎপাদন করতে সাহায্য করে। কিছু উন্নতি এই উপসেটের বাইরে থেকে যায়। পদ্ধতিটি যাচাই করতে পূর্ণ ফলাফল এবং পুনরুৎপাদনযোগ্য অংশকে আলাদা করে দেখা গুরুত্বপূর্ণ।
উপসংহার: বাছাইয়ের মানদণ্ড হলো স্ন্যাপশটের তারিখ এবং পুনরুৎপাদনযোগ্যতার সীমা বিবেচনা করা। এই সীমারেখা ছাড়া কোনো দাবি অসম্পূর্ণ থেকে যায়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
Zero2Repo বেঞ্চমার্ক: খালি ডিরেক্টরি থেকে স্বয়ংক্রিয়ভাবে প্রকল্প তৈরির সীমা
গবেষণায় কোডিং এজেন্টদের সম্পূর্ণ রিপোজিটরি বিল্ডে মূল্যায়নের প্রস্তাব করা হয়েছে: ইনপুট হবে একটি স্পেসিফিকেশন, ইন্টারফেস চুক্তি এবং খালি পরিবেশ; যাচাই হবে LLM বিচারক ছাড়া গোপন পরীক্ষার মাধ্যমে। শীর্ষস্থানীয় এজেন্টরাও খুব কম ক্ষেত্রেই সব পরীক্ষায় উত্তীর্ণ হয়, আর ব্যর্থতার বেশিরভাগই প্রয়োজনীয়তার কিছু নির্দিষ্ট বিষয় বাদ পড়ার কারণে ঘটে।
13 নভেম্বর 2026
FedSocket: মাল্টিমোডাল বৈচিত্র্যের ক্ষেত্রে প্রাপকের কাছে বাধ্যতামূলকভাবে কার্যকরযোগ্য বিনিময়যোগ্য মডেল
FedSocket প্রস্তাব করা হয়েছে—এমন একটি পদ্ধতি, যেখানে বিনিময় করা মডেলটি প্রাপকের পক্ষেও গণনাযোগ্য হতে হবে এবং বিভিন্ন ধরনের ব্যক্তিগত মডেলকে পূর্বাভাসের একটি অভিন্ন ইন্টারফেস Q সংযুক্ত করে। নিবন্ধে সদস্যপদ-সচেতন অ্যাগ্রিগেশন, কাউন্টারসহ শুধু Q-এর প্যারামিটার ফরওয়ার্ড করা এবং ছয়টি ডেটাসেটে পরীক্ষা-নিরীক্ষার বর্ণনা রয়েছে; এসব পরীক্ষায় অনুপস্থিত মডালিটির ক্ষেত্রে নির্ভুলতা বৃদ্ধি এবং স্বাধীন এনসেম্বলের তুলনায় Joint ইনফারেন্সের শ্রেষ্ঠত্ব দেখানো হয়েছে।
13 নভেম্বর 2026
CyberArena: AI এজেন্টদের মুখোমুখি ম্যাচ স্থির সাইবার বেঞ্চমার্কের সীমাবদ্ধতা উন্মোচন করে
বেঞ্চমার্কটি দুই এজেন্টকে ক্রমাগত পরিবর্তনশীল পরিষেবাসহ স্যান্ডবক্সে রাখে এবং কয়েক দফা শেষে তাদের কার্যকলাপকে আক্রমণাত্মক ও প্রতিরক্ষামূলক দক্ষতার বহুমাত্রিক স্কোরে রূপ দেয়। ১২টি আধুনিক মডেলের সঙ্গে ৪৬৬টি ম্যাচে এটি এমন সক্ষমতার পার্থক্য শনাক্ত করেছে, যেখানে একমুখী পরীক্ষাগুলো সর্বোচ্চ সীমায় পৌঁছে যায়—এর মধ্যে রয়েছে কয়েক ধাপ এগিয়ে পরিকল্পনা করা এবং ব্যাকডোর তৈরি করা।
13 নভেম্বর 2026