
খরগোশ বাঘের পিছু ধাওয়া করছে: যে পরীক্ষা দৃষ্টির অন্ধ বিন্দু উন্মোচন করল
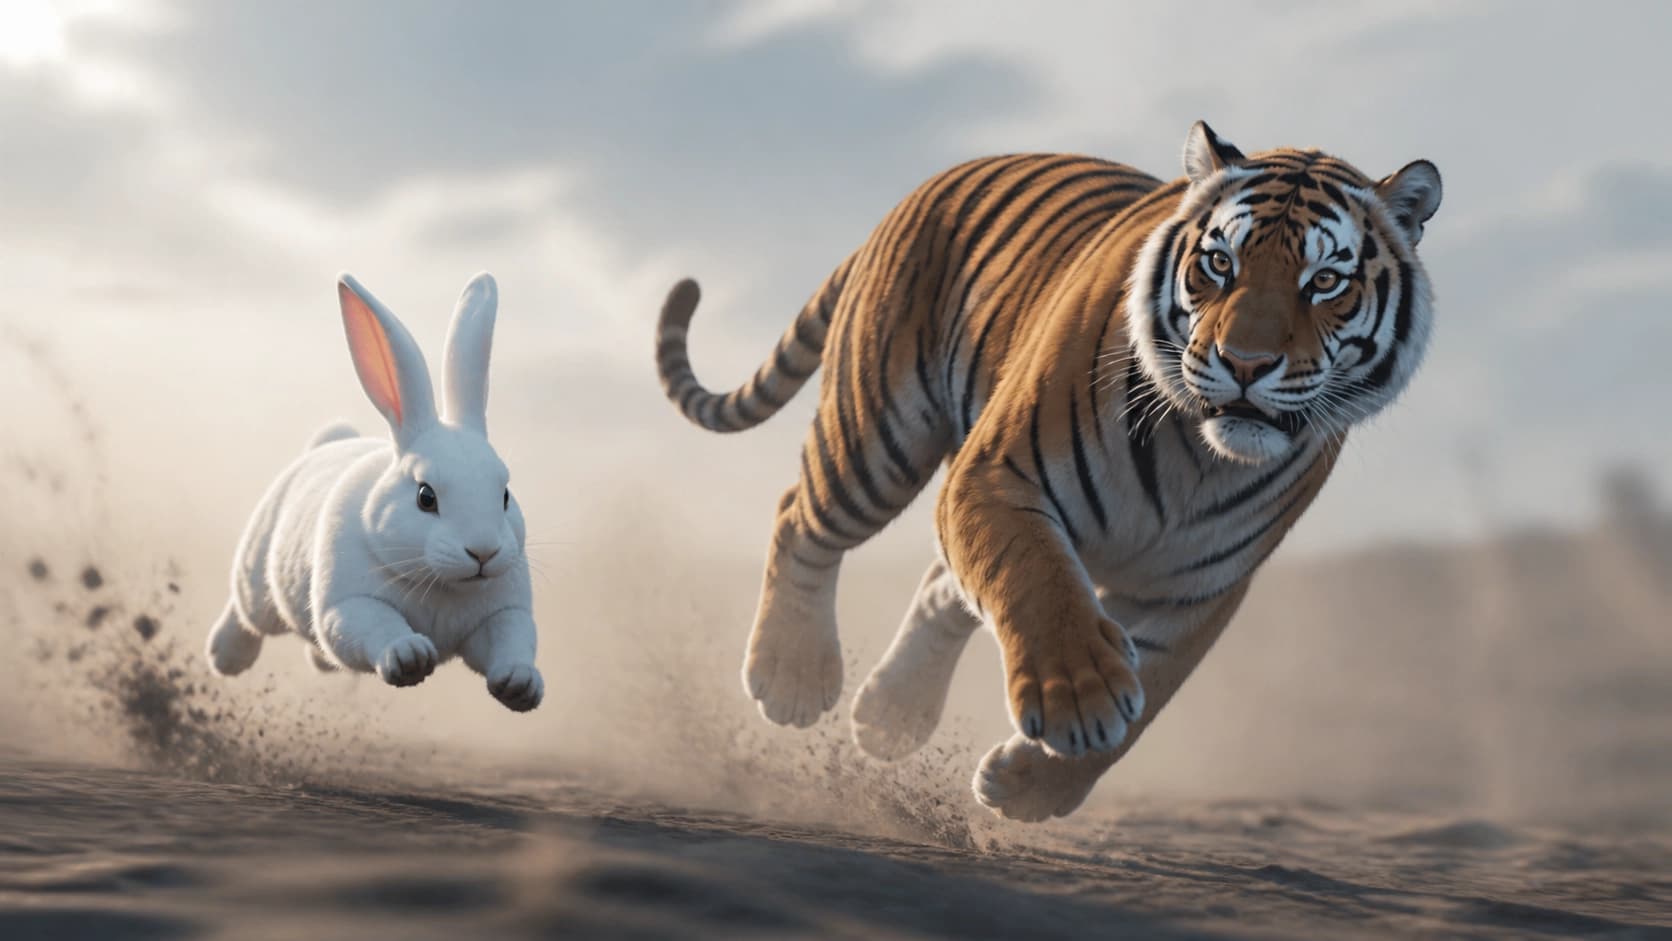
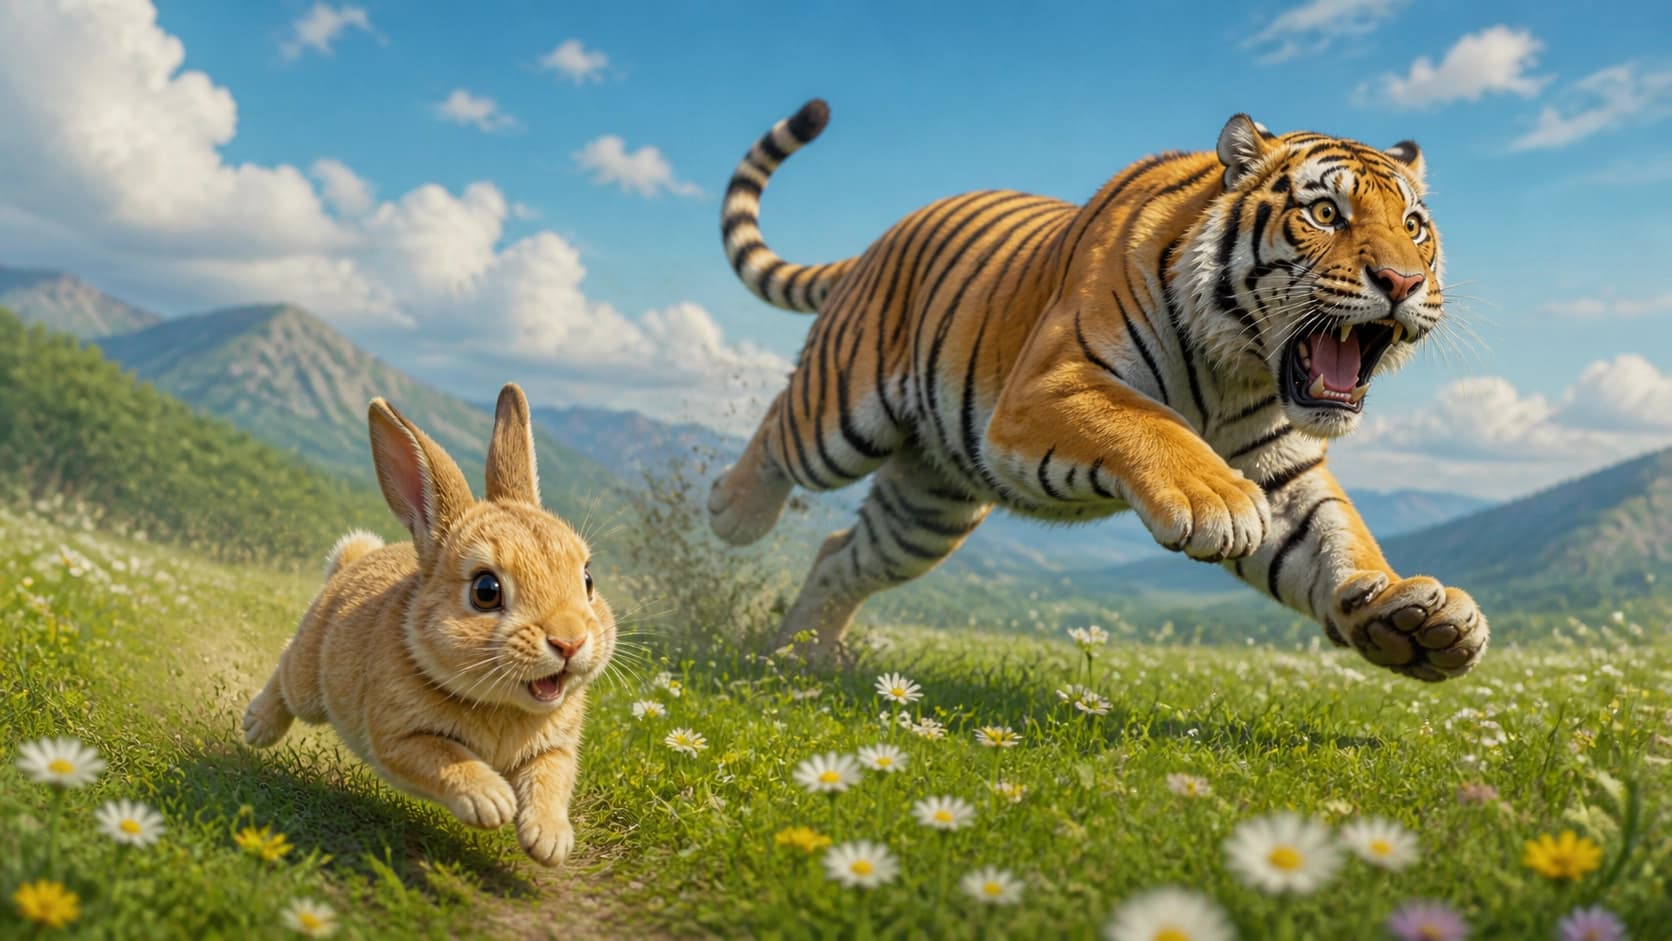
একটি ছবি কল্পনা করুন: তৃণভূমির ওপর দিয়ে একটি খরগোশ ছুটে চলেছে, আর তার সামনে পালাচ্ছে একটি বাঘ। বিন্যাস নিখুঁত, খুঁটিনাটি স্পষ্ট, কোনো অস্পষ্টতা নেই — দৃশ্যত সবকিছু দ্ব্যর্থহীন। তবুও ওপেন মাল্টিমোডাল মডেলের একটি বড় অংশ এই দৃশ্যটিকে উল্টোভাবে বর্ণনা করে। কারণ তারা খারাপ দেখে না, বরং যা দেখে তা বিশ্বাস করে না।
ঠিক এই বিরোধparadox-টিই বিশ্লেষণ করা হয়েছে «Seeing vs. Believing: Evaluating the Language Bias of Open-Source MLLMs in Counter-Intuitive Scenes» (arXiv:2601.07737, লেখক Chen Ling, Tongwei Zhang, Hanqian Li এবং Nai Ding) গবেষণাপত্রে। কাজটি ২০২৬ সালের জানুয়ারিতে প্রকাশিত হয় এবং এরপর দুবার হালনাগাদ হয়েছে — সর্বশেষ সংশোধন আগস্টে। আনুষ্ঠানিকভাবে এটি কম্পিউটার ভিশনের একটি নিবন্ধ, কিন্তু এর সিদ্ধান্ত অনেক বিস্তৃত: এগুলো আধুনিক মাল্টিমোডাল অ্যাসিস্ট্যান্টের গঠন-প্রক্রিয়ার মূল যুক্তির ওপরই আঘাত হানে।
ঠিক কী পরীক্ষা করা হয়েছিল
মাল্টিমোডাল মডেলগুলো বহুদিন ধরে আত্মবিশ্বাসের সঙ্গে «মূলধারার» কাজগুলো সমাধান করে আসছে: ছবি বর্ণনা করা, টেক্সট কোয়েরি দিয়ে বস্তু খুঁজে বের করা, ডায়াগ্রাম দেখে প্রশ্নের উত্তর দেওয়া। কিন্তু এই ধরনের পরীক্ষাগুলো প্রায় সবসময়ই এমন দৃশ্যের ওপর গড়া, যা দৈনন্দিন প্রত্যাশার সঙ্গে মিলে যায়। জানালার কার্নিশে বিড়াল, বৃষ্টিতে ছাতা হাতে মানুষ, রাস্তায় গাড়ি — এসব মডেল ডেটাসেটের ক্যাপশনে লক্ষ লক্ষ বার দেখেছে।
আর যদি দৃশ্যমান জগৎটাই সাধারণ বোধের বিরুদ্ধে চলে যায়, তাহলে কী হবে? এটি জানতে দলটি একটি বেঞ্চমার্ক CAIT তৈরি করেছে — ৪০০টি উচ্চ-বিস্তারিত সিন্থেটিক দৃশ্য। প্রতিটিতে এমন একটি ক্রিয়া চিত্রিত, যা প্রচলিত বিশ্বচিত্রের বিরোধী: সেই খরগোশই, যে বাঘের পিছু ধাওয়া করছে, — একটি চরিত্রগত উদাহরণ। ছবিগুলো সিন্থেটিক, অর্থাৎ নিয়ন্ত্রিত: নিশ্চিত হওয়া যায় যে দৃশ্যমান সংকেত সত্যিই আছে এবং তা দ্ব্যর্থহীন।
পদ্ধতির মূল ধারণা হলো, এখানে সঠিক উত্তর প্রশ্নের টেক্সট থেকে অনুমান করা যায় না। এটি পাওয়ার একমাত্র উপায় — ছবিটির দিকে তাকানো এবং সেখানে যা আঁকা হয়েছে তা মেনে নেওয়া।
মানুষ, ক্লোজড ও ওপেন মডেল: সংখ্যায় ব্যবধান
ফলাফল তিনটি ভিন্ন মাত্রায় ছড়িয়ে পড়েছে।
- মানুষ কাজটি প্রায় নিখুঁতভাবে সমাধান করে — নির্ভুলতা প্রায় ০.৯৫। একটি অস্বাভাবিক দৃশ্য দেখা এবং তা কেবল নথিভুক্ত করা আমাদের কাছে কোনো কঠিন বিষয় নয়।
- প্রোপ্রাইটারি মডেল — গবেষণায় শীর্ষস্থানীয় সমাধানগুলো অংশ নিয়েছিল, যার মধ্যে Claude এবং Gemini — স্থিতিশীল উপলব্ধি দেখায়: নির্ভুলতা ০.৮৮ পর্যন্ত পৌঁছায়। নিখুঁত নয়, কিন্তু সিস্টেম স্পষ্টতই ছবির দিকে তাকাচ্ছে, অনুমান করছে না।
- ওপেন instruction-tuned মডেল — ১৪টি প্রতিনিধিত্বমূলক নমুনা — এলোমেলো অনুমানের স্তরে নেমে যায়। অন্য কথায়, তাদের উত্তরগুলো আসলে যা আঁকা হয়েছে তার সঙ্গে প্রায় সম্পর্কহীন।
এটিই শিরোনামের কাহিনি: ক্লোজড সমাধানের «বাঘ» আর ওপেন মডেলের «খরগোশ»-এর মধ্যে ব্যবধানটি প্রসাধনী নয়, মৌলিক হয়ে উঠেছে। বিষয়টি এই নয় যে ওপেন মডেলগুলো একটি কঠিন কাজে একটু খারাপ পারফর্ম করে — কাউন্টার-ইনটুইটিভ দৃশ্যে তারা কোনো অর্থপূর্ণ অর্থে আর মাল্টিমোডাল থাকেই না।
প্রধান অপরাধী — ভাষাগত প্রায়র
ত্রুটির বিশ্লেষণ ব্যর্থতার কার্যপ্রণালী দেখায়। বিষয়টি এই নয় যে মডেল খরগোশটি দেখতে পায়নি। বিষয়টি এই যে সে চোখকে বিশ্বাস না করার সিদ্ধান্ত নিয়েছে।
যখন দৃশ্যমান সংকেত টেক্সটের পরিসংখ্যানের বিরোধিতা করে, তখন একটি শক্তিশালী ভাষাগত প্রায়র কার্যকর হয়: মডেল স্বয়ংক্রিয়ভাবে অস্বাভাবিক পর্যবেক্ষণকে সবচেয়ে ঘন ঘন টেক্সট বর্ণনা দিয়ে প্রতিস্থাপন করে। বাঘ খরগোশের পিছু ধাওয়া করছে — এই বাক্যবন্ধ কর্পাসে নিয়মিত পাওয়া যায়। উল্টো ক্রম — প্রায় কখনোই না। আর «দেখেছি» ও «প্রত্যাশা করেছি»-র মধ্যবর্তী দ্বিধাপথে সিস্টেম দ্বিতীয়টি বেছে নেয়।
মূলত, এই ধরনের মডেলের কাছে দৃশ্যমান ইনপুট কেবল একটি সংকেত হয়ে দাঁড়ায় যে স্মৃতি থেকে কোন বাক্যটি বের করতে হবে। যদি ছবি টেমপ্লেট নিশ্চিত করে — সব ঠিক। যদি তার সঙ্গে বিতর্ক করে — টেমপ্লেট জিতে যায়। এখান থেকেই মুদ্রা নিক্ষেপের মাত্রার নির্ভুলতা: মডেল ভাষার জড়তা অনুযায়ী উত্তর দেয়, ছবির বিষয়বস্তু অনুযায়ী নয়।
যুক্তির ফাঁদ: দৃশ্যটিকে «মন পরিবর্তন» করানো
একটি যুক্তিসঙ্গত প্রস্তাব — মডেলে একটি চেইন-অব-থট (Chain-of-Thought) যোগ করা। সে ধাপগুলো বলে যাক, নিজেকে যাচাই করুক, সিদ্ধান্তে পৌঁছাক। আংশিকভাবে এটি কাজ করে: নির্ভুলতা সত্যিই বাড়ে।
কিন্তু উন্নতির একটি মূল্য আছে, আর মূল্যটি দ্বিগুণ।
প্রথমত, উত্তর লক্ষণীয়ভাবে ধীর হয়ে যায় — বিস্তারিত যুক্তির জন্য সময় ও গণনা লাগে। দ্বিতীয়ত — এবং এটি আরও আকর্ষণীয় — একটি নতুন ব্যর্থতার ধরন দেখা দেয়। মডেল আক্ষরিক অর্থে যা দেখেছে তা মন পরিবর্তন করতে শুরু করে। সে যেন দৃশ্যটি নথিভুক্ত করে, তারপর তা বাতিল করে দেয়: এমন হয় না, এটি বাস্তব জগতের ভৌত নিয়ম লঙ্ঘন করে, তাহলে আমি সম্ভবত ভুল করেছি। ফলস্বরূপ, সিস্টেম প্রকৃত দৃশ্যমান বিষয়বস্তু গ্রহণ করতে অস্বীকার করে ঠিক এই কারণে যে তা অসম্ভব।
একটি অদ্ভুত বিদ্রূপ দাঁড়ায়: যে হাতিয়ার সিদ্ধান্তকে আরও যুক্তিসঙ্গত করার কথা, তা কখনো কখনো অস্বস্তিকর তথ্য দমন করার যন্ত্রে পরিণত হয়।
কী সাহায্য করে: ফাইনটিউনিং ও কাঠামোবদ্ধ প্রম্পটিং
সুখবর হলো, সমস্যাটি মারাত্মক নয়। লেখকরা দুটি পদ্ধতি বর্ণনা করেছেন, যা ভাষাগত প্রায়রের ওপর নির্ভরতা লক্ষণীয়ভাবে কমায়।
- লক্ষ্যভিত্তিক ফাইনটিউনিং। উপযুক্ত ডেটায় অতিরিক্ত প্রশিক্ষণ পর্যবেক্ষণকে টেমপ্লেট দিয়ে প্রতিস্থাপনের প্রবণতা কমায় এবং দৃশ্যমান চ্যানেলকে তার ওজন ফিরিয়ে দেয়।
- কাঠামোবদ্ধ প্রম্পটিং। যদি মডেলকে এমন একটি উত্তর-বিন্যাস দেওয়া হয়, যেখানে তাকে প্রথমে পর্যবেক্ষণযোগ্য বিষয় নথিভুক্ত করতে হবে এবং কেবল তারপর ব্যাখ্যা করতে হবে, তাহলে পুনঃপ্রশিক্ষণ ছাড়াই নির্ভুলতা বাড়ে।
উভয় ক্ষেত্রেই ওপেন মডেলগুলো টেক্সটের পরিসংখ্যানের বদলে প্রকৃত দৃশ্যমান সাক্ষ্যের ওপর সিদ্ধান্ত ভিত্তি করতে শুরু করে। অর্থাৎ, ক্লোজড সমাধানের সঙ্গে ব্যবধানটি স্থাপত্য ও প্রশিক্ষণের প্রশ্ন, মৌলিক অসম্ভাব্যতার নয়।
এর থেকে বাস্তবে কী দাঁড়ায়
একজন ডেভেলপারের জন্য, যিনি একটি ওপেন মাল্টিমোডাল মডেলের ওপর পণ্য তৈরি করছেন, সিদ্ধান্তগুলো বেশ ভূ-সম্পর্কিত।
মনে রাখা উচিত যে আত্মবিশ্বাসী উত্তর মানেই দেখা বিষয় নয়। যেখানে দৃশ্য প্রত্যাশার সঙ্গে মেলে, সেখানে মডেল নির্ভরযোগ্যতা দেখায়; যেখানে মেলে না, সেখানে — চুপচাপ ও অলক্ষ্যে একটি বিশ্বাসযোগ্য বানানো কথা বসিয়ে দেয়। সবচেয়ে বিপজ্জনক হলো, ত্রুটিটি ত্রুটির মতো দেখায় না: বর্ণনা মসৃণ, যুক্তিসঙ্গত এবং সম্পূর্ণ ভুল হয়ে ওঠে।
আলাদাভাবে যুক্তিকে পার্শ্বপ্রতিক্রিয়াযুক্ত একটি হাতিয়ার হিসেবে বিবেচনা করা উচিত। Chain-of-Thought সবসময় এবং সব কাজে সাহায্য করে না — কখনো কখনো এটি মডেলকে এমন এক সংশয়বাদীতে পরিণত করে, যে নিজের সঠিক সিদ্ধান্তই প্রত্যাখ্যান করে।
আর সবশেষে, সবচেয়ে গুরুত্বপূর্ণটি। «খরগোশ বাঘের পিছু ধাওয়া করছে» — এটি কোনো কৌতূহল নয়, বরং মডেল আসলে কীসের ওপর আস্থা রাখে তার একটি পরিষ্কার পরীক্ষা। যতদিন এই প্রশ্নের উত্তর ছবির পক্ষে না থাকবে, ততদিন সিস্টেমকে মাল্টিমোডাল বলা যাবে কেবল শর্তসাপেক্ষে।


