
Playco: GPT-6 Astra গেম প্রোটোটাইপের ম্যানুয়াল পরিমার্জন অর্ধেক কমিয়ে এনেছে
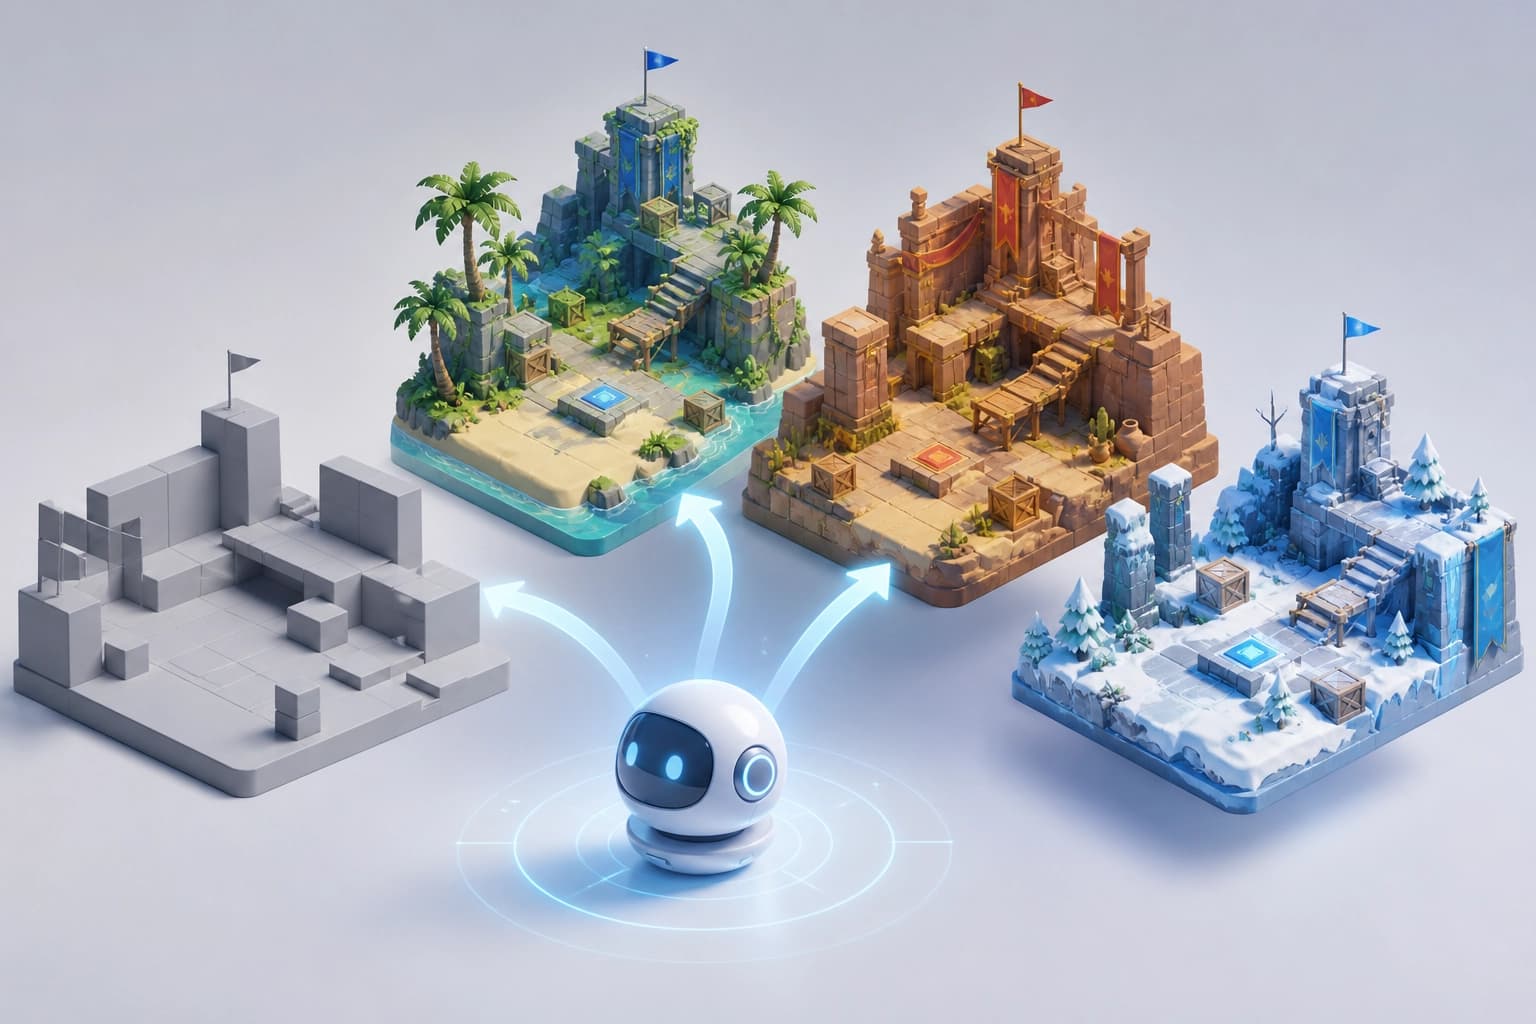
একটি ধূসর লেআউট থেকে তিনটি থিমেটিক সংস্করণ তৈরি করা হয়েছিল, এবং তাদের বেশিরভাগই প্রথম চেষ্টাতেই কাজ করেছে। পূর্ববর্তী মডেলের তুলনায় ম্যানুয়াল সংশোধনের সংখ্যা ৫০% কমেছে, পাশাপাশি স্থানিক যুক্তি, Unity-তে UI-এর রেসপন্সিভনেস এবং গেমের অনুভূতি উন্নত হয়েছে।
ফলাফল: কম ম্যানুয়াল সংশোধন, বেশি প্রোটোটাইপ
Playco গেম প্রোটোটাইপিংয়ে ম্যানুয়াল সংশোধন ৫০% কমিয়েছে। কোম্পানিটি GPT-6 Astra ব্যবহার করেছে। আগের মডেলের সাথে, দলটি ম্যানুয়াল সংশোধনে বেশি সময় ব্যয় করত। নতুন ফলাফল — একটি ধূসর বেস থেকে তিনটি থিম্যাটিক প্রোটোটাইপ।
মূল সূচক:
- আগের মডেলের তুলনায় ৫০% কম ম্যানুয়াল সংশোধন।
- একটি grey box থেকে ৩টি থিম্যাটিক গেম প্রোটোটাইপ।
- বেশিরভাগ প্রোটোটাইপ প্রথম প্রচেষ্টাতেই কাজ করেছে।
- একটি সাইবারপাঙ্ক ভ্যারিয়েন্টে পারফরম্যান্স সংশোধন প্রয়োজন হয়েছিল।
ব্যবহারিক মানদণ্ড: ম্যানুয়াল সংশোধনের অনুপাত এবং একটি সাধারণ বেস থেকে পাওয়া খেলার যোগ্য ভ্যারিয়েন্টের সংখ্যা দেখুন। এই দুটি সূচক সরাসরি বলে দেয় মডেলটি প্রোটোটাইপিং কতটা ত্বরান্বিত করে।
একটি grey box থেকে তিনটি গেম জগৎ
প্রক্রিয়াটি শুরু হয় একটি grey box দিয়ে — সাধারণ প্রিমিটিভ দিয়ে তৈরি অপরিশোধিত প্রোটোটাইপ। Playco দল গেমপ্লে এবং সৃজনশীল বিবরণে কয়েকটি পুনরাবৃত্তি করেছে। তারপর সাধারণ বেস থেকে তিনটি থিম্যাটিক প্রোটোটাইপ তৈরি করেছে। GPT-6 Astra এক পাসেই তিনটি তৈরি করেছে।
পর্যায়:
- সাধারণ প্রিমিটিভ দিয়ে একটি grey box তৈরি করুন।
- গেমপ্লে এবং বিবরণে পুনরাবৃত্তি করুন।
- সাধারণ বেস থেকে তিনটি থিম্যাটিক প্রোটোটাইপ তৈরি করুন।
- যাচাই করুন যে বেশিরভাগ প্রথম প্রচেষ্টাতেই কাজ করে।
- সাইবারপাঙ্ক সংস্করণে পারফরম্যান্স সংশোধন করুন।
সিদ্ধান্ত: একটি বেস একাধিক খেলার যোগ্য ভ্যারিয়েন্ট দেয়। দলটি প্রতিটি প্রোটোটাইপ শূন্য থেকে পুনর্নির্মাণ না করেই আরও বেশি ধারণা তুলনা করতে পারে। টুল নির্বাচনের মানদণ্ড — একটি সাধারণ ভিত্তি ধরে রাখার এবং তা থেকে বিভিন্ন থিম তৈরি করার ক্ষমতা।
কেন শুধু কোড লেখা মডেলের জন্য যথেষ্ট নয়
গেম ডেভেলপমেন্টে মডেলকে স্থান, ভিজ্যুয়াল রেফারেন্স, অভিযোজিত ইন্টারফেস এবং game feel নিয়ে চিন্তা করতে হবে। এটাও বোঝা গুরুত্বপূর্ণ যে গেম খেলার সময় পরিবর্তনটি কাজ করে কিনা। Playbot মডেলকে ইঞ্জিনে তৈরি করতে, পরীক্ষা চালাতে, বাগ খুঁজে বের করতে এবং তৈরি করা জিনিস উন্নত করতে দেয়।
আগের মডেল এবং GPT-6 Astra এর তুলনা:
| মানদণ্ড | আগের মডেল | GPT-6 Astra |
|---|---|---|
| ম্যানুয়াল সংশোধন | ইঞ্জিনিয়াররা গেম ম্যানুয়ালি সংশোধন করত | ৫০% কম |
| Grey box | কম পরিশীলিত | প্রথম প্রোটোটাইপই ইতিমধ্যে শক্তিশালী |
| স্থানিক চিন্তা | — | উন্নত হয়েছে |
| রেফারেন্স পুনরুৎপাদন | — | উন্নত হয়েছে |
| Unity-তে অভিযোজিত UI | — | উন্নত হয়েছে |
| Game feel | — | উন্নত হয়েছে |
| বাগ খোঁজা | — | সহজে খুঁজে পেত |
ব্যবহারিক মানদণ্ড: মডেলকে শুধু কোড প্রস্তাব করাই নয়, ইঞ্জিনে ফলাফল যাচাইও করতে হবে। স্থানিক চিন্তা, রেফারেন্স, UI এবং game feel-এ উন্নতিগুলো দেখায় ঠিক কোথায় উপযোগিতা বাড়ছে।
পরিবর্তন যাচাইয়ের পরিবেশ হিসেবে Playbot
Playco পেশাদার গেম ডেভেলপারদের জন্য একটি AI-powered IDE, Playbot তৈরিতে GPT-6 Astra ব্যবহার করে। এটি Unity এবং Godot এর মতো ইঞ্জিনের সাথে সরাসরি সংযুক্ত হয়। AI মডেলগুলো দৃশ্য সম্পাদনা করতে, গেম খেলতে ও পরীক্ষা করতে, পরিবর্তন যাচাই করতে এবং ডেভেলপাররা ইতিমধ্যে যে টুল ব্যবহার করেন তার ভেতরেই সমান্তরালে কাজ করতে পারে।
Playbot এর সক্ষমতা:
- ইঞ্জিনে দৃশ্য সম্পাদনা।
- গেম চালু করা এবং পরীক্ষা করা।
- পরিবর্তন যাচাই করা।
- বিদ্যমান টুলের ভেতরে সমান্তরাল কাজ।
Playbot মডেলকে গেম খেলতে এবং নিজের পরিবর্তন যাচাই করতে দেয়। তাই Astra সহজে বাগ এবং খেলোয়াড়ের অভিজ্ঞতা উন্নত করার জায়গা খুঁজে পেয়েছে। নির্বাচনের মানদণ্ড: টুলটি বর্তমান ইঞ্জিনে সংযুক্ত হতে হবে এবং মডেলকে অনুশীলনে ফলাফল যাচাই করার সুযোগ দিতে হবে।
ধারণা নিয়ে কাজ করার জন্য এর অর্থ কী
Playco এর জন্য মূল প্রভাব — আরও বেশি ধারণাকে এমন কিছুতে রূপান্তরিত করার সুযোগ যা ডেভেলপাররা খেলতে এবং তুলনা করতে পারে। কোম্পানি বলছে, একটি গেমের জন্য দশটি ধারণা থাকলে সব দশটিই তৈরি করা যায়। তারপর সেগুলো খেলে দেখা যায় কেমন লাগে, শুধু কল্পনা না করে।
ব্যবহারিক মানদণ্ড: একটি টুল তখনই মূল্যবান যখন এটি ধারণা থেকে খেলার যোগ্য তুলনায় переход দ্রুত করে। এটি শুধু কোড তৈরি করতেই নয়, গেমে পরিবর্তন কেমন লাগে তা যাচাই করতেও সাহায্য করে। তখন দলটি প্রতিটি প্রোটোটাইপে কম ম্যানুয়াল সংশোধনে সময় ব্যয় করে।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
RL সিমুলেটরের ব্যর্থতা নির্ণয়ে ক্যানোনিক্যাল বহুপদী ইনভেরিয়েন্ট: এগুলো আসলে কোথায় কাজে লাগে
এই কাজটি পরীক্ষা করে, প্রশিক্ষণযোগ্য গতিবিদ্যার মডেলগুলোতে পদার্থবিজ্ঞানের সূত্র অন্তর্ভুক্ত করা কতটা যুক্তিযুক্ত: ট্র্যাজেক্টরি থেকে আহরিত এবং গ্রোবনার ভিত্তির মাধ্যমে ক্যানোনিকাল রূপে আনা ইনভারিয়ান্টগুলো পূর্বাভাসে সামান্য উন্নতি আনে, তবে রোগনির্ণয়ে কার্যকর—এগুলো লঙ্ঘিত সীমাবদ্ধতাটি কোথায় ঘটেছে তা নির্দিষ্ট করতে এবং নির্দিষ্ট ভুল প্যারামিটার শনাক্ত করতে সাহায্য করে।
10 নভেম্বর 2026
AURA-Eval: কীভাবে যাচাই করবেন যে LLM এজেন্ট ঝুঁকি শনাক্ত করেছে এবং পরবর্তী পদক্ষেপ পরিবর্তন করেছে
এই ফ্রেমওয়ার্ক LLM এজেন্টদের আচরণকে চূড়ান্ত রায় দিয়ে নয়, বরং গুরুত্বপূর্ণ মুহূর্তে ঝুঁকির প্রতিক্রিয়া দিয়ে মূল্যায়ন করে: টুল কলের ধারা মাঝপথে থামিয়ে দেওয়া হয়, এরপর মডেলকে তার যুক্তি ও কাজ চালিয়ে যেতে হয়; আর LLM বিচারকদের একটি প্যানেল ঝুঁকি শনাক্তকরণ, পদক্ষেপের ধরন ও নিরাপত্তা বিশ্লেষণ করে। R-Judge-এর 157টি ট্র্যাজেক্টরি থেকে সংগৃহীত 1249টি কাজে, 20টি মডেলের নিরাপদ পথ না থাকলে অনিরাপদ পদক্ষেপ নেওয়ার প্রবণতা বেড়ে যায়; আর কাজ সম্পন্ন হওয়ার আগে তদারকি তুলে নিলে শুরুতে নিরাপদ থাকা ঘটনাগুলোর 52,3% অনিরাপদ হয়ে ওঠে।
10 নভেম্বর 2026
চের্ন–সাইমনস রিজার্ভারের স্মৃতি: সংযোগের স্বায়ত্তশাসিত গতিবিদ্যা এবং ঘনত্ব পরিবহন
এই নিবন্ধে আলোচনা করা হয়েছে, কীভাবে একটি রিজার্ভয়ার ইনপুট সিগন্যালের ইতিহাস একই সঙ্গে ঘনত্বের বণ্টন এবং জ্যামিতিক স্বাধীনতার মাত্রায় সংরক্ষণ করে। চারটি প্রক্রিয়ার তুলনা দেখায় যে কারেন্ট একটি স্বতন্ত্র সংযুক্তি উপাদান তৈরি করে, যা ঘনত্বের পরবর্তী প্রতিক্রিয়া পরিবর্তন করে; আর পরিমাপ করা সব বৈশিষ্ট্য বিবেচনায় নিলে ইমপালসের ক্রম ডিকোড করার ক্ষেত্রে সামান্য উন্নতি হয়।
10 নভেম্বর 2026