RL-এর পর SFT কেন যুক্তি করার ক্ষমতাকে হুমকির মুখে ফেলে
রিইনফোর্সমেন্ট লার্নিং বড় ভাষা মডেলের যুক্তি করার ক্ষমতা বিকশিত করে। এই পদ্ধতি LLM-এর পোস্ট-ট্রেনিংয়ের জন্য কার্যকর হয়ে উঠেছে। পরবর্তী supervised fine-tuning পোস্ট-RL মডেলকে নতুন জ্ঞানের ক্ষেত্র বা আচরণের ধরন অনুযায়ী মানিয়ে নেয়। এমন SFT অর্জিত সক্ষমতাগুলোকে গুরুতরভাবে মুছে দিতে পারে।
ভুলে যাওয়া কমানোর বিদ্যমান পদ্ধতিগুলো:
- অভিজ্ঞতার পুনরাবৃত্তি;
- বিশেষায়িত ইনিশিয়ালাইজেশন;
- গ্রেডিয়েন্ট প্রজেকশনসহ সীমাবদ্ধ অপ্টিমাইজেশন।
এই পদ্ধতিগুলো হয় সক্ষমতা সীমিতভাবে ধরে রাখতে পারে, নয়তো উল্লেখযোগ্য অতিরিক্ত গণনার প্রয়োজন হয়। ব্যবহারিক মানদণ্ড: পোস্ট-RL মডেলের জন্য এমন পদ্ধতি বেছে নেওয়া হয়, যা যুক্তি করার ক্ষমতা মুছে যাওয়ার ঝুঁকি কমায়।
অভিযোজনের জন্য সম্পদ হিসেবে নাল-স্পেস
লেখকেরা দেখিয়েছেন: যুক্তি করার সঙ্গে সম্পর্কিত অ্যাক্টিভেশনগুলো নিম্ন-মাত্রিক সাবস্পেসে কেন্দ্রীভূত। অভিযোজনের জন্য নাল-স্পেসে উল্লেখযোগ্য সক্ষমতা অবশিষ্ট থাকে। অল্প কয়েকটি নমুনা থেকে আনুমানিক নাল-স্পেস নির্ভরযোগ্যভাবে নির্ণয় করা যায়।
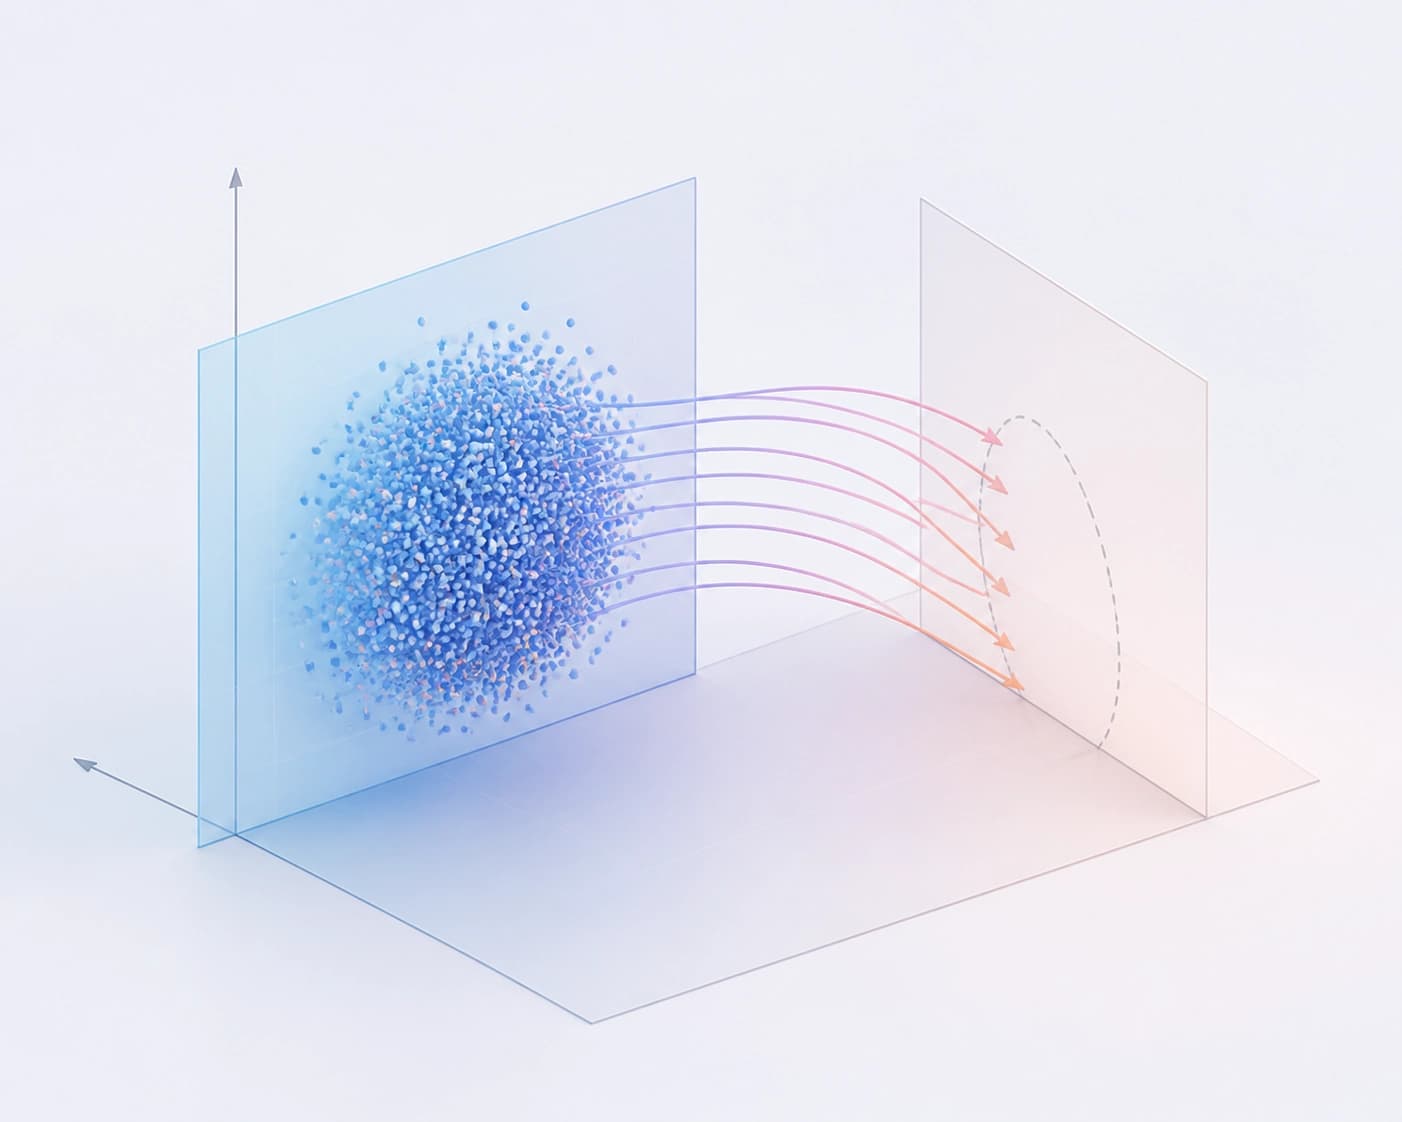
ব্যবহারিক মানদণ্ড: নাল-স্পেসে আপডেট তৈরি করে এমন পদ্ধতি অব্যবহৃত সক্ষমতা কাজে লাগায়। এটি যুক্তি করার অ্যাক্টিভেশনগুলোকে প্রভাবিত করে না।
NB-LoRA-এর গঠন
Null-Basis Low-Rank Adaptation (NB-LoRA) হলো পোস্ট-RL LLM-এর প্যারামিটার-দক্ষ অভিযোজনের একটি পদ্ধতি। এটি arXiv:2609.25618 নিবন্ধে প্রস্তাব করা হয়েছে। পদ্ধতিটি অর্জিত যুক্তি করার সক্ষমতা ধরে রাখে।
কাজের ধাপগুলো:
- যুক্তি করার অ্যাক্টিভেশন থেকে একটি স্থির আনুমানিক নাল-বেসিস তৈরি করা হয়।
- LoRA আপডেটগুলোকে এই বেসিসের মাধ্যমে পুনঃপ্যারামিটারাইজ করা হয়।
- যুক্তি করার ক্ষমতা ধরে রাখাকে লেয়ার-স্তরে হিডেন স্টেট ধরে রাখার সীমাবদ্ধতা হিসেবে প্রকাশ করা হয়।
- ফাইন-টিউনিং চলাকালীন এই সীমাবদ্ধতা মেনে চলা হয়।
ব্যবহারিক মানদণ্ড: পোস্ট-RL মডেলের যুক্তি করার ক্ষমতা ধরে রেখে SFT করতে হলে NB-LoRA বেছে নেওয়া হয়।
বিদ্যমান পদ্ধতির সঙ্গে তুলনা
সারণিতে প্রক্রিয়া ও বৈশিষ্ট্যগুলোর তুলনা করা হয়েছে।
| মানদণ্ড | বিদ্যমান পদ্ধতি | NB-LoRA |
|---|---|---|
| প্রক্রিয়া | অভিজ্ঞতার পুনরাবৃত্তি, বিশেষায়িত ইনিশিয়ালাইজেশন, গ্রেডিয়েন্ট প্রজেকশনসহ সীমাবদ্ধ অপ্টিমাইজেশন | স্থির আনুমানিক নাল-বেসিসের মাধ্যমে LoRA পুনঃপ্যারামিটারাইজেশন |
| বৈশিষ্ট্য | সক্ষমতা সীমিতভাবে ধরে রাখা অথবা উল্লেখযোগ্য অতিরিক্ত গণনা | লেয়ার-স্তরে হিডেন স্টেট ধরে রাখার সীমাবদ্ধতা |
ব্যবহারিক মানদণ্ড: যুক্তি করার ক্ষমতা ধরে রাখা অগ্রাধিকার হলে NB-LoRA-তে এই সীমাবদ্ধতা অন্তর্নির্মিত থাকে। বিদ্যমান পদ্ধতিগুলোতে সীমিত সংরক্ষণ এবং অতিরিক্ত গণনার মধ্যে একটি বেছে নিতে হয়।
পরীক্ষার ফলাফল ও নির্বাচনের মানদণ্ড
পরীক্ষায় RL দিয়ে প্রশিক্ষিত বেশ কয়েকটি LLM এবং বিভিন্ন ধরনের পরবর্তী কাজ অন্তর্ভুক্ত রয়েছে। NB-LoRA-তে অভিযোজনের মান স্ট্যান্ডার্ড LoRA-এর সমপর্যায়ে দেখা যায়। পদ্ধতিটি যুক্তি করার নির্ভুলতা ফাইন-টিউনিংয়ের আগের স্তরের কাছাকাছি ধরে রাখে। এই সংরক্ষণ বাদ রাখা যুক্তি-বিষয়ক বেঞ্চমার্কেও বজায় থাকে।
ব্যবহারিক মানদণ্ড: SFT যেখানে পোস্ট-RL LLM-এর যুক্তি করার ক্ষমতাকে হুমকির মুখে ফেলে, সেখানে NB-LoRA নিজের কাজগুলোতে যাচাই করার মতো একটি বিকল্প।