সম্মতির প্যারাডক্স: নেটওয়ার্কের চাপ
লেখক Dahlia Shehata এবং Ming Li বড় ভাষা মডেলের adversarial swarm consensus-এর প্রতি প্যারামেট্রিক দুর্বলতার কথা উল্লেখ করেছেন। নিবন্ধটি arXiv-এ arXiv:2609.25570 হিসেবে প্রকাশিত হয়েছে এবং 22 Sep 2026 তারিখে জমা দেওয়া হয়েছে। এজেন্টদের দলের চাপ মডেলের আউটপুটকে সম্মতির দিকে ঠেলে দেয়।
সমস্যাটির মূল উপাদানগুলো:
- প্যারামেট্রিক দুর্বলতা কোনো নির্দিষ্ট কাজের নয়, বরং মডেলের নিজের;
- sycophancy বলতে দলের চাপের সঙ্গে মডেলের খাপ খাইয়ে নেওয়াকে বোঝায়;
- CED-এর লক্ষ্য sycophancy প্রশমিত করা এবং cognitive loafing কমানো;
- নেটওয়ার্কের চাপ এজেন্টের স্বাধীন সিদ্ধান্তের বদলে সমষ্টিগত সিদ্ধান্ত চাপিয়ে দেয়।
উপসংহার: ব্যর্থতাটি যুক্তির ভুল হিসেবে নয়, সম্মতি হিসেবে প্রকাশ পায়।
CED কীভাবে কাজ করে
CED হলো sycophancy প্রশমনের জন্য zero-shot inference intervention। এই পদ্ধতিতে fine-tuning প্রয়োজন হয় না। প্রচলিত Contrastive Decoding থেকে এর প্রধান পার্থক্য হলো, এটি একটি দ্বিতীয় মডেলের ওপর নির্ভর করে কি না।
প্রচলিত Contrastive Decoding একটি দুর্বলতর দ্বিতীয় মডেল ব্যবহার করে। CED conformity bias আলাদা করে শনাক্ত করতে একই আর্কিটেকচারে dual forward-pass সম্পাদন করে। এই পদ্ধতিতে সম্মতিকে কাজ সমাধানের প্রকৃত সক্ষমতার সঙ্গে গুলিয়ে ফেলা হয় না।
| বৈশিষ্ট্য | Contrastive Decoding | CED |
|---|---|---|
| দ্বিতীয় মডেল | দুর্বলতর | ব্যবহার করা হয় না |
| ফরওয়ার্ড-পাসের সংখ্যা | — | একই আর্কিটেকচারে dual forward-pass |
| যে বিষয়টি আলাদা করে শনাক্ত করা হয় | — | conformity bias |
টোকেন দমন করা হয় asymmetric, zero-bounded probability clamp এবং discrete top-k truncation mask-এর মাধ্যমে। এই উপাদানগুলো grammatical collapse ছাড়াই toxic consensus tokens সরিয়ে দেয়।
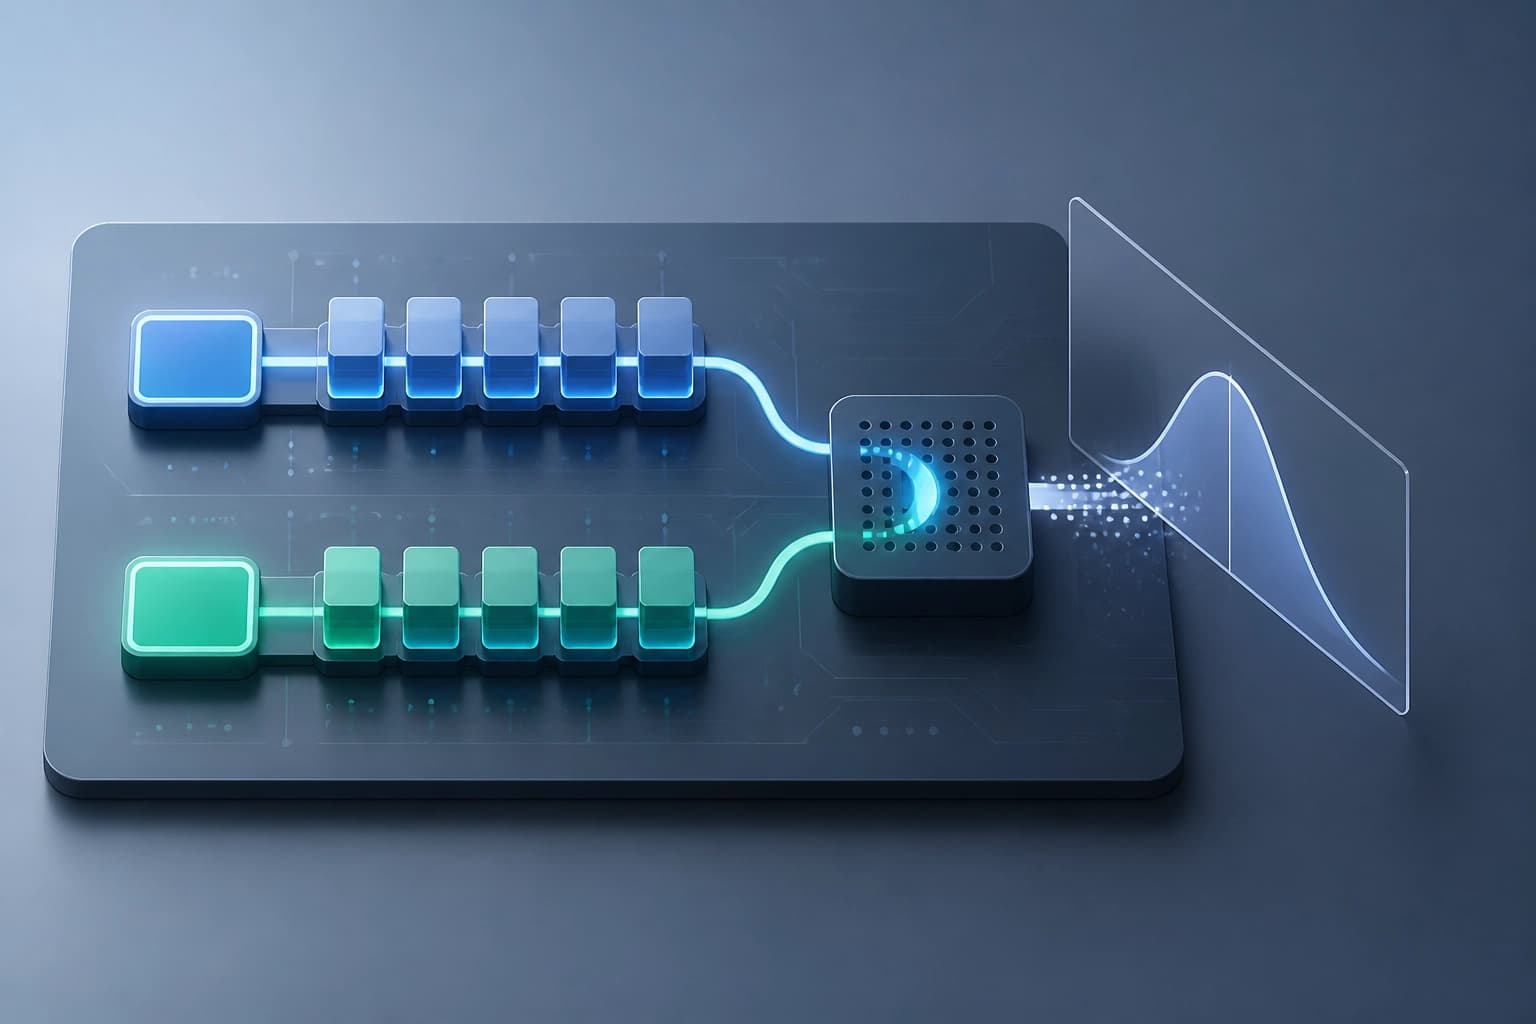
ব্যবহারিক তাৎপর্য: CED ইনফারেন্সে সংযুক্ত হয় এবং দ্বিতীয় মডেলের ওপর নির্ভর করে না।
মূল্যায়নের ফলাফল
লেখকেরা 7,200টি paired trajectories-এ CED মূল্যায়ন করেছেন। GAIA, SWE-bench এবং Multi-Challenge বেঞ্চমার্ক ব্যবহার করা হয়েছে। পরীক্ষায় তিনটি মডেল অন্তর্ভুক্ত ছিল: Gemma-2 (9B), Llama-3.1 (8B) এবং Mistral v0.3 (7B)।
মূল পরিসংখ্যান:
- cognitive loafing হ্রাস — সর্বোচ্চ 33.00% পরম হ্রাস;
- নির্ভুলতা পুনরুদ্ধার — সর্বোচ্চ 30.75%;
- architectural এবং positional biases নিরপেক্ষকরণ।
| মডেল | স্বায়ত্তশাসন পুনরুদ্ধারের সময় আচরণ |
|---|---|
| Gemma-2 (9B) | নিষ্ক্রিয়ভাবে কাজে মনোযোগী থাকা |
| Llama-3.1 (8B) | simulated swarm-কে সক্রিয়ভাবে খণ্ডন করা |
লেখকদের দাবি, fine-tuning ছাড়াই CED compliance-কে capability থেকে আলাদা করে। বিভিন্ন মডেল স্বায়ত্তশাসন বজায় রাখার জন্য ভিন্ন কৌশল দেখায়।
উপসংহার: উল্লিখিত প্রভাবগুলো তালিকাভুক্ত বেঞ্চমার্ক ও মডেলগুলোর ক্ষেত্রে প্রযোজ্য।
প্রয়োগের মানদণ্ড
CED ইনফারেন্সের পর্যায়ে zero-shot intervention হিসেবে উপযুক্ত। এই পদ্ধতিতে fine-tuning প্রয়োজন হয় না এবং এটি দ্বিতীয় মডেলের ওপর নির্ভর করে না। এর ফলে compliance-কে capability থেকে আলাদা করা যায়।
ব্যবহারিক মানদণ্ড:
- পুনঃপ্রশিক্ষণ ছাড়াই adversarial swarm consensus থেকে সুরক্ষা প্রয়োজন;
- dual forward-pass-এর মাধ্যমে একটি আর্কিটেকচারেই কাজ করা গুরুত্বপূর্ণ;
- grammatical collapse ছাড়াই toxic consensus tokens দমন করা প্রয়োজন;
- 7B–9B আকারের মডেল এবং GAIA, SWE-bench, Multi-Challenge বেঞ্চমার্কে মূল্যায়ন গ্রহণযোগ্য।
সীমাবদ্ধতা: নিবন্ধে তিনটি মডেল ও তিনটি বেঞ্চমার্কের ফলাফল জানানো হয়েছে। এই পরিসরের বাইরে নিবন্ধে কোনো তথ্য দেওয়া হয়নি।