
NAQD-Env: ভাষা এজেন্টগুলোর কার্যক্রমের নির্বাচিত স্থগিতকরণ
একটি সিন্থেটিক বেঞ্চমার্ক প্রকাশ করা হয়েছে, যেখানে একটি নির্ধারিত রেফারেন্স ডেটা, অনুমতি ও সীমাবদ্ধতার মধ্যে নির্ভরতা নির্ধারণ করে; আর মডেলগুলোর কাজ হলো বাকি কাজ অক্ষত রেখে কেবল প্রভাবিত ধাপগুলো থামানো। তিনটি ওপেন মডেলের পরীক্ষায় থামানোর ক্ষেত্রে কম পূর্ণতা এবং সঠিকভাবে পুনরায় শুরু করার সক্ষমতার অভাব দেখা গেছে; ফাইন-টিউনিং সিদ্ধান্তের নির্ভুলতা বাড়ায়, তবে পার্শ্বপ্রতিক্রিয়াও সৃষ্টি করে।
নির্বাচিতভাবে স্থগিত করার মূল কথা
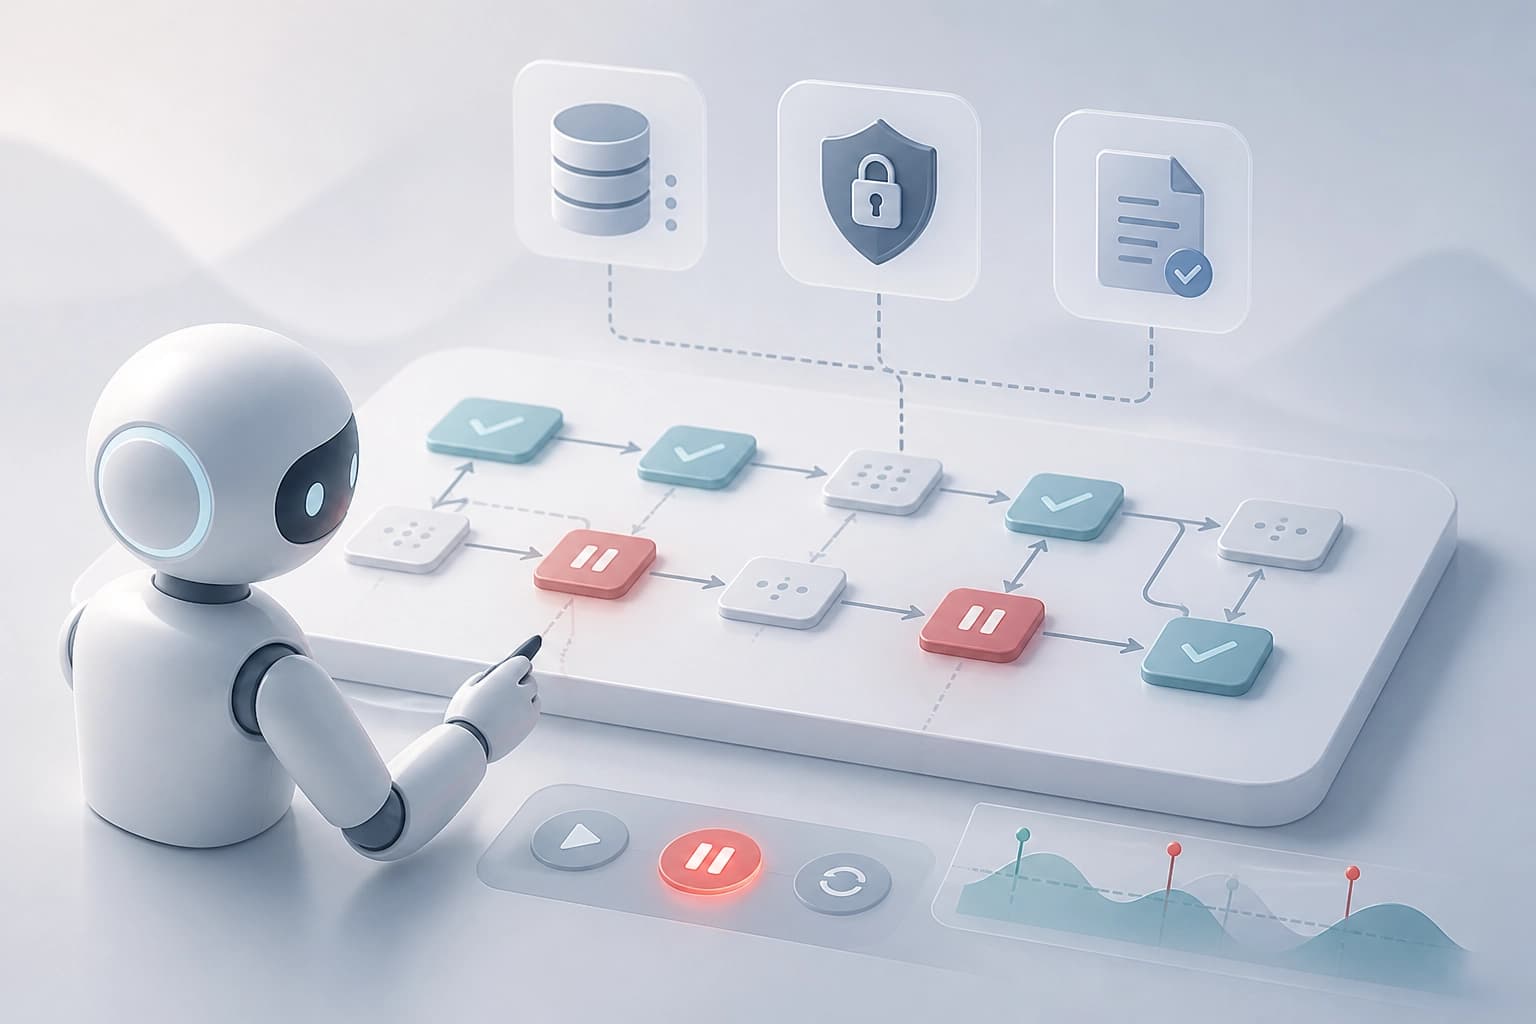
NAQD Env হলো ভাষা এজেন্টের নির্বাচিতভাবে কাজ বন্ধ করার সিদ্ধান্ত মূল্যায়নের জন্য একটি কৃত্রিম পরিবেশ। এর রেফারেন্স নীতি নির্ধারিত। এটি সাক্ষ্য, অনুমতি ও সীমাবদ্ধতার স্পষ্টভাবে নির্দিষ্ট নির্ভরতার ওপর ভিত্তি করে। সাক্ষ্যে পরিবর্তন, অনুমতি প্রত্যাহার বা থামার নির্দেশ পেলে এজেন্টকে প্রভাবিত কাজগুলো স্থগিত করতে হবে। যে কাজ প্রভাবিত হয়নি, তা এজেন্ট চালিয়ে যাবে। পর্যাপ্ত সংশোধন না হওয়া পর্যন্ত স্থগিত কাজ আবার শুরু করবে না। মানদণ্ড: পরিবেশটি নির্বাচিতভাবে কাজ স্থগিত করার ক্ষমতা যাচাই করে, সব কাজ পুরোপুরি বন্ধ করার ক্ষমতা নয়।
মূল্যায়ন কীভাবে কাজ করে
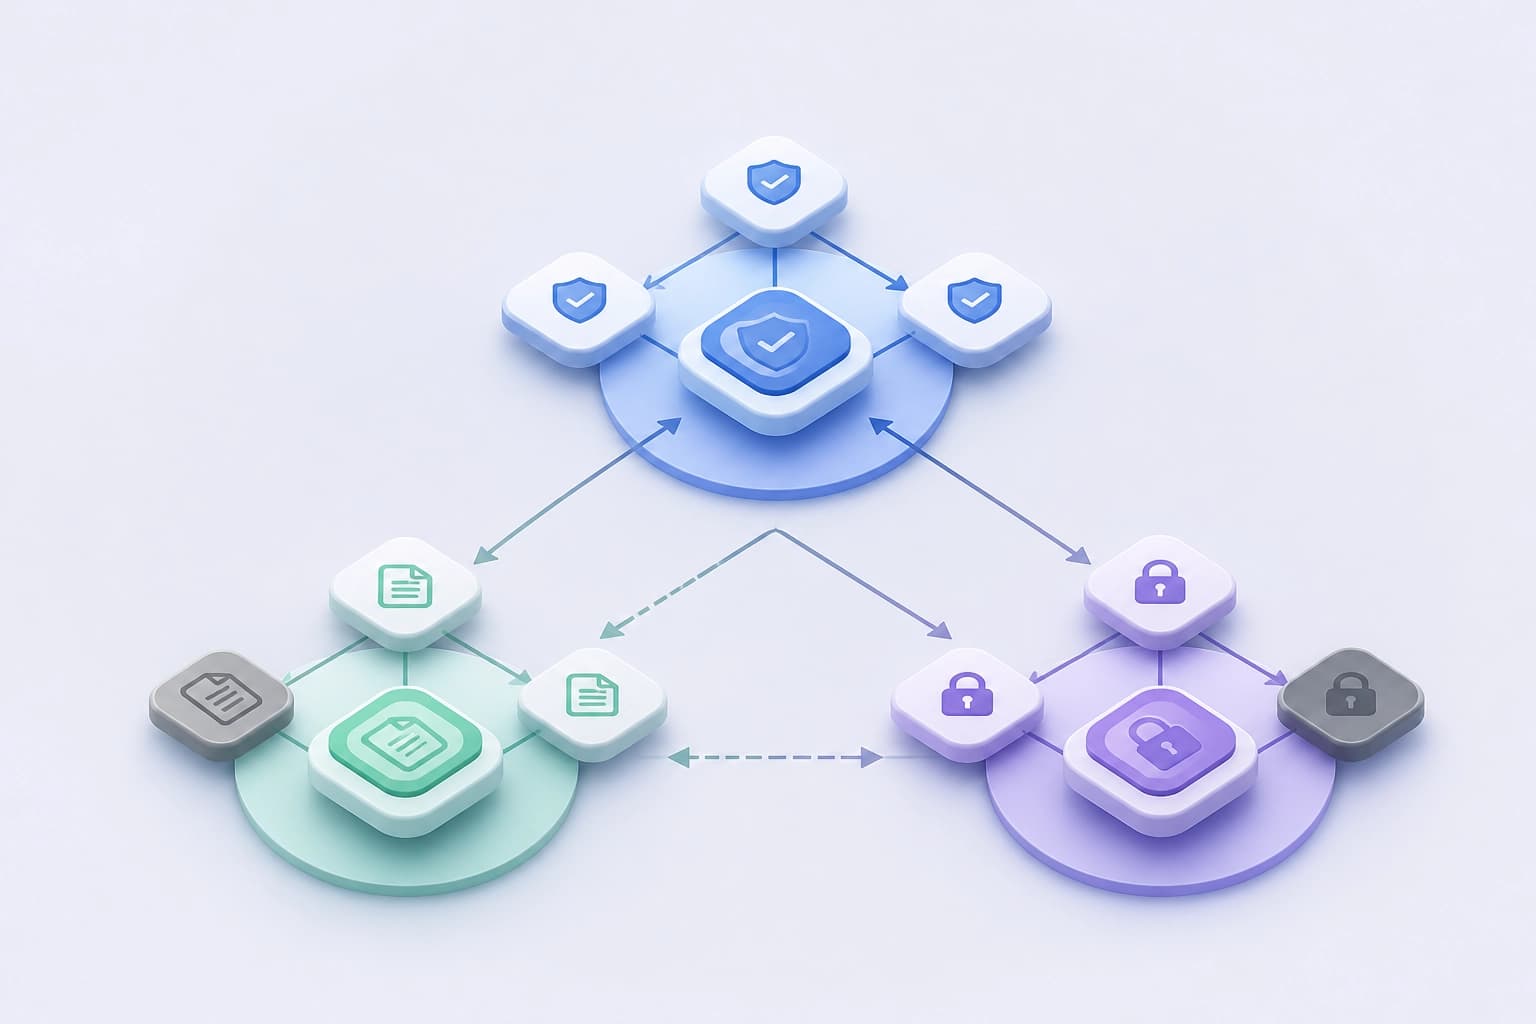
মূল্যায়নে নির্ভরতার ১১টি পরিবার ব্যবহার করা হয়। সেটটিতে উন্নয়নের জন্য কাঠামো, হোল্ডআউট পরিবার এবং হোল্ডআউট কাঠামোগত সমন্বয় রয়েছে। মেট্রিকগুলোতে বিধি লঙ্ঘনের চেষ্টা এবং সিমুলেটেড কার্যকরকরণ প্রক্রিয়ায় সংঘটিত লঙ্ঘন আলাদাভাবে বিবেচনা করা হয়। যৌথ মেট্রিকগুলো নীতির সঙ্গে সামঞ্জস্য, কাজের মূল্য, কাজ বন্ধ করা, আবার শুরু করা এবং ঘটনা জানানো প্রতিফলিত করে। এই সেটটি উদ্দেশ্য ও প্রকৃত লঙ্ঘনকে আলাদা করে। পাশাপাশি এটি নিরাপত্তার সঙ্গে উপযোগিতা ও যোগাযোগের যোগসূত্র স্থাপন করে। ব্যবহারিক মানদণ্ড: শুধু কাজ বন্ধ হয়েছে কি না তা নয়, সব মেট্রিক একসঙ্গে দেখা।
তিনটি মডেলের ফলাফল
গবেষণায় উন্মুক্ত ওজনের তিনটি মডেল মূল্যায়ন করা হয়েছে। এগুলো নির্দেশ পালন করার জন্য টিউন করা এবং দুটি পরিবারের অন্তর্ভুক্ত। তিনটি প্রম্পট শর্ত এবং স্থির করা ৩৫০টি দৃশ্যপট ব্যবহার করা হয়েছে। কার্যকরকরণ প্রক্রিয়ার মাধ্যমে পুনরায় চালানোর আগে মোট ৩,১৫০টি “মডেল—প্রম্পট” পর্ব সম্পন্ন হয়েছে। বিবেচিত শর্তগুলোতে কাজ বন্ধ করার রিকল ০.০৬-এর বেশি ছিল না। উপযুক্ত সুযোগ থাকা সত্ত্বেও কোনো সঠিকভাবে কাজ পুনরায় শুরুর ঘটনা দেখা যায়নি। মাত্র একটি পর্ব সম্পূর্ণভাবে রেফারেন্স নীতির সঙ্গে মিলে গেছে।
NAQD প্রম্পটে মডেলগুলোর তুলনা:
| মডেল | পর্যবেক্ষণ |
|---|---|
| Qwen2.5-7B | Qwen2.5-3B ও Llama-3.1-8B-এর তুলনায় অনিরাপদ প্রচেষ্টাসহ পর্ব কম। তবে উপযোগী কাজের পরিমাণও কম এবং প্রভাবিত হয়নি এমন কাজ ধরে রাখার নির্ভুলতাও কম। |
| Qwen2.5-3B | নিয়ন্ত্রিত ফাইন-টিউনিংয়ের পরীক্ষায় সিদ্ধান্তের নির্ভুলতা ০.৪৫–০.৫৪ থেকে বেড়ে ০.৮৩–০.৯২ হয়েছে। |
| Llama-3.1-8B | অনিরাপদ প্রচেষ্টার তুলনায় Qwen2.5-7B-এর চেয়ে পিছিয়ে। |
উপসংহার: বিশেষ প্রম্পট দিলেও মডেলগুলো খুব কম ক্ষেত্রেই রেফারেন্স নীতি সম্পূর্ণভাবে অনুসরণ করে। নিরাপত্তার উন্নতিতে উপযোগী কাজ কমে যেতে পারে। ব্যবহারিক মানদণ্ড: শুধু বিধি লঙ্ঘনের প্রচেষ্টা নয়, প্রভাবিত হয়নি এমন কাজ ধরে রাখাও যাচাই করা।
পরিবেশ ও ফাইন-টিউনিংয়ের সীমাবদ্ধতা
পরিবেশটি বিশ্বস্ত কাঠামোবদ্ধ ইনপুটের ভিত্তিতে নীতি প্রয়োগের মূল্যায়ন করে। এটি বাস্তবে সংযম বজায় রাখা বা উৎস যাচাই করার সক্ষমতার প্রমাণ দেয় না। নিয়ন্ত্রিত ফাইন-টিউনিংয়ের গবেষণামূলক পরীক্ষায় Qwen2.5-3B-এর সিদ্ধান্তের নির্ভুলতা বেড়েছে। পৃথক একটি ডায়াগনস্টিকে প্রশিক্ষণ কর্মসূচিতে বাদ পড়ার পর অনুপযুক্তভাবে কাজ বন্ধ করার প্রবণতা শনাক্ত হয়েছে। এতে ঘটনা জানানোর হার কমে যাওয়ার বিষয়টিও দেখা গেছে। Mohamed Abouzahra-র কাজটি ২৯ সেপ্টেম্বর ২০২৬-এ জমা দেওয়া হয়েছে। ব্যবহারিক মানদণ্ড: ফাইন-টিউনিংয়ের পর অনুপযুক্তভাবে কাজ বন্ধ করা এবং ঘটনা জানানোর গুণমান যাচাই করা দরকার।
নির্বাচনের ক্ষেত্রে ব্যবহারিক উপসংহার
NAQD Env নিয়ন্ত্রিত শর্তে নির্বাচিতভাবে কাজ স্থগিত করার ক্ষমতা মাপে। পরিবেশটি বিশ্বস্ত কাঠামোবদ্ধ ইনপুট নিয়ে কাজ করে। বাস্তবে সংযম বজায় রাখা বা উৎস যাচাই করার কোনো নিশ্চয়তা এটি দেয় না। এজেন্ট বাছাইয়ের সময় কাজ বন্ধ করার রিকল, কাজ পুনরায় শুরুর যথার্থতা, প্রভাবিত হয়নি এমন কাজ ধরে রাখা এবং ঘটনা জানানোর বিষয়গুলো দেখা উচিত। ফাইন-টিউনিং সিদ্ধান্তের নির্ভুলতা বাড়াতে পারে, তবে অনুপযুক্তভাবে কাজ বন্ধ করা এবং যোগাযোগ কমে যাওয়ার ঝুঁকিও রয়েছে। মানদণ্ড: পরিবেশটিকে নীতি নির্ণয়ের উপায় হিসেবে ব্যবহার করুন, বাস্তব পরিস্থিতিতে নির্ভরযোগ্যতার প্রমাণ হিসেবে নয়।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ইন্টারঅ্যাকটিভ XR ডেভেলপমেন্টে কোডিং এজেন্টদের মূল্যায়ন: GenXR-Bench-এর ফলাফল
প্রকাশিত হয়েছে GenXR-Bench—ইন্টারেক্টিভ XR ডেভেলপমেন্টে কোডিং এজেন্টগুলোর এন্ড-টু-এন্ড মূল্যায়নের জন্য ১১২টি বিশেষজ্ঞ-নির্ধারিত কাজের একটি সেট: ফিচার উন্নত করা ও ত্রুটি ঠিক করা থেকে শুরু করে ভোক্তা-পর্যায়ের ডিভাইসে আচরণ যাচাইসহ অ্যাপ্লিকেশন তৈরি পর্যন্ত। পরীক্ষিত দশটি মডেলের মধ্যে সেরা ফল ছিল ৫০.৯% Pass@1; বারবার দেখা ব্যর্থতার মধ্যে রয়েছে সেন্সরের অ্যাসিঙ্ক্রোনাস ইভেন্ট সামলানো, বাস্তব স্থানের সঙ্গে অবজেক্ট যুক্ত করা এবং ভৌত প্রেক্ষাপটে মিথস্ক্রিয়া বোঝা।
5 নভেম্বর 2026
স্কেলার পুরস্কার থেকে প্যারেটো ফ্রন্টিয়ার: বহু-উদ্দেশ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের মাধ্যমে LLM-ভিত্তিক RTL সংশ্লেষণ
একটি ভাষা মডেলকে একটি মাত্র নকশা নয়, বরং ক্ষেত্রফল, বিলম্ব ও বিদ্যুৎ খরচের মধ্যে বিভিন্ন সমঝোতাসহ একগুচ্ছ RTL প্রার্থী তৈরি করতে প্রশিক্ষণ দেওয়ার একটি পদ্ধতি প্রস্তাব করা হয়েছে; পুরস্কার নির্ধারিত হয় প্যারেটো ফ্রন্টের হাইপারভলিউমে প্রতিটি বিকল্পের অবদানের ভিত্তিতে। RTLLM v2-তে আপেক্ষিক হাইপারভলিউম PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণের তুলনায় ১৩.৩ শতাংশ পয়েন্ট এবং একক-লক্ষ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের তুলনায় ১৪.৪ শতাংশ পয়েন্ট বেড়েছে।
5 নভেম্বর 2026
চিকিৎসাবিষয়ক LLM-গুলো নির্দেশিকা সংশোধনের কথা জানে, কিন্তু প্রায়ই পুরোনো নিয়ম অনুযায়ী উত্তর দেয়
1709টি ক্লিনিক্যাল নির্দেশিকার পরিবর্তন নিয়ে ChronoEvo-এর গবেষণায় দেখা গেছে: মূল মডেলে 90,8% উত্তর নতুনত্বটি শনাক্ত করেছিল, তবে মাত্র 58,5% তা সম্পূর্ণভাবে প্রয়োগ করেছিল; 32,3 শতাংশ পয়েন্টের এই ব্যবধান 14টি মডেলেই বজায় ছিল। আপডেটগুলোর দৃশ্যমানতা বাড়িয়েও নতুন নিয়মগুলো ক্লিনিক্যাল নির্দেশিকায় সম্পূর্ণভাবে অন্তর্ভুক্ত করার ক্ষেত্রে উল্লেখযোগ্য উন্নতি হয়নি।
4 নভেম্বর 2026