
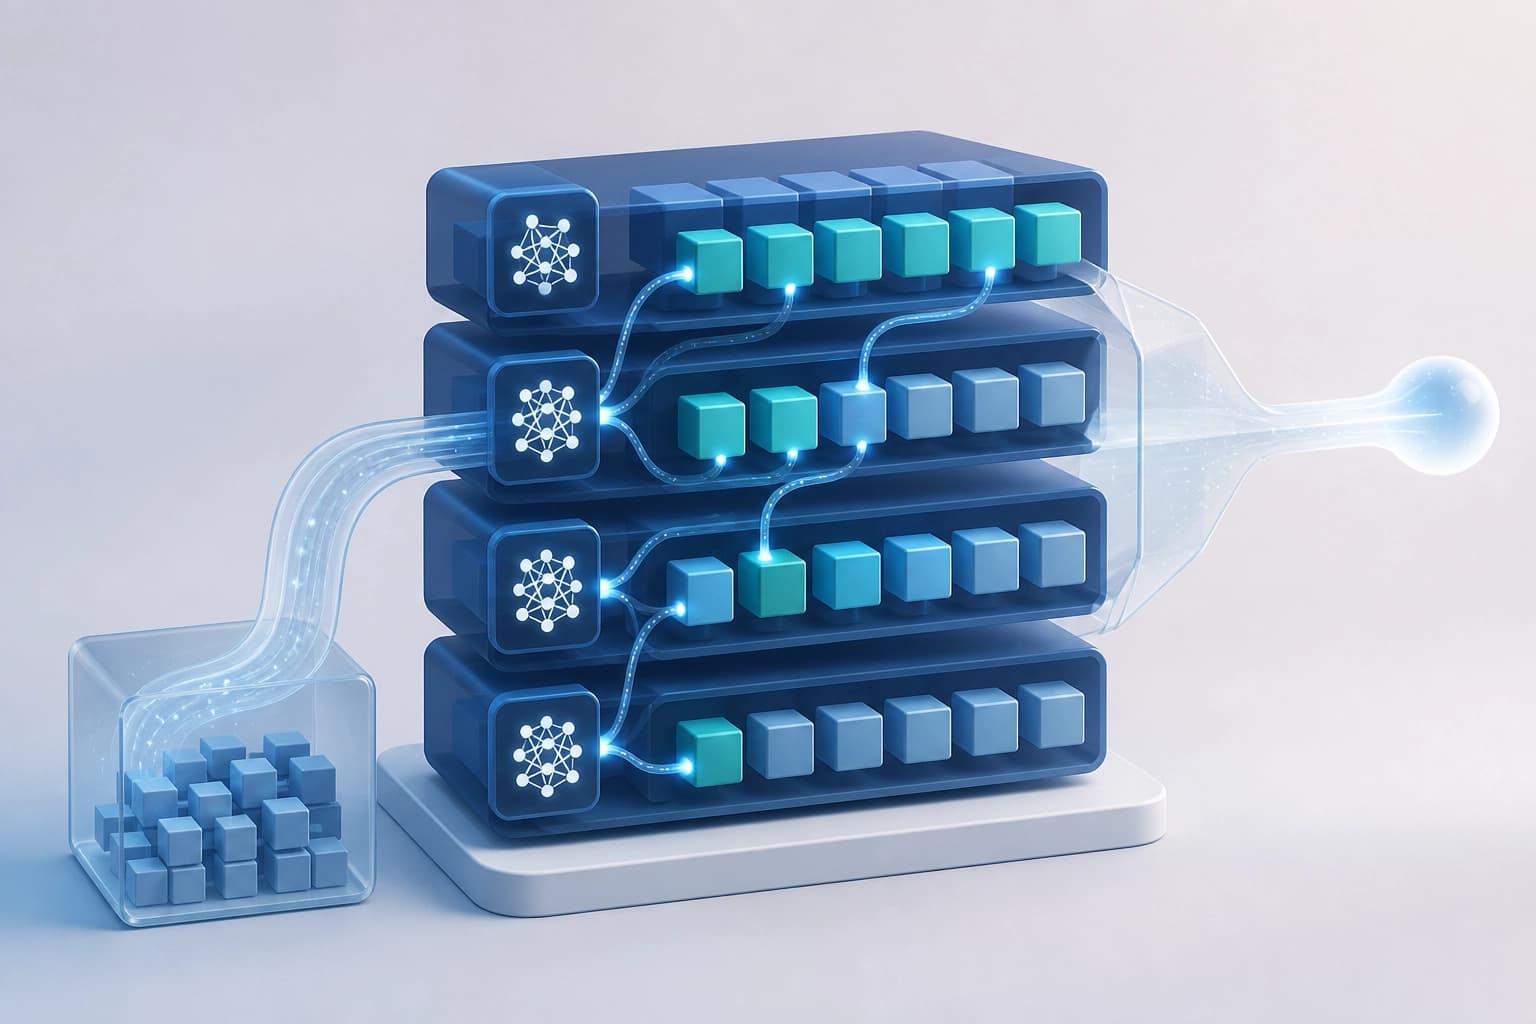
বিভিন্ন স্তরে একই রকম বিশেষজ্ঞ বাজেটের সমস্যা
স্পার্সলি-অ্যাক্টিভেটেড MoE ট্রান্সফরমার সব স্তরে একই সংখ্যক রাউটেড বিশেষজ্ঞ নির্ধারণ করে। এটি স্তরগুলোর মধ্যে অপ্রয়োজনীয়তার নথিভুক্ত ভিন্নতাকে উপেক্ষা করে।
MAPLE একটি plug-and-play ফ্রেমওয়ার্ক। এটি যেকোনো পূর্ব-প্রশিক্ষিত MoE LLM-এর স্তরগুলোর মধ্যে রাউটেড বিশেষজ্ঞদের বাজেট পুনর্বণ্টন করে। পদ্ধতিটি ওজন পরিবর্তন করে না এবং পুনঃপ্রশিক্ষণের প্রয়োজন হয় না।
মূল বৈশিষ্ট্য:
- স্তরভেদে ভিন্নধর্মী বাজেট বণ্টন।
- মডেলের ওজন সম্পাদনার প্রয়োজন নেই।
- পুনঃপ্রশিক্ষণের প্রয়োজন নেই।
- পূর্ব-প্রশিক্ষিত MoE LLM-এ প্রযোজ্য।
ব্যবহারিক মানদণ্ড: পদ্ধতিটি প্রয়োজন যখন ওজন সম্পাদনা ও পুনঃপ্রশিক্ষণ ছাড়াই বিশেষজ্ঞদের বণ্টন পরিবর্তন করতে হয়।
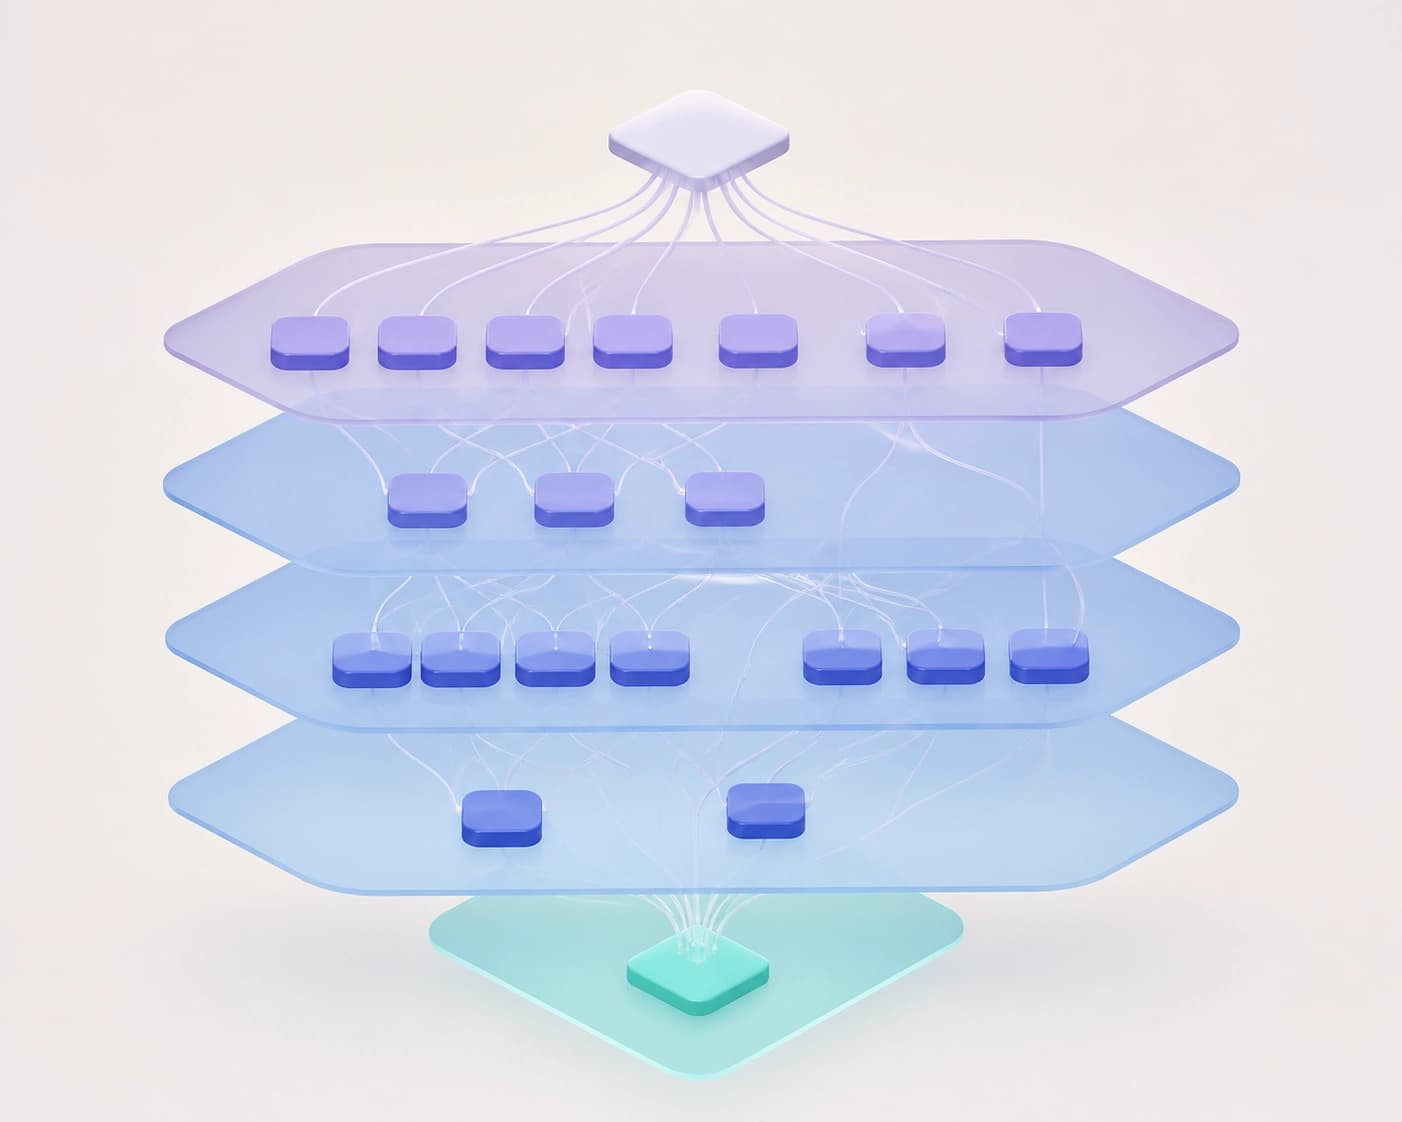
স্তরের সংবেদনশীলতা এবং বদ্ধ সূত্র
MAPLE প্রতিটি স্তর প্রোব করে। পদ্ধতিটি বিশেষজ্ঞ সংখ্যার পরিবর্তনে স্তরের প্রতিক্রিয়া পরীক্ষা করে। সংবেদনশীলতা তিনটি মাপকাঠিতে পরিমাণগতভাবে মূল্যায়ন করা হয়।
বাজেট স্থানান্তরের ধাপ:
- প্রতিটি স্তর প্রোব করা।
- বিশেষজ্ঞ সংখ্যার পরিবর্তনে প্রতিক্রিয়া মূল্যায়ন।
- তিনটি মাপকাঠিতে সংবেদনশীলতার পরিমাণগত মূল্যায়ন।
- বিশ্লেষণাত্মকভাবে সর্বোত্তম বাজেট বণ্টন নির্ণয়।
- সংবেদনশীলতা-সীমাবদ্ধ জেনেটিক অনুসন্ধানের মাধ্যমে পরিমার্জন।
বিশ্লেষণাত্মক বণ্টন সংবেদনশীল স্তরগুলোর দিকে ধারণক্ষমতা পরিচালিত করে। অপ্রয়োজনীয় স্তরগুলোতে বাজেট হ্রাস শোষিত হয়। জেনেটিক অনুসন্ধান স্তরভিত্তিক সংবেদনশীলতাকে পূর্বধারা হিসেবে ব্যবহার করে। এটি দ্রুততর অভিসৃতি এবং উন্নত বণ্টন গুণমান দেয়।
উপসংহার: বাজেট স্থানান্তর সমান নিয়মের বদলে পরিমেয় সংবেদনশীলতার উপর নির্ভর করে।
সমান এবং pruning-পদ্ধতির সাথে তুলনা
MAPLE বিভিন্ন মাপকাঠি ও স্থাপত্যের চারটি MoE মডেলে সমান এবং pruning-based baselines-কে ছাড়িয়ে যায়। তুলনা করা হয় ৭৫% রাউটেড বিশেষজ্ঞ বাজেটে।
| ভিন্নতা | রাউটেড বিশেষজ্ঞ বাজেট | ফলাফল |
|---|---|---|
| সমান baseline | ৭৫% | MAPLE-এর চেয়ে পিছিয়ে |
| Pruning-based baseline | ৭৫% | MAPLE-এর চেয়ে পিছিয়ে |
| MAPLE | ৭৫% | উভয় baseline-কে ছাড়িয়ে যায় |
| সমান baseline | ১০০% | ARC-E, ARC-C এবং BoolQ-তে DeepSeek-MoE-16B-এ ৭৫%-এর MAPLE-এর চেয়ে পিছিয়ে |
DeepSeek-MoE-16B-এ MAPLE শুধুমাত্র ৭৫% বিশেষজ্ঞ ব্যবহার করে। তবুও এটি ARC-E, ARC-C এবং BoolQ-তে মূল ১০০%-সমান baseline-কে ছাড়িয়ে যায়।
নির্ভুলতা বৃদ্ধি:
- ARC-E: ৬৫.০৯ থেকে ৭১.৪০।
- ARC-C: ৪৮.৪৯ থেকে ৫১.৫০।
- BoolQ: ৮০.০৩ থেকে ৮২.৩৮।
উপসংহার: ভিন্নধর্মী বণ্টন কেবল বেশি সংখ্যক বিশেষজ্ঞ সক্রিয় করার চেয়ে বেশি কার্যকর হতে পারে।
SGLang-এ পরিবেশনায় দক্ষতা
SGLang-এ MAPLE-এর বাস্তবায়ন একটি GPU-তে end-to-end পরিবেশন বিলম্ব ৩২.২% হ্রাস করে। থ্রুপুট ৪৭.৪% বৃদ্ধি পায়।
পদ্ধতিটি ওজন পরিবর্তন করে না। তাই এটি বিদ্যমান MoE পরিবেশন স্ট্যাকে সংযুক্ত করা যায়। এটি বাজেট স্থানান্তরকে ইনফারেন্সের জন্য একটি ব্যবহারিক সুবিধায় পরিণত করে।
ব্যবহারিক মানদণ্ড: SGLang-এর মাধ্যমে single-GPU পরিবেশনের জন্য পদ্ধতিটি বিলম্ব হ্রাস এবং থ্রুপুট বৃদ্ধি দেয়।
নির্বাচনের মানদণ্ড
MAPLE কয়েকটি ক্ষেত্রে বিবেচনা করা উচিত:
- পুনঃপ্রশিক্ষণ ছাড়াই রাউটেড বিশেষজ্ঞ বাজেট কমাতে হবে।
- মডেলটি একটি পূর্ব-প্রশিক্ষিত MoE LLM।
- সমান নিয়মের বদলে স্তরভিত্তিক ভিন্নতা বিবেচনা করা প্রয়োজন।
- MoE ইনফারেন্সের দক্ষতা বাড়াতে হবে।
উপসংহার: বিশেষজ্ঞদের ভিন্নধর্মী বণ্টন MoE-এর দক্ষতা বৃদ্ধির একটি মৌলিক এবং ব্যবহারিক অক্ষ হয়ে ওঠে।


