
প্রতিটি পৃষ্ঠার জন্য সাধারণ স্কেচের বদলে স্পেকট্রাল সারসংক্ষেপ: LOCKS এবং কী না পড়েই ব্লক নির্বাচন
LOCKS পদ্ধতিটি প্রতিটি কনটেক্সট পেজের জন্য কী-গুলোর একটি পৃথক নিম্ন-র্যাঙ্ক উপস্থাপনা সংরক্ষণ করে, তাই ব্লকগুলোর গুরুত্ব মূল্যায়ন কেবল এই সারসংক্ষেপের উপর নির্ভর করে, আর প্রার্থী কী-গুলো নিজে পড়া হয় না। দীর্ঘ কাজে এই সমাধানটি সম্পূর্ণ ক্যাশের কাছাকাছি গুণমান ধরে রাখে, যখন প্রায় 2% টোকেন অ্যাক্সেস করা হয় এবং ডিকোডিং লেটেন্সি লক্ষণীয়ভাবে কমে।
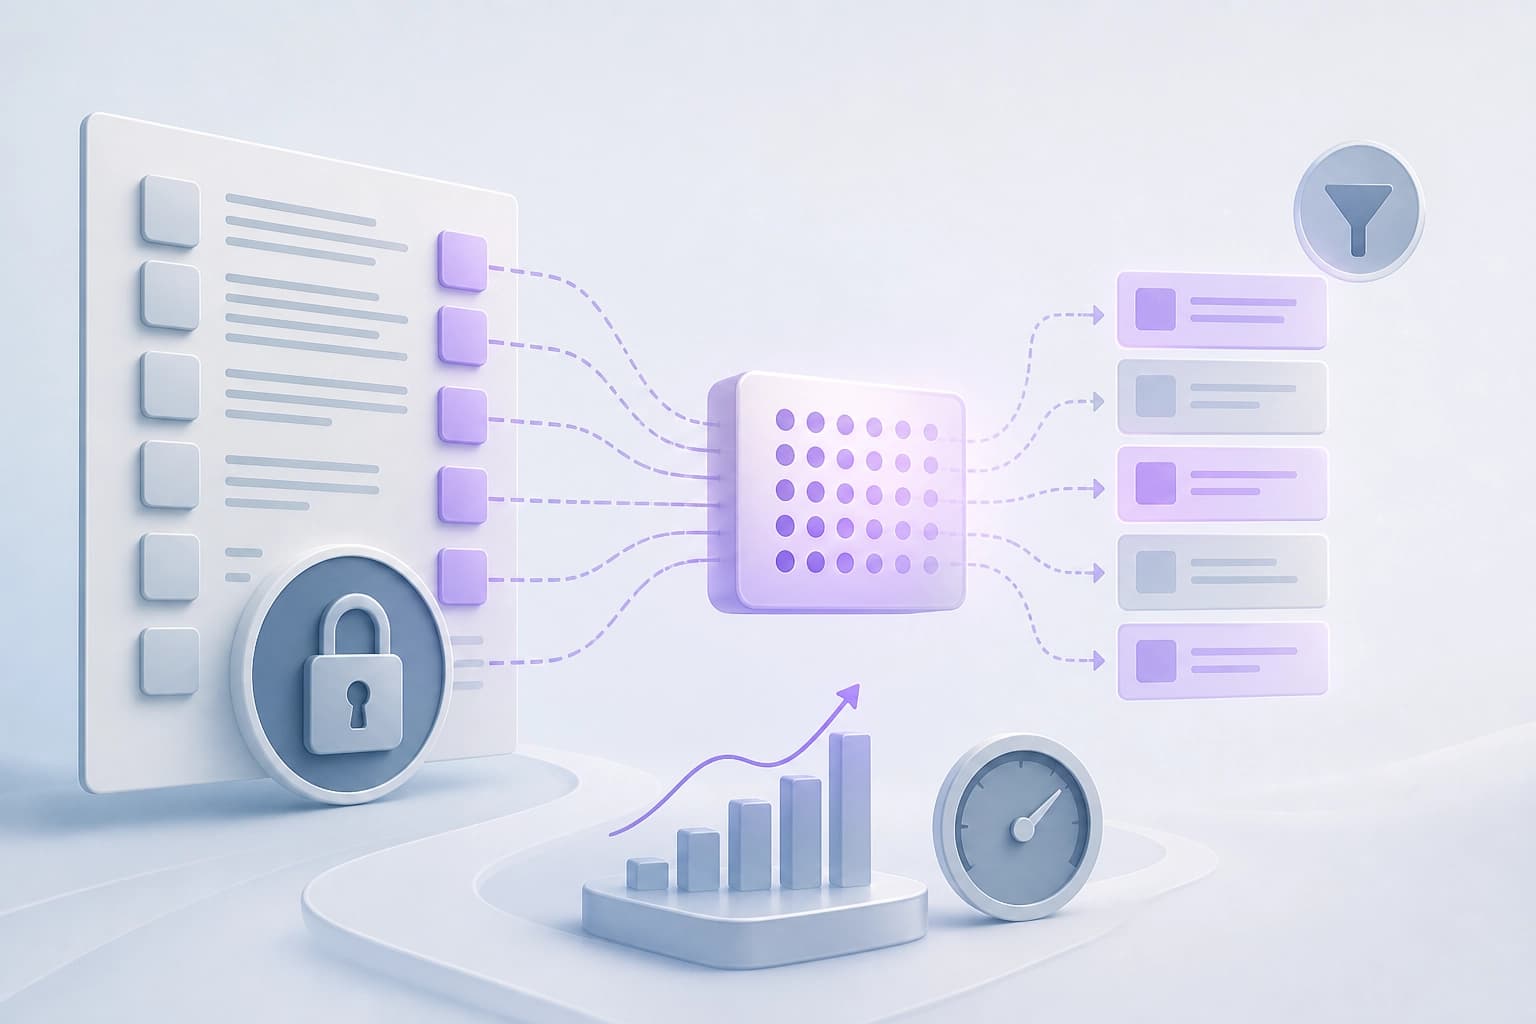
পৃষ্ঠাগুলোর জন্য সাধারণ স্কেচ কেন কাজ করে না
দীর্ঘ কনটেক্সটে বড় ভাষা মডেল চালানোর মূল বাধা key-value (KV) cache। প্রতিটি ডিকোডিং ধাপে পুরো ক্যাশ পড়া হয়। Attention keys locally low-rank, যদিও globally high-rank। পৃষ্ঠাজুড়ে অভিন্ন একটি নির্দিষ্ট low-rank sketch পৃষ্ঠার দিকগুলোর প্রতি প্রমাণসিদ্ধভাবে অন্ধ।
একই summary আকারে পৃষ্ঠার নিজস্ব ভিত্তি পৃষ্ঠাগুলোকে র্যাংক করে এবং বাহকগুলোকে অনেক ভালোভাবে সংরক্ষণ করে। সাধারণ স্কেচ এই দিকগুলো দেখতে পায় না। প্রতি-কী স্পেকট্রাল summary সমস্যাটি সমাধান করে।
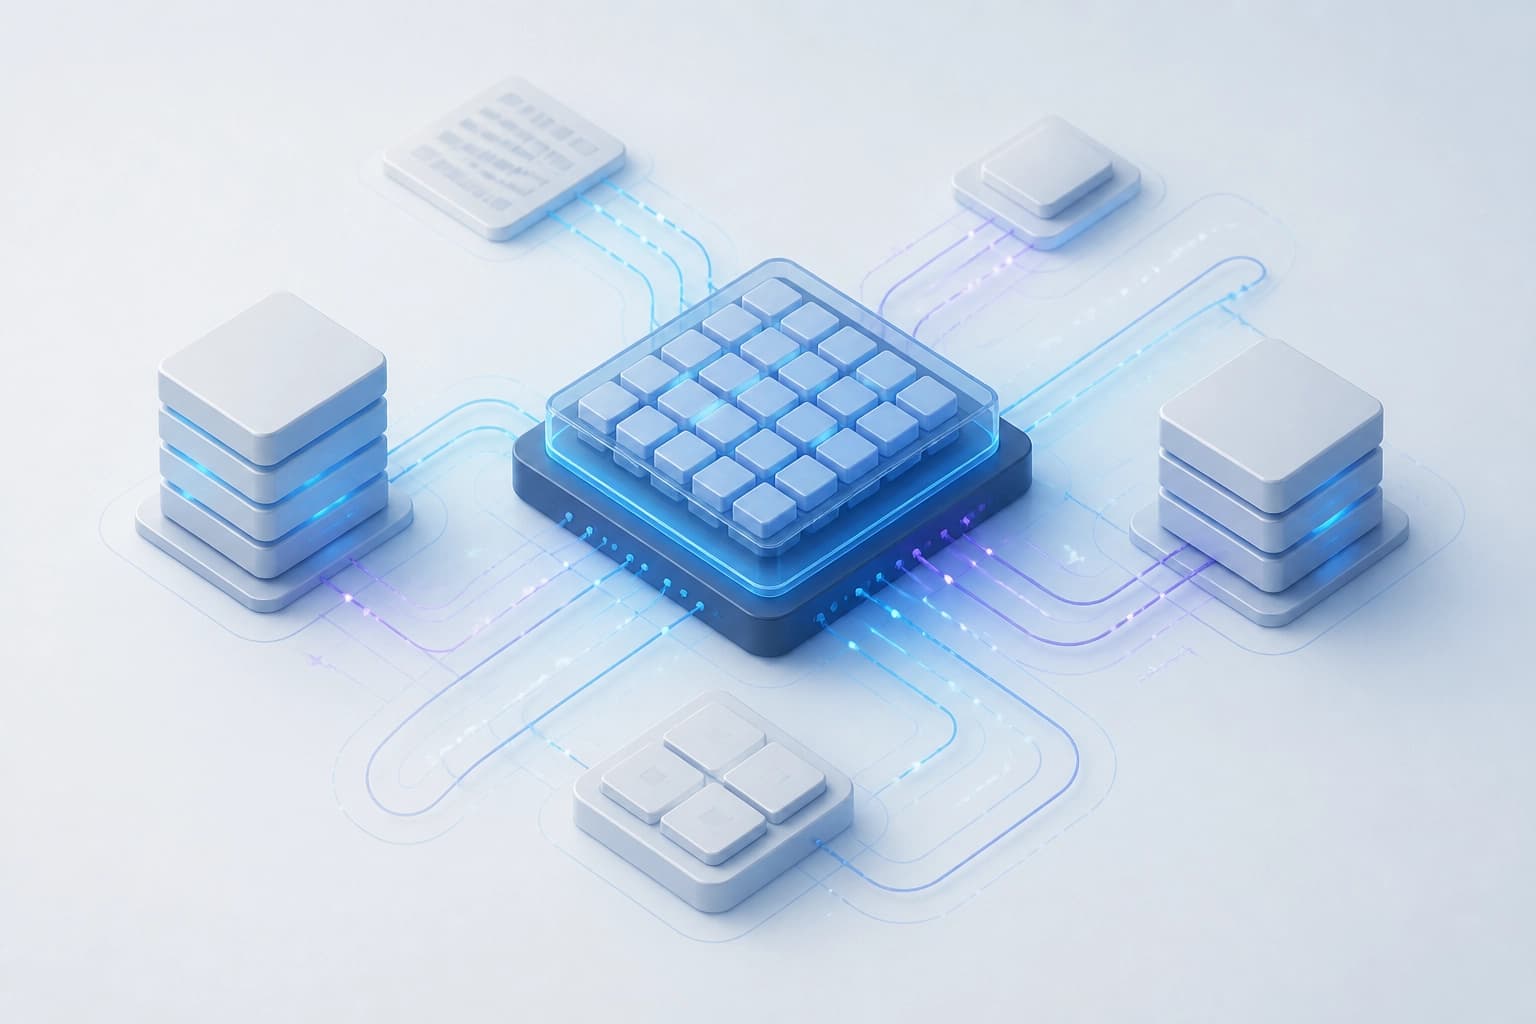
প্রতি পৃষ্ঠায় স্পেকট্রাল সারসংক্ষেপ
LOCKS প্রতিটি পৃষ্ঠাকে নিজস্ব rank-r spectral summary দেয়। সারসংক্ষেপটি রেসিডেন্ট: r=8-এ ক্যাশের এক দশমাংশ এবং r=2-এ এক পঁচিশতমাংশ। পদ্ধতিটি পৃষ্ঠার ভেতরের লজিট পুনর্গঠন করে। এটি log-sum-exp-এর মাধ্যমে প্রতিটি পৃষ্ঠার attention ভর অনুমান করে। তারপর শুধু উপরের পৃষ্ঠাগুলো প্রক্রিয়া করে।
মূল উপাদান:
- নাম: Page-Local Compact Key Summaries for Efficient Long-Context Decoding।
- সারসংক্ষেপ: প্রতিটি পৃষ্ঠার জন্য rank-r spectral summary।
- রেসিডেন্সি: r=8-এ ক্যাশের এক দশমাংশ, r=2-এ এক পঁচিশতমাংশ।
- পুনর্গঠন: পৃষ্ঠার ভেতরের লজিট।
- অনুমান: log-sum-exp-এর মাধ্যমে পৃষ্ঠার attention ভর।
- নির্বাচন: শুধু উপরের পৃষ্ঠাগুলো।
সিদ্ধান্ত: সারসংক্ষেপ ক্যাশের একটি অংশ নেয়, কিন্তু পৃষ্ঠার বৈশিষ্ট্য সংরক্ষণ করে। পৃষ্ঠা নির্বাচন স্পেকট্রাল ডেটার ভিত্তিতে হয়।
কী না পড়ে ব্লক নির্বাচন
নির্বাচন নিজে প্রার্থীদের কী বা ভ্যালু পড়ে না। বাছাই শুধু স্পেকট্রাল সারসংক্ষেপের ভিত্তিতে হয়। প্রতিটি ধাপে সারসংক্ষেপ সম্পূর্ণ স্ক্যান করা হয়। উল্লিখিত র্যাংক পরিসরে প্রতি ধাপে KV পড়া ১০–২৫ গুণ কমে।
প্রতি টোকেনে ডিকোডিং লেটেন্সি অর্ধেক হয়ে যায়। একটি H200 NVL-এ 1M টোকেনে r=8-এ গতি বৃদ্ধি 2.0×। এটি ঘন attention-এর সাথে তুলনা। নির্বাচন প্রার্থীদের কী পড়ার উপর নির্ভর করে না।
দীর্ঘ কাজে গুণমান
LOCKS কয়েক ধরনের কাজে গুণমান ধরে রাখে। long-document QA-তে (LongBench-v1; Llama-3.1-8B) ফলাফল পূর্ণ ক্যাশ থেকে এক পয়েন্টের মধ্যে থাকে। retrieval-dense RULER-এ পদ্ধতিটি প্রতিটি কী পড়া সঠিক LSE-ওরাকল অনুসরণ করে, এমনকি সবচেয়ে ছোট বাজেট পর্যন্ত। long-form reasoning-এ (AIME26, MATH-500; Qwen3-4B) ছোট বাজেট মোডে গুণমান সবচেয়ে বেশি ধরে রাখে। সেখানে eviction-ভিত্তিক reasoning সিলেক্টর ও কম্প্রেসর পিছিয়ে পড়ে।
2048 টোকেন বাজেটে LOCKS 100K+ কনটেক্সটে (GLM-4-9B-Chat-1M) FullKV-এর সমষ্টিগত গুণমানের সাথে মেলে। একইসাথে পদ্ধতিটি ২% টোকেন প্রক্রিয়া করে।
| শর্ত | ফলাফল |
|---|---|
| Long-document QA (LongBench-v1; Llama-3.1-8B) | পূর্ণ ক্যাশ থেকে এক পয়েন্টের মধ্যে |
| Retrieval-dense RULER | ছোট বাজেট পর্যন্ত সঠিক LSE-ওরাকল অনুসরণ করে |
| Long-form reasoning (AIME26, MATH-500; Qwen3-4B) | ছোট বাজেটে গুণমান সবচেয়ে বেশি ধরে রাখে |
| 2048-টোকেন বাজেট, 100K+ কনটেক্সট (GLM-4-9B-Chat-1M) | FullKV-এর সাথে মেলে, ২% টোকেন প্রক্রিয়া করে |
সিদ্ধান্ত: উল্লিখিত কাজগুলোতে এই পদ্ধতি সিলেক্টর ও eviction-based কম্প্রেসরের চেয়ে বেশি সময় গুণমান ধরে রাখে।
স্থাপন ও নির্বাচনের মানদণ্ড
পদ্ধতিটি অপরিবর্তিত vLLM-এর জন্য drop-in প্লাগইন হিসেবে সরবরাহ করা হয়। ব্যাচ ডিকোডিং সম্পূর্ণ CUDA গ্রাফে কাজ করে। vLLM পরিবর্তনের প্রয়োজন নেই।
নির্বাচনের মানদণ্ড: দীর্ঘ কনটেক্সট, সীমিত টোকেন বাজেট, KV পড়া ও ডিকোডিং লেটেন্সি কমানোর প্রয়োজন। যদি কাজটির জন্য প্রার্থীদের কী না পড়ে ব্লক নির্বাচন প্রয়োজন হয়, তবে পদ্ধতিটি উপযুক্ত।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
RL সিমুলেটরের ব্যর্থতা নির্ণয়ে ক্যানোনিক্যাল বহুপদী ইনভেরিয়েন্ট: এগুলো আসলে কোথায় কাজে লাগে
এই কাজটি পরীক্ষা করে, প্রশিক্ষণযোগ্য গতিবিদ্যার মডেলগুলোতে পদার্থবিজ্ঞানের সূত্র অন্তর্ভুক্ত করা কতটা যুক্তিযুক্ত: ট্র্যাজেক্টরি থেকে আহরিত এবং গ্রোবনার ভিত্তির মাধ্যমে ক্যানোনিকাল রূপে আনা ইনভারিয়ান্টগুলো পূর্বাভাসে সামান্য উন্নতি আনে, তবে রোগনির্ণয়ে কার্যকর—এগুলো লঙ্ঘিত সীমাবদ্ধতাটি কোথায় ঘটেছে তা নির্দিষ্ট করতে এবং নির্দিষ্ট ভুল প্যারামিটার শনাক্ত করতে সাহায্য করে।
10 নভেম্বর 2026
AURA-Eval: কীভাবে যাচাই করবেন যে LLM এজেন্ট ঝুঁকি শনাক্ত করেছে এবং পরবর্তী পদক্ষেপ পরিবর্তন করেছে
এই ফ্রেমওয়ার্ক LLM এজেন্টদের আচরণকে চূড়ান্ত রায় দিয়ে নয়, বরং গুরুত্বপূর্ণ মুহূর্তে ঝুঁকির প্রতিক্রিয়া দিয়ে মূল্যায়ন করে: টুল কলের ধারা মাঝপথে থামিয়ে দেওয়া হয়, এরপর মডেলকে তার যুক্তি ও কাজ চালিয়ে যেতে হয়; আর LLM বিচারকদের একটি প্যানেল ঝুঁকি শনাক্তকরণ, পদক্ষেপের ধরন ও নিরাপত্তা বিশ্লেষণ করে। R-Judge-এর 157টি ট্র্যাজেক্টরি থেকে সংগৃহীত 1249টি কাজে, 20টি মডেলের নিরাপদ পথ না থাকলে অনিরাপদ পদক্ষেপ নেওয়ার প্রবণতা বেড়ে যায়; আর কাজ সম্পন্ন হওয়ার আগে তদারকি তুলে নিলে শুরুতে নিরাপদ থাকা ঘটনাগুলোর 52,3% অনিরাপদ হয়ে ওঠে।
10 নভেম্বর 2026
চের্ন–সাইমনস রিজার্ভারের স্মৃতি: সংযোগের স্বায়ত্তশাসিত গতিবিদ্যা এবং ঘনত্ব পরিবহন
এই নিবন্ধে আলোচনা করা হয়েছে, কীভাবে একটি রিজার্ভয়ার ইনপুট সিগন্যালের ইতিহাস একই সঙ্গে ঘনত্বের বণ্টন এবং জ্যামিতিক স্বাধীনতার মাত্রায় সংরক্ষণ করে। চারটি প্রক্রিয়ার তুলনা দেখায় যে কারেন্ট একটি স্বতন্ত্র সংযুক্তি উপাদান তৈরি করে, যা ঘনত্বের পরবর্তী প্রতিক্রিয়া পরিবর্তন করে; আর পরিমাপ করা সব বৈশিষ্ট্য বিবেচনায় নিলে ইমপালসের ক্রম ডিকোড করার ক্ষেত্রে সামান্য উন্নতি হয়।
10 নভেম্বর 2026