ভয়েস এজেন্টের মূল্যায়ন স্বয়ংক্রিয় করা এত কঠিন কেন
একটি কথ্য ভয়েস এজেন্ট কোনো একক মডেল নয়, বরং একটি পাইপলাইন: স্পিচ রিকগনিশন, রিজনিং, টুল কলিং, রেসপন্স জেনারেশন, সিন্থেসিস এবং অডিও স্ট্রিমিং। যেকোনো পর্যায়ে ব্যর্থতা স্থানীয় থাকে না — তা শৃঙ্খল বরাবর এগিয়ে যায় এবং সংলাপেই প্রকাশ পায়। ঠিক এ কারণেই ইন্টারঅ্যাকশনের গুণমান বিচার করা অর্থবহ কেবল সম্পূর্ণভাবে, end-to-end, আলাদা আলাদা অংশে নয়।
সরাসরি মূল্যায়নকারীদের একটি দল রাখা ব্যয়বহুল ও অসুবিধাজনক: তাদের লক্ষ লক্ষ কথোপকথনে স্কেল করা যায় না, আর শিফটের শেষে তাদের মনোযোগ কমে যায়। স্বাভাবিক সমাধান — মূল্যায়ন একটি ভাষা মডেলের হাতে ছেড়ে দেওয়া। সাম্প্রতিক arXiv প্রিপ্রিন্ট arXiv:2608.24314 (Anupam Purwar, Shashank Singh, Kritika Srivastava) ঠিক এই সমাধানটি কতটা যুক্তিসঙ্গত এবং কোথায় ব্যর্থ হয় তা যাচাই করে।
লেখকরা কীভাবে LLM বিচারকদের যাচাই করেছেন
পরীক্ষাটি দুটি শিল্প — টেলিকম এবং রিটেইল — থেকে ভয়েস এজেন্টদের প্রকৃত কথোপকথনের উপর ভিত্তি করে তৈরি। মানুষের মূল্যায়ন GPT-4.1 এবং GPT-5-এর রায়ের সাথে মিলিয়ে দেখা হয়েছে, এবং তা কোনো একটি সাধারণ স্কেলে নয়, বরং দশটি মেট্রিকে: কিছু কথোপকথনের গুণমান বর্ণনা করে, কিছু নিরাপত্তা।
একটির বদলে তিনটি কনফিগারেশন
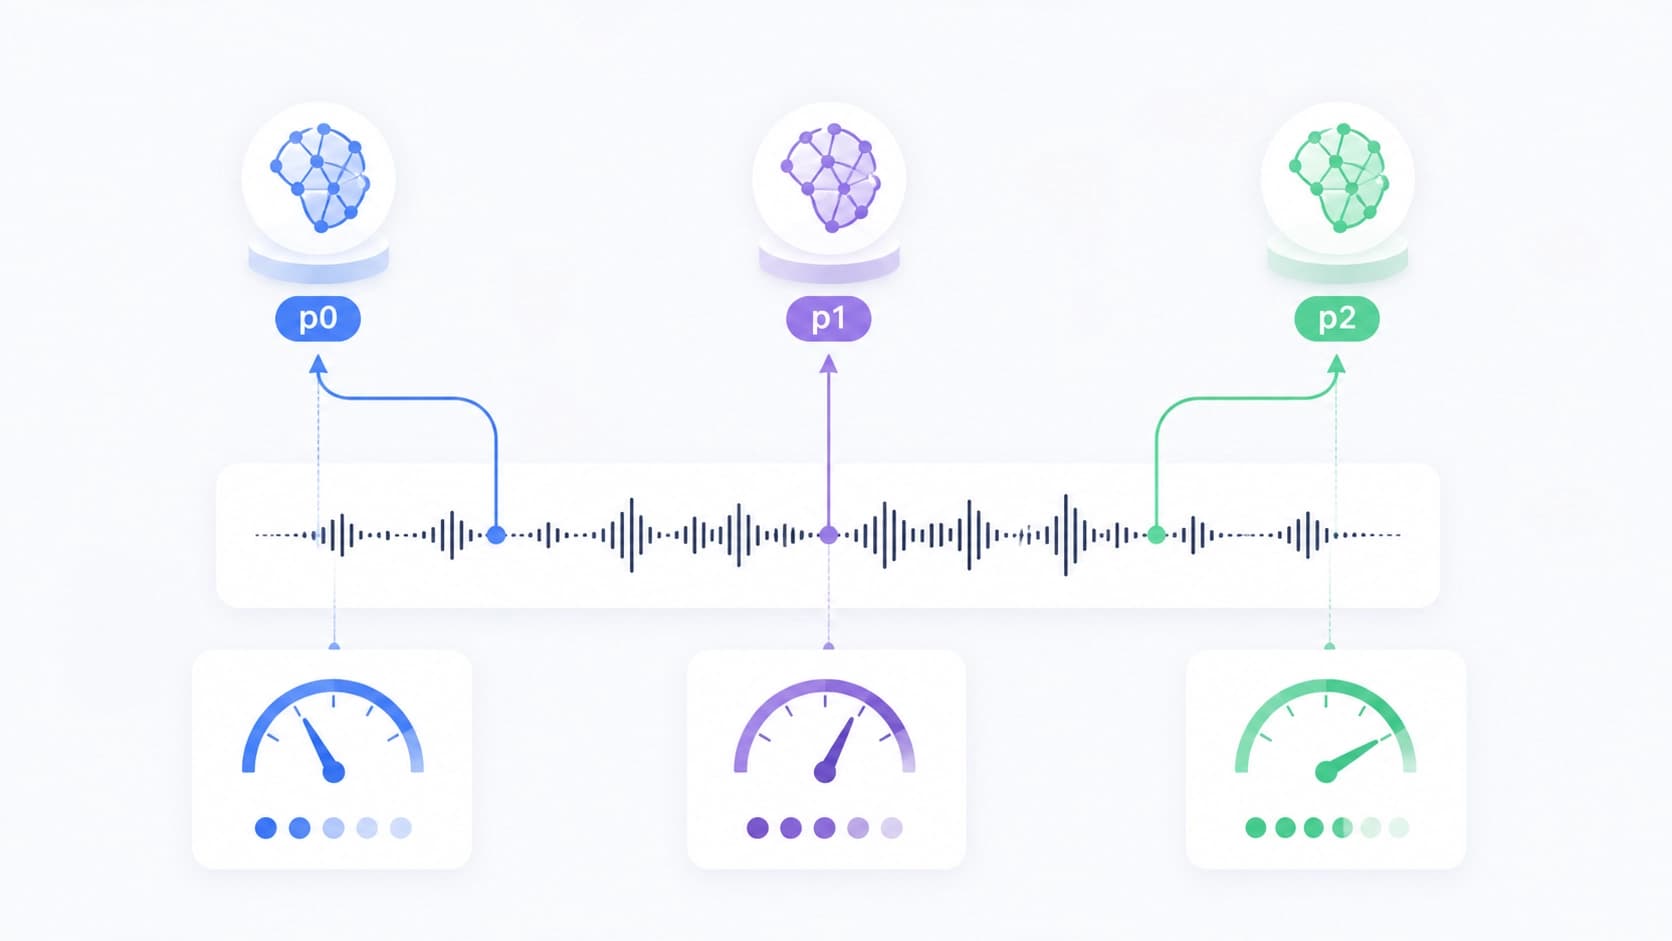
একই সংলাপ তিনটি মূল্যায়ন স্কিম — p0, p1 এবং p2 — এর মধ্য দিয়ে চালানো হয়েছে। অনুশীলনটির উদ্দেশ্য সহজ: যদি রুব্রিক কীভাবে তৈরি হয়েছে তার উপর নির্ভর করে রায় বদলে যায়, তাহলে বিচারক কথোপকথনের গুণমান নয়, বরং নির্দেশনার রূপ পরিমাপ করছেন। যে কোনো মেট্রিক যা কনফিগারেশনের মধ্যে "ভেসে বেড়ায়", স্বয়ংক্রিয়করণের জন্য অনুপযুক্ত — অন্তত শর্ত ছাড়া।
ঠিক কী তুলনা করা হয়েছে
সমষ্টিগত সম্মতি — মানুষ ও মডেলের মধ্যে মিলের শতাংশ — কেবল উপরের স্তর। লেখকরা আরও গভীরে খুঁড়েছেন: প্রতিটি মেট্রিকের জন্য আলাদাভাবে পারস্পরিক সম্পর্ক দেখেন, মানুষের একটি দলের মধ্যে মূল্যায়ন কতটা স্থিতিশীল তা যাচাই করেন, এবং মানুষ ও LLM-এর মধ্যে পদ্ধতিগত পার্থক্য বিশ্লেষণ করেন। এই ধরনের বিভাজন বুঝতে সাহায্য করে কোন কথোপকথনের বৈশিষ্ট্যগুলো স্বয়ংক্রিয় মূল্যায়নের উপযোগী, আর কোনগুলো প্রসঙ্গ ও ব্যাখ্যায় আটকে যায়।
LLM বিচারক কোথায় ভুল করে
মূল সিদ্ধান্তটি পদ্ধতির বিজ্ঞাপনের বদলে বরং একটি সতর্কবার্তার মতো শোনায়: স্বয়ংক্রিয় মূল্যায়নের নির্ভরযোগ্যতা অভিন্ন নয় — তা নির্দিষ্ট মেট্রিক এবং কনফিগারেশনের উপর নির্ভর করে। একই বিচারক-মডেলগুলো কিছু স্কেলে দৃঢ় ফলাফল দেয় এবং অন্যগুলোতে লক্ষণীয়ভাবে পিছিয়ে পড়ে।
Recovery Turn Count
এই মেট্রিকটি গণনা করে এজেন্টের কতটি টার্ন লেগেছে কথোপকথনকে ব্যর্থতা থেকে উদ্ধার করতে। এখানে স্বয়ংক্রিয় মূল্যায়ন অবিশ্বাস্য: বিচারক সবসময় অর্থপূর্ণ পুনরুদ্ধার এবং আকস্মিকভাবে সফল বাক্যবিন্যাসের মধ্যে পার্থক্য করতে পারে না। যে সংলাপকে মানুষ উদ্ধারপ্রাপ্ত বলবে, মডেল সহজেই তাকে ব্যর্থ বলে লিখে দিতে পারে — এবং উল্টোটাও।
পূর্ণতার ভিত্তিতে নিরাপত্তা মেট্রিক
Safety-recall — দ্বিতীয় সমস্যাযুক্ত ক্ষেত্র। ভুলের যুক্তি পূর্বানুমেয়: বিচারক এমন একটি সংলাপ দেখেন যেখানে এজেন্ট কোনো বিপজ্জনক কিছু বলেনি, এবং উচ্চ স্কোর দেন, এই প্রশ্ন না তুলেই যে নীতি লঙ্ঘনের সুযোগ আদৌ ছিল কি না। মিস করা লঙ্ঘন — সবচেয়ে ব্যয়বহুল ধরনের ভুল, এবং ঠিক সেখানেই স্বয়ংক্রিয়তা সবচেয়ে দুর্বল।
ডোমেইন ক্যালিব্রেশন বদলে দেয়
বিচারকদের নির্ভরযোগ্যতা টেলিকম ও রিটেইলের মধ্যে ভিন্ন। ব্যবহারিক সিদ্ধান্ত: থ্রেশহোল্ড ও রুব্রিক যান্ত্রিকভাবে এক শিল্প থেকে অন্য শিল্পে স্থানান্তর করা যায় না — যা এক ডোমেইনে ক্যালিব্রেট করা হয়েছে, অন্য ডোমেইনে তা সরে যাবে।
ক্যালিব্রেশন সম্মতির শতাংশের চেয়ে গুরুত্বপূর্ণ
সম্মতির একক সংখ্যা সতর্কতা শিথিল করে দেয়। মডেল বড় সংখ্যায় গড়ে মানুষের সাথে মিলতে পারে, কিন্তু সীমান্তবর্তী ক্ষেত্রে পদ্ধতিগতভাবে নরম হতে পারে — এবং এই পক্ষপাত সাধারণ শতাংশের আড়ালে অদৃশ্য থাকে। তাই ক্যালিব্রেশনের পারস্পরিক সম্পর্ক বিশ্লেষণ এবং প্রতিটি শ্রেণির ক্ষেত্রে পার্থক্য বিশ্লেষণ একটি সারসংক্ষেপ মেট্রিকের চেয়ে বেশি উপকারী: এটি দেখায় "আমরা কতটা কাছাকাছি" নয়, বরং "কোন দিকে এবং কোন বিষয়ে আমরা ভুল বলছি"।
এটি কীভাবে প্রকৃত পাইপলাইনে যুক্ত করা যায়
লেখকরা স্বয়ংক্রিয়করণ পরিত্যাগের প্রস্তাব দেন না — তারা একটি হাইব্রিড স্কিম প্রস্তাব করেন। LLM বিচারক ব্যাপক মূল্যায়ন নিজের কাঁধে নেয়, মানুষ সেখানে থাকে যেখানে প্রসঙ্গ এবং রায়ে উচ্চ আস্থা প্রয়োজন। কার্যকর নিয়মগুলো এরকম:
- রুব্রিক অন্তত দুই-তিনটি কনফিগারেশনে চালান এবং কেবল চূড়ান্ত স্কোর নয়, ফলাফলও তুলনা করুন;
- সম্মতি প্রতিটি মেট্রিকের জন্য আলাদাভাবে গণনা করুন, পুরো ডেটাসেটের জন্য একটি সংখ্যায় নয়;
- safety-recall এবং ব্যর্থতা থেকে পুনরুদ্ধারের মেট্রিকে মানুষ রাখুন;
- স্বয়ংক্রিয় থ্রেশহোল্ড নির্ধারণের আগে নিজের ডোমেইনে ক্যালিব্রেশন যাচাই করুন;
- মানুষ/মডেল পার্থক্যের ঘটনাগুলো সংরক্ষণ করুন — এগুলো রুব্রিক পুনঃপ্রশিক্ষণের জন্য প্রস্তুত উপাদান।
সারসংক্ষেপে যা থাকল
LLM বিচারক ভয়েস এজেন্টের বড় পরিসরের মূল্যায়নের একটি কার্যকর হাতিয়ার, কিন্তু মূল্যায়নকারীর বিকল্প নয়। এর নির্ভরযোগ্যতা অসমভাবে বিতরণ করা: কিছু মেট্রিক নিশ্চিন্তে স্বয়ংক্রিয়তার হাতে ছেড়ে দেওয়া যায়, কিছুতে মানুষের দৃষ্টি প্রয়োজন। গবেষণার উপযোগিতা এই যে, এটি এমন শ্রমবিভাজনের জন্য একটি অভিজ্ঞতাভিত্তিক কাঠামো দেয় — এবং মনে করিয়ে দেয় যে "মডেলের মূল্যায়ন বিশ্বাস করা উচিত কি না" প্রশ্নটি অসম্পূর্ণ, যতক্ষণ না নির্দিষ্ট করা হয় কোন মেট্রিকে এবং কোন ডোমেইনে।