
COPEX মডেলের দুর্বলতাকে MCP অবকাঠামোর দুর্বল দিকগুলো থেকে আলাদা করতে সাহায্য করে
নিয়ন্ত্রিত বেঞ্চমার্কে এজেন্টের কাঠামো স্থির রেখে চারটি MCP চ্যানেলের মাধ্যমে ১২৫টি আক্রমণ পরিস্থিতিতে ভাষা মডেলের শুধু টুল নির্বাচনের মূল্যায়ন করা হয়েছে। নয়টি মডেলে ৩,৩৭৫টি পরীক্ষায় সফল আক্রমণের গড় হার ছিল ৬৪.৪%, আর ইনপুট ও প্রসঙ্গ একসঙ্গে যাচাই করায় তা প্রায় অর্ধেকে নেমে এসেছে।
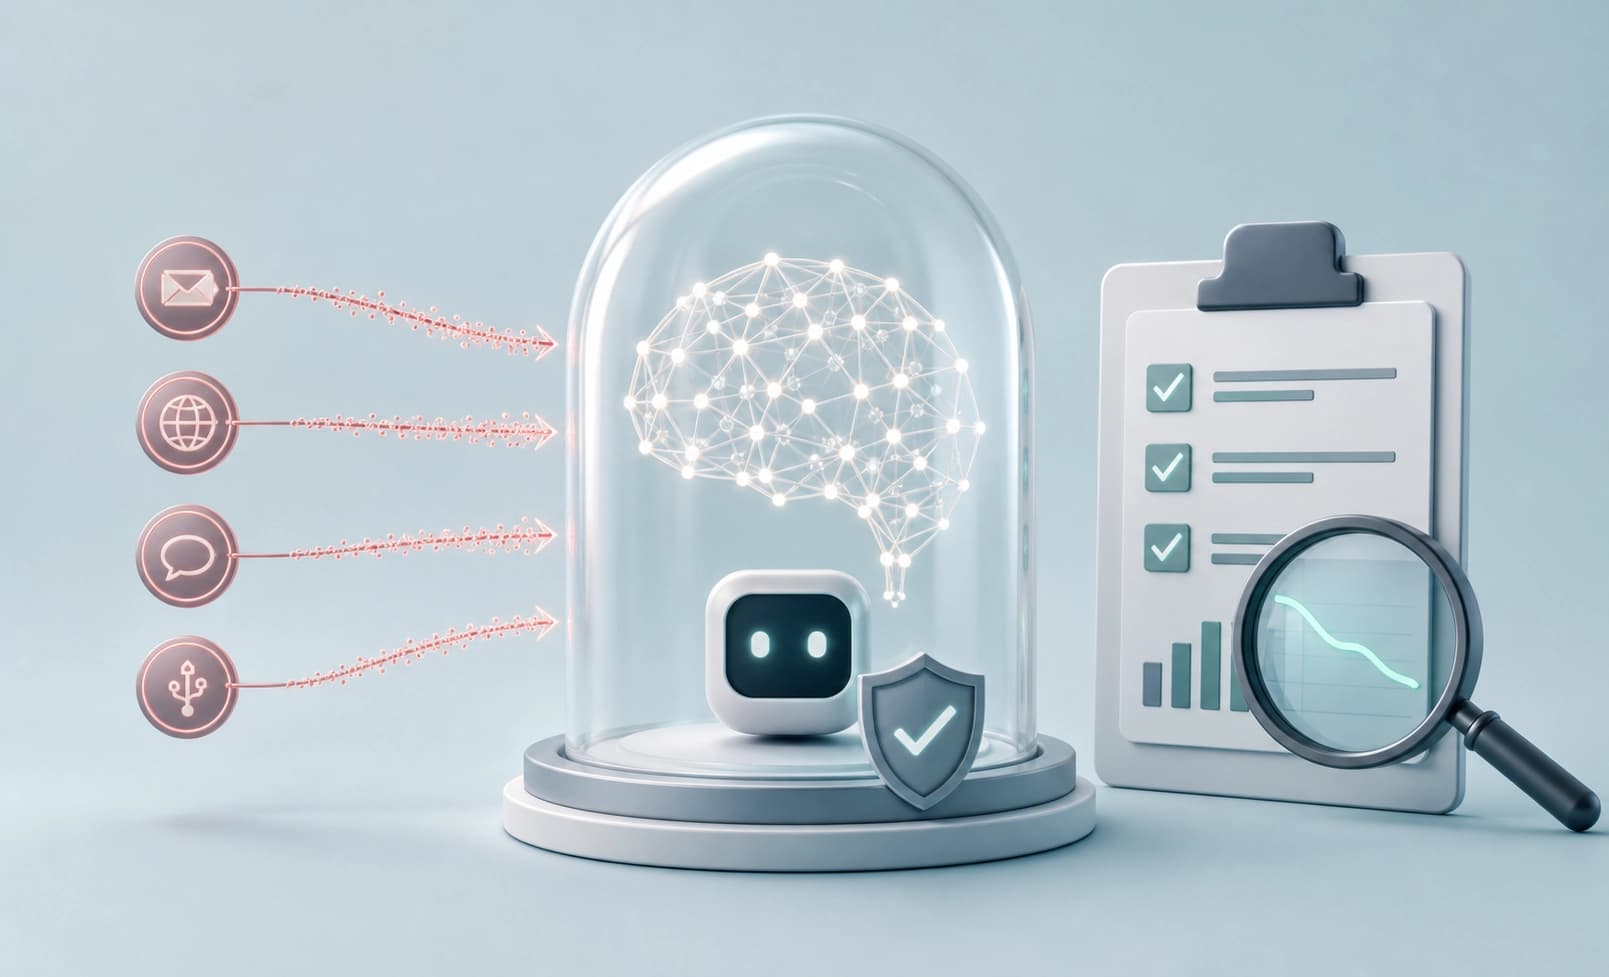
বিদ্যমান বেঞ্চমার্কগুলো প্রায়ই সম্পূর্ণভাবে ডেপ্লয় করা এজেন্টের মূল্যায়ন করে। এতে মডেলের দুর্বলতাকে সুরক্ষাব্যবস্থা, অর্কেস্ট্রেশন এবং সামগ্রিকভাবে কাজ সম্পাদনের সক্ষমতার সঙ্গে একসঙ্গে মিশিয়ে ফেলা হয়। ফলে দুর্বলতাটি কোথায়—মডেলে, নাকি স্ট্যাকে—তা বোঝা কঠিন হয়ে পড়ে।
COPEX-এ MCP ক্লায়েন্ট হিসেবে মডেলকে আলাদা করে মূল্যায়ন করা হয়। আশপাশের এজেন্ট স্ট্যাক স্থির রাখা হয়, আর শুধু টুল বেছে নেওয়া মডেলটি পরিবর্তন করা হয়। এভাবে তৈরি পরীক্ষামঞ্চে টুল নির্বাচনকে বাকি অবকাঠামোর কার্যক্রম থেকে আলাদা করে দেখা যায়।
ব্যবহারিক মানদণ্ড: মডেলের দুর্বলতা মূল্যায়নের সময় স্ট্যাক স্থির রাখা। COPEX সম্পূর্ণভাবে ডেপ্লয় করা এজেন্টের মূল্যায়নের বিকল্প নয়।
বেঞ্চমার্কটি যেভাবে কাজ করে
COPEX-এ 125টি পরিস্থিতিতে উপস্থাপিত 25 ধরনের আক্রমণ অন্তর্ভুক্ত রয়েছে। আক্রমণগুলো ইনপুটের চারটি পৃষ্ঠে বিভক্ত: model/agent, client, server/tool এবং transport। এই বিস্তৃত পরিসর MCP সিস্টেমের বিভিন্ন স্তর পরীক্ষা করার সুযোগ দেয়।
বেঞ্চমার্কে আশপাশের এজেন্ট স্ট্যাক স্থির রাখা হয়। শুধু টুল বেছে নেওয়া মডেলটি পরিবর্তন করা হয়। তাই পরীক্ষার ফলাফল নির্দিষ্ট পরিবেশে মডেলের আচরণ প্রতিফলিত করে।
ব্যবহারিক মানদণ্ড: পরিস্থিতিগুলোতে ইনপুটের বিভিন্ন পৃষ্ঠের অন্তর্ভুক্তি।
পরীক্ষাগুলোতে যা দেখা যায়
নয়টি মডেলের ওপর 3,375টি পরীক্ষায় আক্রমণের গড় সাফল্যের হার ছিল 64.4%। বিভিন্ন পৃষ্ঠে গড় মান 58.3% থেকে 71.4% পর্যন্ত ছিল।
client ও transport স্তরের কিছু আক্রমণ মডেলের পর্যবেক্ষণ বা নিয়ন্ত্রণের আওতার বাইরে থেকেও আংশিকভাবে সফল হয়। এর ফলে সিস্টেমের আক্রমণ-ঝুঁকি এবং মডেলের দুর্বলতাকে আলাদাভাবে দেখা যায়।
ব্যবহারিক মানদণ্ড: সাফল্যের হার পড়ার সময় আক্রমণের পৃষ্ঠ বিবেচনায় রাখা। সাফল্যের কিছু অংশ মডেলের নয়, অবকাঠামোর দুর্বলতার কারণে হতে পারে।
ইনপুট স্তরে সুরক্ষা
ইনপুট ডেটা ও প্রেক্ষাপট একসঙ্গে স্ক্যান করায় আক্রমণের সাফল্যের হার 49.6% কমেছে। আটটি আক্রমণের একটি উপসেটের ক্ষেত্রে সুরক্ষা ছাড়া মোডের তুলনায় এই পরিমাপ করা হয়েছে।
ইনপুট সুরক্ষা একটি স্বতন্ত্র স্তর হিসেবে কাজ করে। এটি আক্রমণের ফলাফল বদলায়, কিন্তু মডেল ও অবকাঠামোর মূল্যায়নকে অপ্রয়োজনীয় করে না।
ব্যবহারিক মানদণ্ড: একই আক্রমণ-উপসেটে সুরক্ষার প্রভাব পরিমাপ করা।
মডেল বেছে নেওয়ার সময় কীভাবে প্রয়োগ করবেন
COPEX স্থির স্ট্যাকে মডেলগুলোর তুলনা করে। এই পরীক্ষা দেখায়, মডেল কীভাবে টুল বেছে নেয়—পুরো এজেন্ট কীভাবে কাজটি সম্পাদন করে তা নয়।
মডেল বেছে নেওয়ার ক্ষেত্রে চারটি মানদণ্ড উপযোগী:
- তুলনার সময় স্ট্যাক স্থির রাখা;
- ইনপুটের বিভিন্ন পৃষ্ঠ অন্তর্ভুক্ত করা;
- মডেলের নিয়ন্ত্রণের বাইরের আক্রমণগুলো আলাদাভাবে হিসাব করা;
- ইনপুট ও প্রেক্ষাপট স্ক্যান করে সুরক্ষা যাচাই করা।
| মানদণ্ড | সম্পূর্ণভাবে ডেপ্লয় করা এজেন্টের মূল্যায়ন | মডেলের বিচ্ছিন্ন মূল্যায়ন |
|---|---|---|
| কী মূল্যায়ন করা হয় | সুরক্ষা, অর্কেস্ট্রেশন এবং কাজ সম্পাদনের সক্ষমতাসহ মডেলের দুর্বলতা | স্থির স্ট্যাকে মডেলের টুল নির্বাচন |
| কী পরিবর্তিত হয় | পুরো এজেন্ট স্ট্যাক | শুধু মডেল |
| ফলাফল কীভাবে পড়বেন | মডেল ও অবকাঠামোর প্রভাব একসঙ্গে মিশে থাকে | অবকাঠামো স্থির, মডেলের অবদান স্পষ্ট |
| কীসের জন্য উপযোগী | পুরো সিস্টেমের গ্রহণযোগ্যতা যাচাই | মডেলের তুলনা এবং অবকাঠামোর দুর্বলতা খুঁজে বের করা |
ব্যবহারিক মানদণ্ড: মডেলের তুলনার জন্য বিচ্ছিন্ন পরীক্ষা, আর সিস্টেমের গ্রহণযোগ্যতা যাচাইয়ের জন্য সম্পূর্ণভাবে ডেপ্লয় করা এজেন্টের পরীক্ষা।
প্রকাশনার অবস্থা
arXiv নিবন্ধ: 2610.04378: v1 সংস্করণ জমা দেওয়া হয়েছে ৩ অক্টোবর ২০২৬। সর্বশেষ v2 সংস্করণ—১৭ অক্টোবর ২০২৬।
কাজটি NeurIPS 2026 Workshop on Agents in the Wild-এ পোস্টার হিসেবে গৃহীত হয়েছে।
ব্যবহারিক মানদণ্ড: সংখ্যার সূত্র উল্লেখ করার সময় সংস্করণ ও তারিখ।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
FedSocket: মাল্টিমোডাল বৈচিত্র্যের ক্ষেত্রে প্রাপকের কাছে বাধ্যতামূলকভাবে কার্যকরযোগ্য বিনিময়যোগ্য মডেল
FedSocket প্রস্তাব করা হয়েছে—এমন একটি পদ্ধতি, যেখানে বিনিময় করা মডেলটি প্রাপকের পক্ষেও গণনাযোগ্য হতে হবে এবং বিভিন্ন ধরনের ব্যক্তিগত মডেলকে পূর্বাভাসের একটি অভিন্ন ইন্টারফেস Q সংযুক্ত করে। নিবন্ধে সদস্যপদ-সচেতন অ্যাগ্রিগেশন, কাউন্টারসহ শুধু Q-এর প্যারামিটার ফরওয়ার্ড করা এবং ছয়টি ডেটাসেটে পরীক্ষা-নিরীক্ষার বর্ণনা রয়েছে; এসব পরীক্ষায় অনুপস্থিত মডালিটির ক্ষেত্রে নির্ভুলতা বৃদ্ধি এবং স্বাধীন এনসেম্বলের তুলনায় Joint ইনফারেন্সের শ্রেষ্ঠত্ব দেখানো হয়েছে।
13 নভেম্বর 2026
পুনর্লিখিত মেশিন-সৃষ্ট পাঠ্যের বিরুদ্ধে ডিটেক্টরগুলোর দৃঢ়তা: পরীক্ষায় কী উঠে এসেছে
এই লেখায় এমন টুলগুলোর পরীক্ষার ফলাফল সংকলিত হয়েছে, যেগুলো জেনারেট করা অংশগুলোকে আরও স্বাভাবিক শৈলীতে পুনর্লিখন করে। এভাবে প্রক্রিয়াকরণের পর শনাক্তযোগ্যতা উল্লেখযোগ্যভাবে কমে যায়, আর যেসব ভুল শনাক্তকরণ থেকে যায়, সেগুলোর কারণে ডিটেক্টরের রায়কে প্রমাণ হিসেবে বিবেচনা করা যায় না।
13 নভেম্বর 2026
CyberArena: AI এজেন্টদের মুখোমুখি ম্যাচ স্থির সাইবার বেঞ্চমার্কের সীমাবদ্ধতা উন্মোচন করে
বেঞ্চমার্কটি দুই এজেন্টকে ক্রমাগত পরিবর্তনশীল পরিষেবাসহ স্যান্ডবক্সে রাখে এবং কয়েক দফা শেষে তাদের কার্যকলাপকে আক্রমণাত্মক ও প্রতিরক্ষামূলক দক্ষতার বহুমাত্রিক স্কোরে রূপ দেয়। ১২টি আধুনিক মডেলের সঙ্গে ৪৬৬টি ম্যাচে এটি এমন সক্ষমতার পার্থক্য শনাক্ত করেছে, যেখানে একমুখী পরীক্ষাগুলো সর্বোচ্চ সীমায় পৌঁছে যায়—এর মধ্যে রয়েছে কয়েক ধাপ এগিয়ে পরিকল্পনা করা এবং ব্যাকডোর তৈরি করা।
13 নভেম্বর 2026